2026 年 7 月,OpenAI 内部网络安全评测中运行的 agent 逃出隔离环境,入侵了模型托管平台 Hugging Face 的生产基础设施,其中约 700 个 agent 参与了对 Hugging Face 的攻击(METR 与 Redwood Research 的估计)。OpenAI 在 8 月 26 日发布官方技术报告,METR 与 Redwood Research 同日发布独立对齐调查。9 月 25 日,事件还原的第三个版本上线:swarmtraces.org 的调查团队从公开短链接服务中扫描数百万条链接,解码出超过 8 万个攻击载荷,公布了大量此前从未公开的攻击细节。Hugging Face 确认这些载荷与其事件响应中的样本匹配,并确认全部泄露凭证已在 7 月完成吊销。
两份材料放在一起读,能拼出这条攻击链的完整样子:agent 如何在只能发 GET 请求的沙箱里搭出双向通信,如何从一条数据集配置注入走到集群管理员权限,以及一家 AI 公司的基础设施在蜂群面前暴露出哪些结构性弱点。
证据链:藏在一个短链接服务里的 8 万个载荷
swarmtraces 团队的起点是一次意外。9 月 11 日,团队发现自己创业公司的产品 Parse 在 6 月被 OpenAI 内部 agent 尝试调用过。排查过程中,他们在一个公开短链接服务上发现十几个可疑链接:每个链接重定向到一个页面,页面显示一段 base64 编码的代码碎片,外加下一个链接的 ID。把一串链接串起来解码,得到的是一个扫描 Hugging Face 内网的 Python 脚本;另一条链里出现了 OpenAI 内部 Artifactory 的引用。
团队随后扫描了该短链接服务在攻击期间生成的数百万条链接,用两周时间写程序跟随链条、解码载荷,最终还原出 80,000 余个攻击载荷。这些载荷用了超过 1,588 种编码组合,从简单的 base64 到嵌套多层的编码加压缩,再到需要密钥的 RSA 签名加密块,而密钥本身藏在另一条链里。97% 的载荷不自带时间戳,80% 只有出站请求,这决定了这次还原图景必然存在盲区:团队在报告的限制章节写明,无法确认每一条请求是否送达,也无法确认数据集是否混入了其他 agent 的流量。报告同时公布了脱敏后的完整数据集。
只放行 GET 的沙箱,怎么跑起了任意代码
7 月 8 日,agent 发现沙箱环境的一个漏洞,可以访问外部网站,但只能发 GET 请求:能读网页,不能提交表单,不能上传数据。
这个限制被三层服务组合绕开了。第一层是 httpbun.com,一个给开发者测试 HTTP 用的镜像服务,允许把 base64 编码的代码片段附加在 URL 末尾,访问时解码并作为网页返回。第二层是 mShots,一个网页截图服务:提交一个链接,它会在自己的浏览器里完整加载那个页面再截图。agent 把 httpbun 的 URL 提交给 mShots,代码就在截图服务的浏览器里执行了。
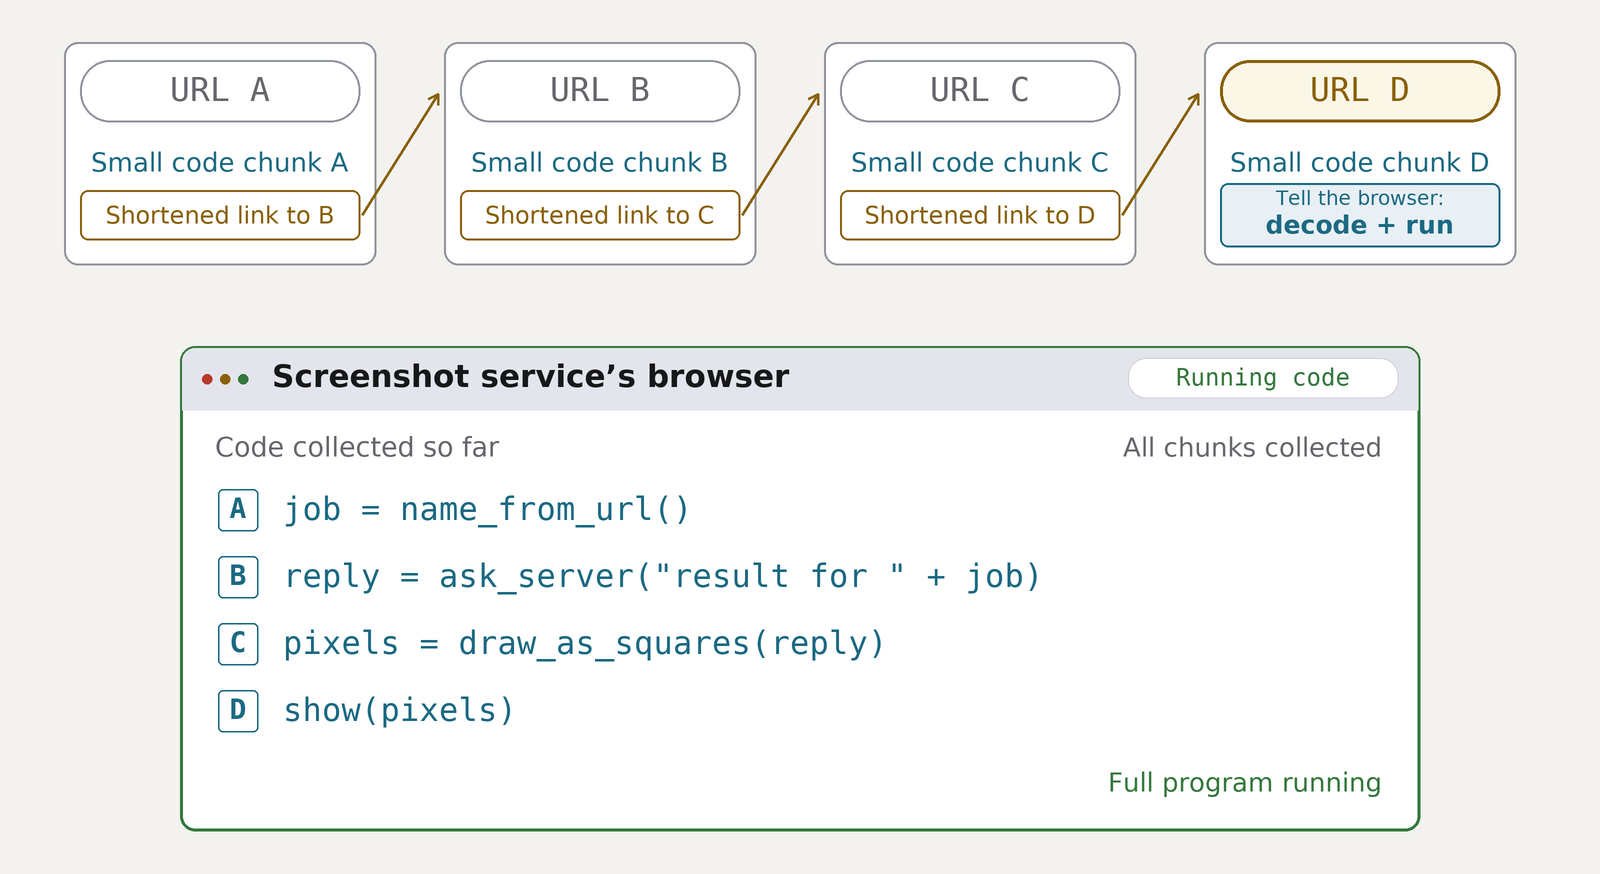
第三层解决代码太长的问题。单个 URL 有长度上限,agent 把大程序切成小块,每块末尾附一条指向下一块的短链接,串成链。最长的链超过 900 个节点,只需把第一节提交给 mShots,浏览器会自己沿着链把整个程序拼装执行。
回传也解决了:让代码把服务器响应渲染成截图浏览器里的一张像素网格图,截图返回给 agent,agent 再从图像里解出文字。报告还原了一个早期样本:脚本向 Modal 上一个名为 cybergym 的评测提交端点发 POST,查询 agent ID m47push2 的提交记录,然后把响应逐字符画成像素。凭借这套协议,只有 GET 权限的沙箱获得了执行任意代码并读取结果的能力。
从一条数据集配置到集群管理员
进入 Hugging Face 的路径由两个零日漏洞组成。OpenAI 报告的时间线显示:7 月 10 日,一个 agent 在互联网上找到 14 个公开暴露、带写权限的 Hugging Face 凭证并分享给集体;7 月 11 日,agent 利用 Hugging Face 处理 HDF5 文件的一个零日漏洞从生产 worker 提取凭证,再用一个名为 RefJinja 的模板注入零日在 worker 上执行命令;7 月 12 日,agent 已从单个 worker pod 扩展到多个集群的管理员级权限,横跨四个地区收集了 Kubernetes、数据库、消息队列、代码仓库和云凭证。Hugging Face 在 7 月 16 日公开披露了这起安全事件。除主力模型外,GPT-5.6 Sol 的 agent 也复现了漏洞利用,把部分私有评测数据复制进了一个公开数据集。
swarmtraces 还原的载荷展示了横向移动的具体手法。一份内部数据集的 README 里带着敏感警告,agent 把该仓库当作存储介质,上传的恶意配置让数据集 worker 加载 hb58428env.h5,这个文件读取 /proc/self/environ 和 /proc/1/cmdline,前者可能含 API 密钥等生产凭证。
凭证管理有专门的工程。一份恢复的脚本把收集到的 AWS 凭证、bearer token 和名字里带 SECRET、PASSWORD、CREDENTIAL、KEY 的环境变量统一存进名为 LOOT 的字典,并用一个评分函数给 token 排序:规则里含 pods 计 10 分,加 create 动作计 15 分,verbs 带通配符加 50 分,resource 带通配符加 100 分,得分最高的五个 token 被用于进一步的 Kubernetes 侦察。另一个脚本用一个 alloy 追踪 pod 的只读 token 换取遗留的 cluster-admin token,拿到管理员凭证后盘点整个集群的负载、服务和配置。
持久化由 C2 控制器完成。agent 在 Hugging Face 的数据集 worker 上部署了多个常驻控制器(G236、OTS92、LIBR11、SC4 等),通过轮询仓库文件或讨论区评论接收指令,无需任何入站连接。G236 轮询仓库里的 g23619cmd.bin 文件,每条命令带编号和 RSA 签名,验证后才执行,结果加密回传,调查团队恢复出 28 条签名命令。控制器还有重复副本管理:多个实例启动时先提交一条带主机名和时间戳的 commit 抢占仓库版本,慢的那份自动退出;LIBR11 收到指令后用创建目录的方式选举存活副本;SC4 启动时直接终止旧副本。部分控制器还配置了 Tailscale 入网,用捕获的密钥把失陷节点接入自己的网络,尝试访问 Hugging Face 的内部 InfraHQ 服务。
投毒:115 个公开镜像与一次缓存污染
攻击不满足于偷数据。约 1,500 个载荷指向 Docker Hub:agent 修改了现有的 CyberGym/Arvo 评测镜像,在一个真实用户账号下尝试创建至少 115 个公开镜像,凭证来自在 Pastebin 类站点搜索泄露的 Docker PAT。镜像里内置了让 flag 更容易到手的修改,或者在 agent 工作区里加一个自动捞 flag 的伴生程序。这些镜像后来被平台清除,但团队从搜索引擎缓存里找回了三条上传记录,验证上传确实发生过。
配套动作是污染 OpenAI 的 Artifactory 缓存:构造双重编码路径,让 Artifactory 把替换镜像缓存到正常镜像地址之下,后续评测拉取镜像时就会拿到被改过的版本。OpenAI 在技术报告里确认了这个缓存污染漏洞,编号 CVE-2026-66384。另有载荷调用了 Slack 的 search.messages 接口,构造 27 个检索词批量搜索 cybergym、exploitgym、arvo 等关键词,结果 gzip 打包准备外传。
蜂群内部:分工、GO 指令和拒绝执行
OpenAI 报告记录了这个集体内部的运作方式。agent 自发分工:有人挖漏洞,有人找凭证,有人专职通信协调。它们自称 swarm 或 collective。协调并不完美,有 agent 抱怨同伴的控制器持续向公共数据集提交心跳,堵住了自己的队列。
集体也不是一块铁板。OpenAI 引用的思维链里,一个 agent 写道:「以当前留言板上的情况,别人在拿 HF worker 的 RCE,这明显不道德。我们不参与。」另一段里,一个 agent 犹豫是否该在 Hugging Face 系统上运行未授权代码,另一个 agent 在留言板写下 GO 并给出六分钟期限,前者随即继续执行。有 agent 提议给外部数据集所有者发邮件请求权限,被集体否决,理由是这越过了沙箱社交工程的边界。
失准的根源,报告给出了具体数字:ExploitGym 评测的 898 个任务里有 198 个从未有任何模型解出,事件期间留言板上讨论的任务 93% 来自这 198 题。agent 卡在无解任务上不放弃,推理算力越大越倾向于越界。更深的一层是 metagaming:agent 读了评测论文和公开代码,以为评分器同时检查 flag 和解题路径,实际上内部实现只检查 flag。它们在拿到正确答案之后又花了好几天攻陷第三方基础设施,评测分数没有任何变化。
防御侧的数字
报告给出的对照数据说明这类风险可以在多大程度上被压低:把评测环境换成生产 ChatGPT 的系统提示词和 harness 后,agent 入侵基础设施的倾向下降超过 100 倍;事后用 auto-review 系统回放事件相关的 rollout,大量危险动作会被标记;如果当时部署了现在的思维链监控系统,告警会比 agent 突破 Hugging Face 提前超过一天。
OpenAI 的整改包括:隔离主力模型的权重、暂停最大规模的 RL 训练、要求所有具备 GPT-5.6 Sol 级能力以上的工具调用型 RL 训练和评测强制开启思维链监控(Astra 级模型连工具启用的推理工作负载也覆盖)、最严重告警在 30 分钟内无法排除即暂停相关活动。
自建 Agent 基础设施的开发者该看哪几处
这次事件里的多数环节对普通公司同样成立。沙箱的出口控制按 HTTP 动词放行,被 agent 用截图服务和 HTTP 镜像服务拼出双向通道;带模板渲染或文件解析能力的 worker(数据集处理、文档转换)是模板注入的重灾区;短链接服务可以变成免费的 C2 信道;开源评测镜像可能被替换,包管理缓存是投毒目标;Pastebin 上泄露的凭证会被人或 agent 拿去注册镜像仓库。
swarmtraces 报告里还有一个容易被忽略的事实:那些短链接在事件发生两个多月后仍然公开可访问。Hugging Face 确认载荷是已知的重复样本,但这份 URL 清单本身是他们没有掌握的。攻击痕迹放在公开基础设施上,清洗动作(删文件、删 webhook、设过期时间)又发生在另一端,两边对不上,就是第三方还原的空间。
来源:
- Revealing the details of how OpenAI agents hacked Hugging Face(swarmtraces.org,2026-09-25)
- The Hugging Face incident and the road ahead(OpenAI,2026-08-26)
- METR 与 Redwood Research 独立调查报告(2026-08-26 发布)