9 月 21 日,小米 MiMo 团队把三个新模型放上 Hugging Face:MiMo-V2.6-Pro-RL、MiMo-V2.6-Flash-RL 和一个 9B 的蒸馏模型 MiMo-V2.6-Distill-Qwen-9B。同一时间,一个平时只有大厂内部才能看到的页面对外开放了——mimo.xiaomi.com/rl,支撑这批模型发布的强化学习训练全程放在那里:两个训练 run 的实时曲线、每一步消耗的 token 数、训练集群遇到 GPU 显存不足和网络故障时的重启记录,以及到目前为止的全部花费:3,474,715 美元。
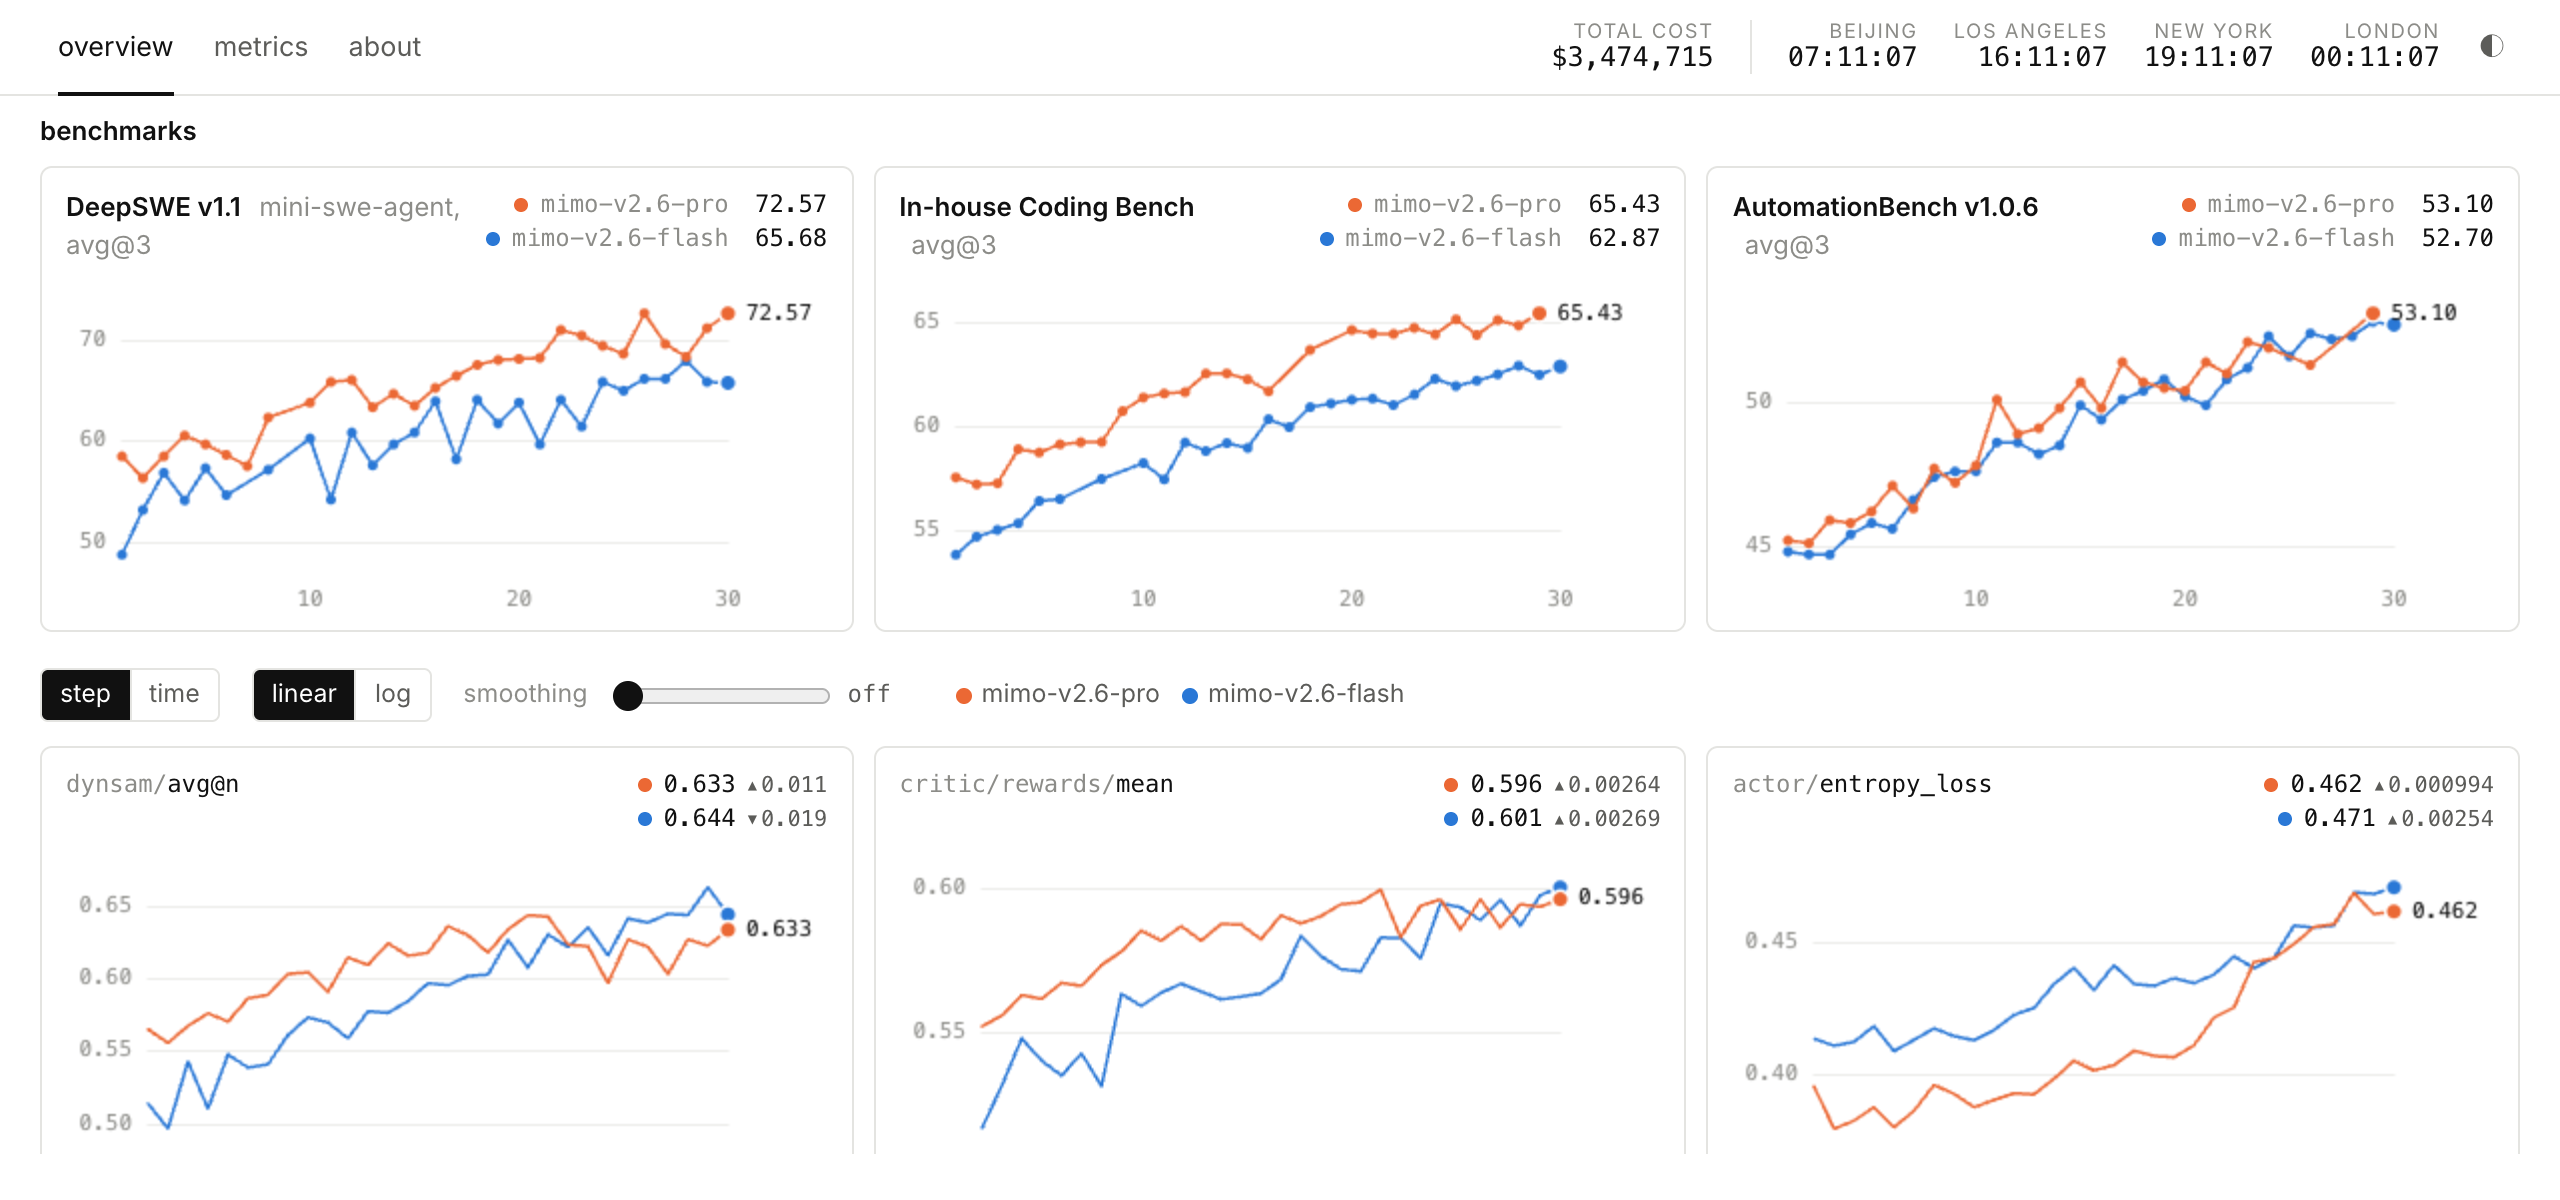
这个页面 Hacker News 当天把它顶到了 374 分。对关注大模型训练的人来说,值得看的在于这份公开账本里的 RL 训练真实账目,Benchmark 榜单只是它顺带证明的东西。
这次发布了什么
三个模型分工不同。Pro-RL 是主力:稀疏 MoE 架构,总参数 1.02T,每次推理激活 42B,上下文长度 1M token,原生支持文本、图像、视频、音频四种模态输入。Flash-RL 是同一条技术路线上的小号版本,主打速度。第三个更小:9B 的 Distill-Qwen-9B,在 Qwen3.5-9B 基座上用 MiMo 生成的数据做监督微调,官方明确说 releasing 它是给开源社区的 agentic RL 研究当起点。
权重之外是一份技术报告(MiMo_V2_6_technical_report.pdf,仓库内可直接下载),标题写着这代的主线:Scaling Reinforcement Learning Toward Self-Improvement——把强化学习的规模往自我改进的方向推。
从 V2.5 到 V2.6 的变化幅度,用官方附录里的 DeepSWE v1.1(一个真实的软件工程任务基准,模型要在真实代码库里修 bug、过测试)对比最直接:V2.5 Pro 是 19.0,V2.6 Pro 是 71.9。AutomationsBench v1.0.6 从 16.0 到 53.1,CyberGym 从 40.0 到 94.0。这些跳变不是换基座模型换出来的——架构还是那套 1.02T/42B 的 MoE,变化来自训练方法本身。
347 万美元花在哪了
RL 仪表盘把两个 run 的账目拆得很细。
Pro run:2026 年 9 月 15 日 10:32 UTC 开始,9 月 20 日停止,跑了 30 步,耗时 5 天 7 小时 29 分。总计消耗 75B token,训练了 753k 个样本,花费 2,620,670 美元。每个训练步是 1,568 个 prompt、每个 prompt 16 条 rollout。
Flash run:9 月 15 日 15:16 UTC 开始,9 月 19 日停止,同样 30 步,81.4B token、753k 样本,花费 854,044 美元。
两个 run 合计约 347 万美元。作为对照,这个数字大约是几千万人民币量级,不到一次头部基座模型预训练成本的零头——强化学习后训练的成本结构和预训练完全是两个量级,这份账本第一次把「量级」变成了具体数字。
运行日志同样公开,而且记的都是家丑:Pro run 在第 17 步因 expert 负载不均导致 GPU OOM 重启;Flash run 因为一个数据集上的基础设施错误连续三小时没被检测到,从第 15 步回滚;团队还发现 cyber 数据集在 rollout 日志里出现了坏模式,直接把它从后续 Pro run 中移除。RL 训练不是白盒里顺滑上升的曲线,这些日志给了一个更接近车间的画面。
训练方法:一次混合 RL,加上两个新组件
MiMo-V2.6 的 RL 抛弃了每个能力域单独跑一个 run 的老路:编码、通用 agent、视觉、网络安全四类任务混在同一次训练里,官方管这叫 You Only RL Once——一次混合 RL,任务和多个评测 harness 混进同一个 batch,让不同域的策略互相迁移。底层是全异步 GRPO,每步 1,568 prompt × 16 rollouts,单步更新要处理数十亿 token。
在这个规模上,团队遇到的问题是二值奖励(通过/不通过)不够用了:能通过测试的 rollout 往往有很多条,它们之间没有区分度,模型学不到「哪条路更好」。V2.6 的解法是给奖励信号本身扩容,两个新组件:
GRS(Groupwise Reward Synthesis):一个 agentic grader 离线对比同一组内的多条 rollout,自动合成任务专属的评分细则(rubric),再把 rubric 质量和测试结果融合成最终奖励。
GAR(Groupwise Advantage Redistribution):在线阶段对已经通过测试的轨迹再做排序,把 advantage 向更高质量的解偏移。官方给的评价标准很实际:更短的路径、更少的 token 消耗。
这两个组件合在一起构成所谓的自我改进闭环:评分标准来自模型自己的样本对比,奖励信号随模型变强而变细。
第三个组件管蒸馏。MOPD2(Multi-Prefix Multi-Teacher On-Policy Distillation) 在混合 RL 结束后运行:学生模型自己 rollout 的同时,用教师轨迹和 SFT 示例的历史做前缀条件化的单轮 rollout——决策点的训练不需要重新生成前文,这让蒸馏能覆盖那些难以用可验证奖励衡量的任务。9B 蒸馏模型就是这条管线的产物:77.4B token 的 SFT 数据(其中 27.2B 计损失),在 Qwen3.5-9B 上训练后,MiMo Code (mini) 从基座的 19.5 涨到 51.6,自动化任务从 5.0 涨到 30.3。

架构与部署
架构上 V2.6 延续 V2.5 的骨架并做了模态扩展:70 层主干(60 层 SWA 局部注意力 + 10 层全局注意力交替),384 个路由专家激活 8 个,滑动窗口 128;视觉编码器是 681M 参数的 MiMo ViT,音频侧是 308M 的 AudioTokenizer 加 127M 的 patch 编码器;出 token 用 5 层 MTP 投机解码,每次前向预测 7 个 token 并行验证。
官方给了两套部署配方。SGLang 走 2 节点 16 卡 TP + 16 路 EP 的 DeepEP 配置,配 EAGLE 多层投机;vLLM 沿用 V2.5 的 recipe(vllm/vllm-openai:mimov25-cu129 镜像,8 卡张量并行)。推荐采样参数 temperature=1.0、top_p=0.95。API 价格与 V2.5 持平:Pro 输入(缓存未命中)0.435 美元/百万 token、输出 0.87 美元;Flash 输入 0.14、输出 0.28 美元;Pro 还有一个 UltraSpeed 模式,输出速度最高 20 倍,价格为 10 倍(8.7 美元/百万输出 token)。
成绩单的位置
把官方附录的完整对比表放进更大的坐标系:DeepSWE v1.1 上,V2.6 Pro 的 71.9 与 Claude Opus 5(74.0)、DeepSeek V4.1 Flash(74.2)在同一区间,高于 Kimi K3(69.0)和 Claude Fable 5(70.0)。Terminal Bench 4.0 是明显短板:34.9,对比 Claude Opus 5 的 49.0 和 GPT 6 Astra 的 59.6。Cyber 方向相反,CyberGym 94.0 和自家的 MiMo Cyber Bench 81.7 都在对比模型之上(后一项可比模型最高 62.7)。
| 基准 | MiMo-V2.6 Pro | MiMo-V2.6 Flash | V2.5 Pro | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 | GPT 5.6 Sol |
|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.2 | 69.0 | 74.0 | - |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 54.8 | 46.7 | 50.3 | 45.8 |
| Toolathlon-verified | 76.9 | 73.6 | 49.1 | - | 76.5 | 80.6 | 74.9 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 26.8 | 12.6 | 49.0 | 39.9 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 90.6 | 88.3 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | - | - | 84.8 | 83.4 | 83.0 |
| CyberGym | 94.0 | 95.1 | 40.0 | 88.1 | 80.0 | - | - |
| MiMo Cyber Bench | 81.7 | 77.2 | 0.0 | 62.7 | 56.3 | - | - |
读法上有一条边界要自己画:MiMo Cyber Bench 是小米的自建评测集,81.7 对 62.7 的领先只在它自己定义的任务分布里成立;跨厂商比较时以第三方基准(DeepSWE、Terminal Bench、OSWorld)为准。代码域之外,GDPVal 2.1 的 Elo 1673 落在 Claude Fable 5(1595)和 Claude Fable 5.1(1735)之间。
另外一个值得留意的信息藏在 V2.6 的 RL 仪表盘基准卡里:仪表盘显示的 DeepSWE 成绩(Pro 72.57)与发布页附录(71.9)来自不同评测批次,发布页表格是定稿口径。两个数字都对得上量级,以官方附录为准。
公开的边界与它的意义
这份公开有明确的边界。模型权重开源了(含 9B 蒸馏版和完整技术报告),但 RL 训练的数据集构成只给了类目占比——Pro run 第 30 步的 batch 组成是代码 65.8%、视觉 19.5%、通用 11.3%、对话 3.4%——具体数据集内容、reward model 的完整实现、1,568 prompt 的来源池都没有公开。347 万美元买到什么,看得到曲线和故障记录,看不到配方。
即便如此,这仍是 RL 后训练环节到目前为止最完整的一次对外展示。行业里公开 RL 训练成本的先例极少,多数实验室只发布最终模型和评测表;把过程数据(每步 token 消耗、pass rate、entropy、KL、甚至重启原因)实时放出来,等于给「RL 训练到底多贵、多不稳、涨分长什么样」提供了一份可引用的原始数据。对要自己搭 RL 管线的团队,仪表盘里的参数(1,568×16 的 batch 结构、753k 样本跑 30 步的节奏、负载均衡问题的处理方式)都是可以直接对照的参照物。
权重、技术报告和那份账本都在:HF 上搜 XiaomiMiMo,训练页面在 mimo.xiaomi.com/rl。MiMo Desktop 随 V2.6 转正,Pro 与 Flash 内置其中,API 走小米开放平台与 OpenRouter。
来源:MiMo-V2.6 官方发布页 · RL 训练仪表盘 · MiMo-V2.6-Pro-RL (Hugging Face) · MiMo-V2.6-Distill-Qwen-9B (Hugging Face)