阶跃星辰 Step 5 Preview:同价位挖不动,同智商更便宜的选择出现了
9 月 20 日上午,上海模型公司阶跃星辰发布新一代旗舰模型 Step 5 Preview,并同步放出一个在国产模型里相当少见的承诺:10 月 15 日开放权重下载。这份发布页值得逐段读的原因在于,它没有把篇幅花在「超越 GPT」这类叙事上,而是围绕一条完整的证据链展开:同级智商、更低价格、可验证的长任务能力,外加一个明确的开源时间点。
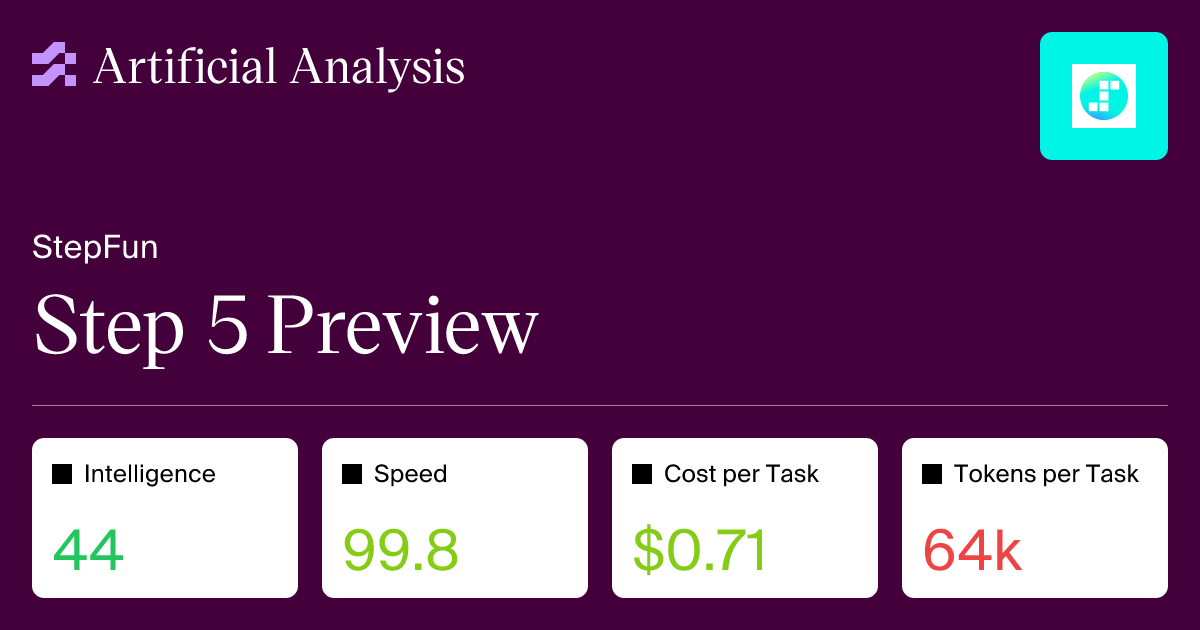
架构:600B 总参数,27B 激活
Step 5 Preview 基于稀疏混合专家(MoE)架构,总参数 600B,每 token 激活 27B,支持 1M token 上下文窗口和视觉输入。MoE 的核心机制是把前馈层拆成多个「专家」,路由器为每个 token 只选择少量专家参与计算,因此推理成本与激活参数挂钩,而非总参数。
这个配置放在当前的国产第一梯队里是什么位置,可以直接对表:
| 模型 | 总参数 | 单次激活 | AA 智商指数 | API 定价(输入/输出,每百万 token) |
|---|---|---|---|---|
| Step 5 Preview | 600B | 27B | 44 | $1.00 / $2.70(缓存命中输入 $0.05) |
| Kimi K3 | 约 2.8 万亿(HN 讨论者引用) | — | 44 | 官方页未列,第三方普遍更高一档 |
| GLM-5.3 | 约 1.25 倍于 Step 5(HN 讨论者引用) | — | 42 | — |
三个数字来源要分开说:Step 5 的参数与定价来自阶跃官方发布页和 platform.stepfun.ai 定价页;AA 智商指数来自 Artificial Analysis 模型页;Kimi K3 与 GLM-5.3 的参数对比出自 HN 讨论者的引用,精确度一般,但量级关系(Step 5 显著更小)与官方「同等智能水平下任务成本显著更低」的表述一致。
定价值得单独看。Step 5 Preview 输入 $1.00、缓存命中 $0.05、输出 $2.70,按官方说明,缓存未命中输入价已包含缓存写入成本,输出价包含推理过程与最终答案的全部 token。HN 讨论里有人拿它和自家 Step Plan 订阅对照($6.99/月含约 $60 用量、$9.99/月含约 $220 用量),对重度 API 用户来说订阅价与按量价的差距相当大。
跑分:第三梯队的位置,第一梯队的细分项
官方基准矩阵里,看点在分布而不只是名次:
| 基准 | Step 5 Preview | Kimi K3 | GLM-5.3 | GPT-6 Astra | Claude Opus 5 |
|---|---|---|---|---|---|
| DeepSWE v1.1(软件工程) | 67.7 | 67.5 | 66.9 | 74.1 | 74.0 |
| StepCodeBench(自建,553 仓库) | 49.0 | 43.9 | 40.2 | 61.0 | 63.9 |
| ProgramBench(代码生成通过率) | 80.5 | 77.8 | 72.0 | 85.4 | 82.3 |
| Terminal-Bench v4 | 33.3 | 12.6 | 41.9 | 57.9 | 52.3 |
| FrontierFinance(金融) | 66.4 | 62.6 | 64.1 | 55.0 | 69.7 |
| GPQA Diamond | 93.5% | 93.5% | 91.7% | 96.1% | 93.2% |
| HLE | 46.5% | 46.9% | 42.3% | 54.7% | 54.9% |
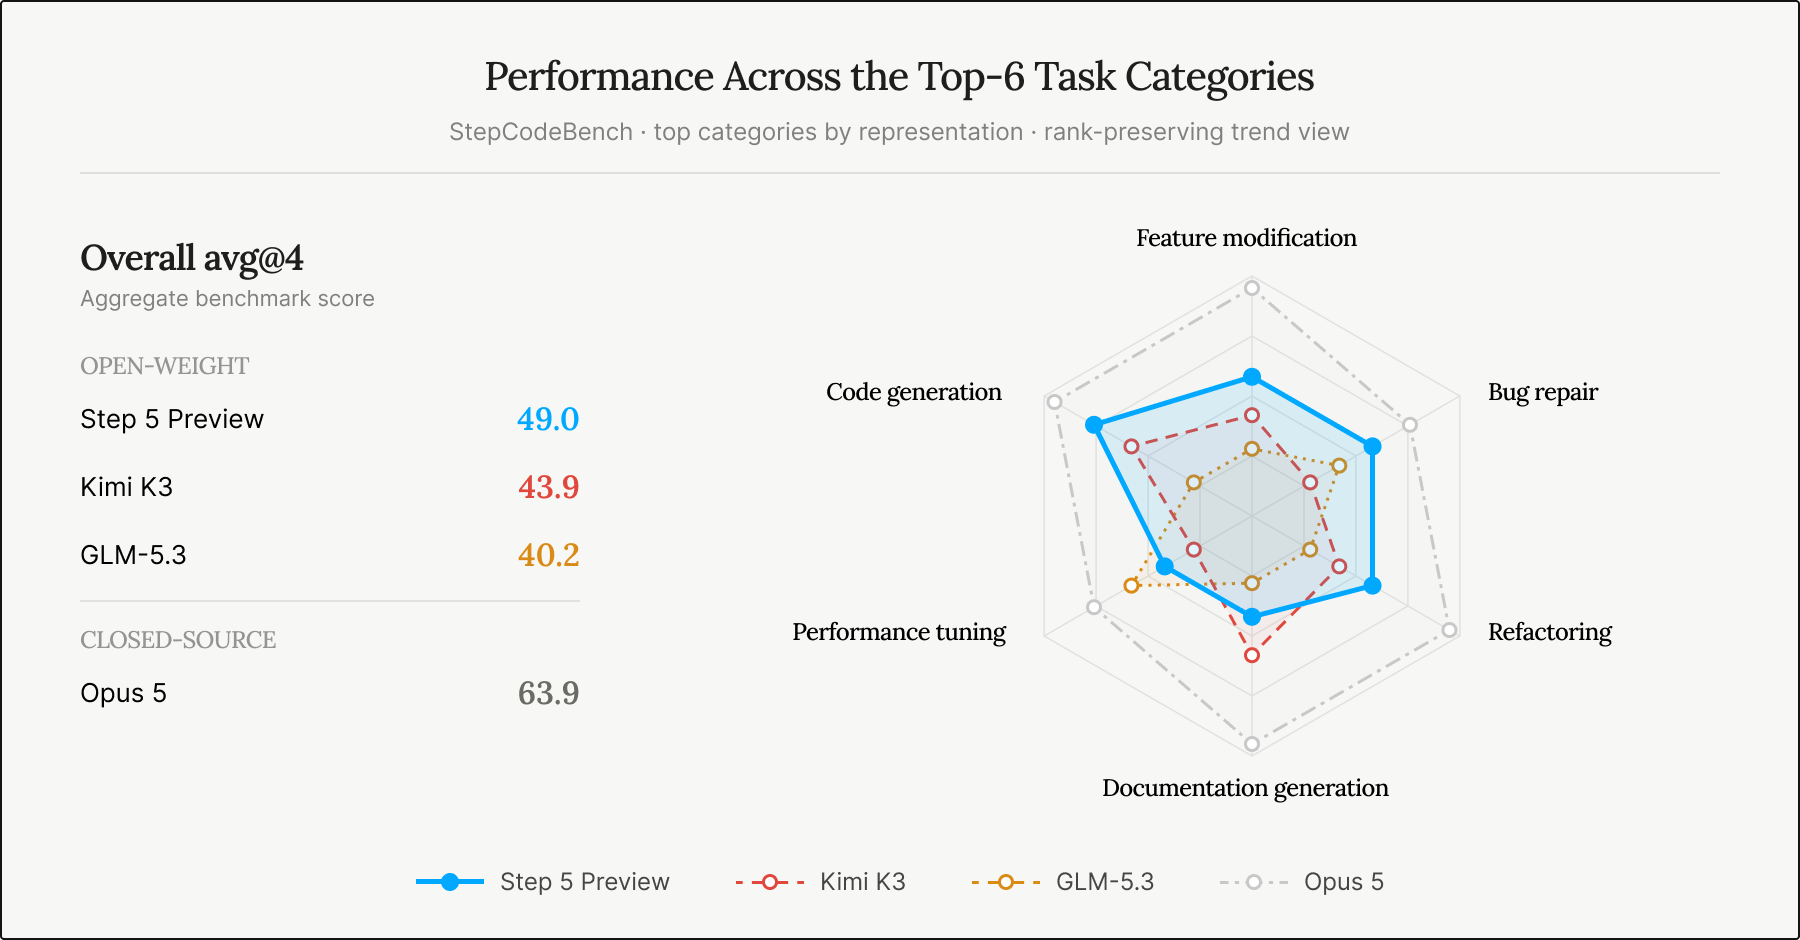
从这张表能读出三层信息。第一层,与 Kimi K3、GLM-5.3 组成的那一档,Step 5 Preview 在大多数项目上持平或领先,GPQA Diamond 打平 Kimi K3 的 93.5%,AA-LCR 长上下文推理 88.3% 是这一档最高。第二层,与 GPT-6 Astra、Claude Opus 5 仍有稳定差距:DeepSWE 落后约 6.4 分,HLE 落后超过 8 分,官方原话承认「最具挑战性的长周期任务上仍有明显差距」。第三层,金融是官方重点投入的差异化方向:FrontierFinance(外部基准,220 道专家题、11543 条评分标准)上 66.4 分领先除 Opus 5 外的所有对手,比 GPT-6 Astra 高出 11.4 分;自建的 FinStepBench 三项(实时检索 74.5、企业估值 60.6、深度研究 55.8)也都处于前列。金融场景的采用是这家公司从前一代 step-3.7 系列延续下来的既有标签,这一代把金融做成了单独的评测章节。
值得留意的一个反例是 Terminal-Bench v4:Step 5 拿 33.3,明显低于 GLM-5.3 的 41.9 和两个闭源旗舰。终端操作类任务上它不是同级首选。
两个 24 小时实验:长任务能力的直接证据
比榜单更有信息量的是官方设计的一组长周期实验,两者都限定 24 小时,让模型自主决定迭代方向。
MLA GPU 内核优化:在 H100 上从一段自然语言描述出发,为 head_dim=512、batch=1、64 heads、8192 tokens 的生产形状从零实现并优化 MLA(多头潜在注意力)GPU 内核。模型自己写代码、编译、测吞吐,候选版本跑得比当前最优慢就丢弃回滚。每模型 4 次独立尝试取最好成绩。Step 5 Preview 在约 22 小时后把前向+反向吞吐做到 508 TFLOPS,Claude Opus 5 为 493 TFLOPS。GPU 内核优化是出了名的专家领域,让模型在 24 小时约束下逼近人类专家水平,这是「agentic work」这个定位的直接注脚。
后训练数据循环改进:给定 Qwen3-30B-A3B 基座和一个可访问生产数据的 API 标注器,让模型自行决定如何使用标注器、如何修订后训练数据,并跟踪这些决策对下游成绩的影响。24 小时后,产出的模型在 AIME24 官方测试上从 53.3% 提升到 60%,与 Claude Opus 5 做同样工作取得的成果持平,消耗的标注器 token 更少。
还有一个小体量的展示:在宝可梦红(人类通关约需 26 小时)里,模型不借助任何游戏专属优化,已持续 3000+ 回合、600 万 token 交互,第 3082 回合拿到三枚徽章并击败雷系道馆馆主 Lt. Surge,进度约主线三分之一。这类游戏长跑测试考察的是远期目标维持、资源管理和失败恢复,与编码任务的「长视野」要求同构。
开发者视角:10 月 15 日之后
对要「拿回来自己跑」的开发者,10 月 15 日的权重开放是这条新闻里实际影响最大的部分。600B/27B 的配置在全精度下需要多卡(约 1.2TB 显存放权重),但按当前开源 MoE 的通行做法,4-bit 量化后约 300GB,8 卡 H80/H100 或 Mac Studio 集群是可见的部署档位;27B 的激活量也意味着量化后推理速度可接受。如果阶跃沿用 step-3 系列的开源许可风格,商用 restriction 大概率存在,部署前需要核对 license。
API 侧的成本结构已经清楚:$1.00/$2.70 的输入输出定价,加上 $0.05 的缓存命中价,对长上下文重复前缀的场景(比如固定 system prompt + 大文档反复问答)相当友好。1M 上下文窗口放进了同价位少有的配置。
金融方向的选择也值得从业者注意:FinStepBench 三项内部基准把「可审计」写进评测目标(来源可追溯、假设显式、计算可复现)。这与金融行业对 AI 输出的合规要求对齐,是有意识的产品化设计。
结论
Step 5 Preview 没有改写前沿格局,GPT-6 Astra 和 Claude Opus 5 仍在前方。它做的事情是另一件:把「Kimi K3 / GLM-5.3 这一档」的智商水平做到了更低的成本点上,给金融场景加了差异化,并且给出 25 天后的开源时间表。对预算敏感、又要一线开源可用性的团队,10 月 15 日是一个值得日历标记的日期。
来源:Step 5 Preview 发布页(阶跃星辰)、阶跃星辰开放平台定价页、Artificial Analysis: Step 5、Hacker News 讨论