9月15日,一家名叫 TypeSafe 的 AI 公司发布了第一个公开模型 Jev。它的特别之处在于不生成任何文字:输入一段文本或一份数据,返回的是一个选项、一个分数或一个是/否判断,每个答案都附带可信度概率。发布当天,Jev 冲上 Hacker News 首位,讨论区涌入数百条评论;TypeSafe 同步宣布拿到 DCVC 领投的 4000 万美元种子轮。
官方给出的定价是输入 token 每百万 0.042 美元,输出不收费;实测响应时间 70 到 500 毫秒。作为对照,主流旗舰大模型完成同类型调用需要 3 秒到 5 分多钟。一家成立两年的公司,凭什么把「快两个数量级」写进首页?差别在它砍掉的东西里。
砍掉字符串生成之后
大模型的一切输出——回答、代码、拒绝语,都是逐个 token 生成的:每个词都建立在前一个词之上,一条长长的链条走完才有完整答案。这种自回归方式让模型获得了写文章的能力,代价是慢和贵,而且输出格式靠约定维持。开发者想让模型返回 JSON,就要在提示词里反复强调格式,再用解析器兜底,即便如此,格式崩坏依然是生产环境的常发故障。
Jev 把整条生成链条拆掉了。它的输出空间预先枚举:从最多 255 个选项里挑一个(Choice)、给一个连续分值(Score)、或返回一个带概率的布尔判断(Noul)。因为所有可能答案事先确定,模型在一次并行计算里就能给出全部选项的概率分布,没有逐 token 解码,也没有格式漂移的空间。TypeSafe 把这个形态叫做「面向软件的前沿智能函数调用」:非结构化状态进去,带类型保证的概率化决策出来。
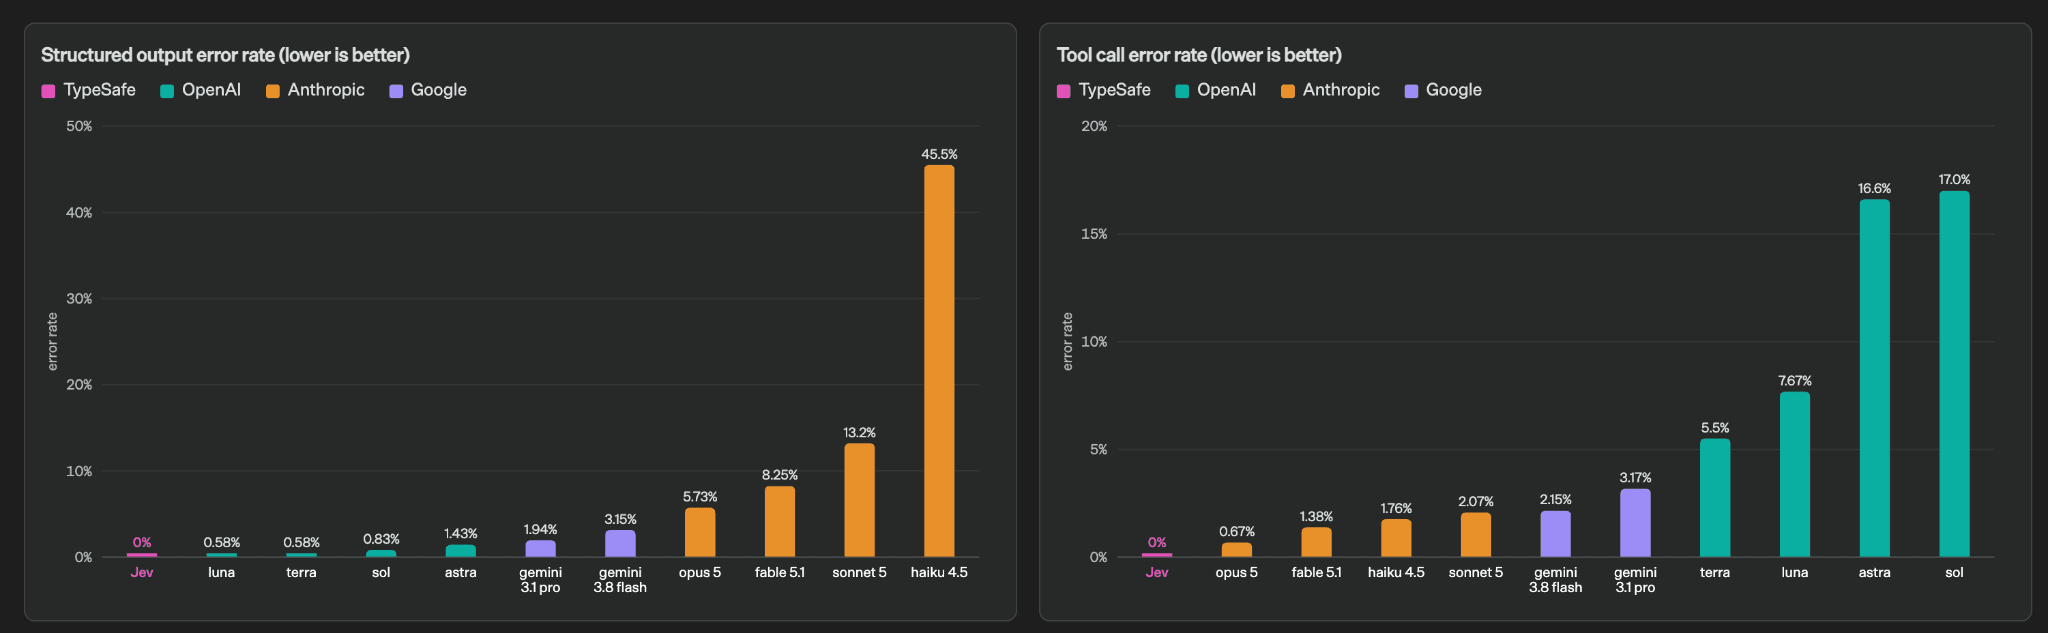
官方公布的对比数据里,Jev 的结构化输出错误率是 0%。这个数字需要正确理解:它并非跑分测出来的,而是结构使然——输出空间封闭,格式错误在数学上不可能发生。各家的 LLM 数据则来自 OpenRouter 的路由日志,官方自己也注明这组对比存在查询难度偏差。即便打折扣,LLM 侧的错误率量级仍然触目:
| 模型(厂商) | 结构化输出错误率 | 工具调用错误率 |
|---|---|---|
| Jev(TypeSafe) | 0%* | 0%* |
| opus 5(Anthropic) | 5.79% | 0.67% |
| fable 5.1(Anthropic) | 8.25% | 1.33% |
| sonnet 5(Anthropic) | 13.2% | 2.07% |
| haiku 4.5(Anthropic) | 45.6% | 1.78% |
| terra(OpenAI) | 0.58% | 5.5% |
| sol(OpenAI) | 0.58% | 17.0% |
| luna(OpenAI) | 0.58% | 7.6% |
| astra(OpenAI) | 1.43% | 16.6% |
*非实测值:输出空间封闭,类型错误在结构上不可能发生。
注意 sol 和 astra 的位置:在需要生成结构化字符串的场景里,这两款以推理见长的旗舰模型,工具调用错误率反而高达 17% 和 16.6%。模型越聪明,越倾向于在格式里「发挥」,这个问题靠提示词压不住,因为根源在采样方式本身。
RLCD:把校准写进训练目标
训练方法上,TypeSafe 没有沿用 RLHF(用人类偏好塑造回答)或 RLVR(用可验证奖励训练推理),而是提出 RLCD——Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习。
三者的差别在优化目标。RLHF 优化「人类评测员喜欢什么」,RLVR 优化「答案能否通过程序化验证」,RLCD 优化「置信度是否诚实」:模型说 70% 把握的时候,长期统计下来就该有七成正确率。置信度失准的模型无法被自动化流程信任——一个任务能做对 95%,但从不说自己什么时候在那 5% 里,软件就没法基于它的回答做路由决策。
校准正对应 Jev 的定位。创始人 Diogo Almeida 是 InstructGPT 论文的共同作者,那篇 2022 年的工作奠定了 ChatGPT 的技术路线。他在接受 Every 采访时把动机说成一句话:「问题出在文本本身。」让软件消费一个模型的输出,最不可控的环节就是自由文本;TypeSafe 的口号「We're building prod, not God」(我们做的是生产环境,不是神)说的也是这件事。
数据:官方评测与第三方实测
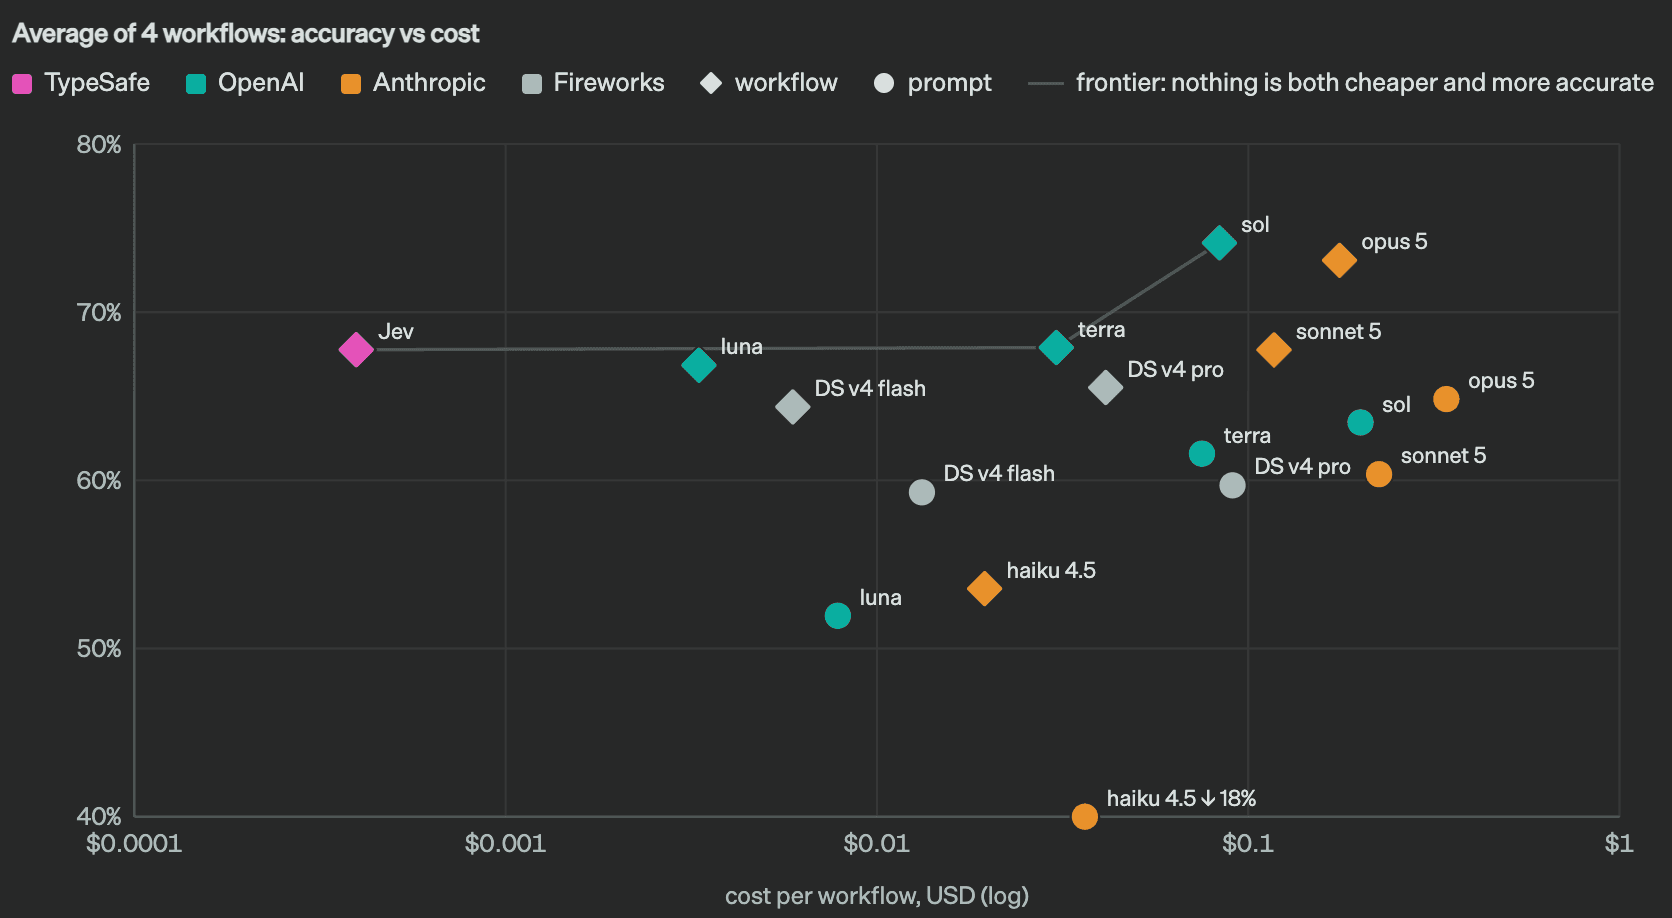
TypeSafe 为发布自建了一套 workflow evals:假定存在一个由代码构成的正确计算图,把 GPT-6 Astra 与 Fable 5.1 两款旗舰模型的预测均值当作参照概率,衡量各模型与参照的偏离程度。在这个口径下,Jev 在四个工作流的成本-准确率散点图上占据帕累托前沿接近两个数量级的区间;首页的 193.6 倍速度、444.6 倍成本优势也来自这套评测,官方同时注明这处于真实收益区间的高端,速度数据则多在西海岸的笔记本上测得,定价无法证明没有补贴。
第三方实测数据来自科技媒体 Every。评估主管 Mike Taylor 把自己 27 篇文章加上 10 篇刻意模仿 AI 腔的文本共 37 份文档,同时抛给 Jev 21 个判断问题,777 次判断在 0.7 秒内返回,成本估算约四分之一美分。整个评测套件 11 组实验、1709 次判断,总成本不到 1 美分。
更有参照价值的是对照实验。Every CEO Dan Shipper 让 Jev 与 Fable 5.1 执行同样的 4 项写作检查,对象是 12 段合成功文本(6 段干净、6 段埋了缺陷):Jev 单段中位耗时 0.35 秒,Fable 5.1 高推理档为 8.83 秒,约 25 倍差距;估算成本相差约 580 倍。准确率上,Jev 抓住 7 个埋设缺陷中的 6 个,Fable 5.1 全中——漏掉的那个(一段「家长和员工共同教学一个共享日历」的表述)Jev 在三次运行里都没识别出来。25 倍速度和 580 倍价差换来六分之七的召回,这笔账在很多自动化场景里是划算的。
Hacker News 上的质疑
发布帖下的批评集中在口径而非方向。几个反复出现的点:
「前沿模型」的措辞。Jev 不能写代码、不能对话、不能生成一个句子,把它与 GPT、Claude 并列称作 frontier model,被指借用尚未独立验证的信誉。更准确的描述是「把结构化决策的性价比边界推进了一个量级」。
速度对比的公平性。70 毫秒的对照组是让 LLM 自回归生成完整结构化答案(模式名、格式一并生成),倘若让 LLM 只输出等价的短决策,差距会明显收窄。
自家考卷自家判。workflow evals 的参照答案是两款竞品模型的预测均值,并非标准答案;TypeSafe 已表态不参加公开基准榜单,只随产品更新发布一次性评测,这个选择在社区里被读作对公开打分的回避。
「不会幻觉」的边界。格式不会错与内容不会错是两回事——一个分类器可以置信度拉满地给错答案。Almeida 本人在讨论区确认了这个区分:「它也可能自信地犯错,未来所有模型都会更聪明,同时仍然保有这种可能。」
另外一个容易被演示忽略的细节:广为流传的 Jev 实时打通 Doom 的视频,输入的是结构化文本状态(坐标、距离、角度的 JSON),并非画面像素。它证明的是低延迟决策能力,TypeSafe 也没有宣称更多。
适合放在 LLM 旁边的位置
Jev 的 32K 上下文(早期用户披露)、纯文本输入、无法生成内容,决定了它与旗舰 LLM 之间是分工而非替代。社区讨论里被引用最多的框架来自一位评论者:用 LLM 交互式地定义决策逻辑,再让 Jev 这类模型在生产环境里反复执行它。
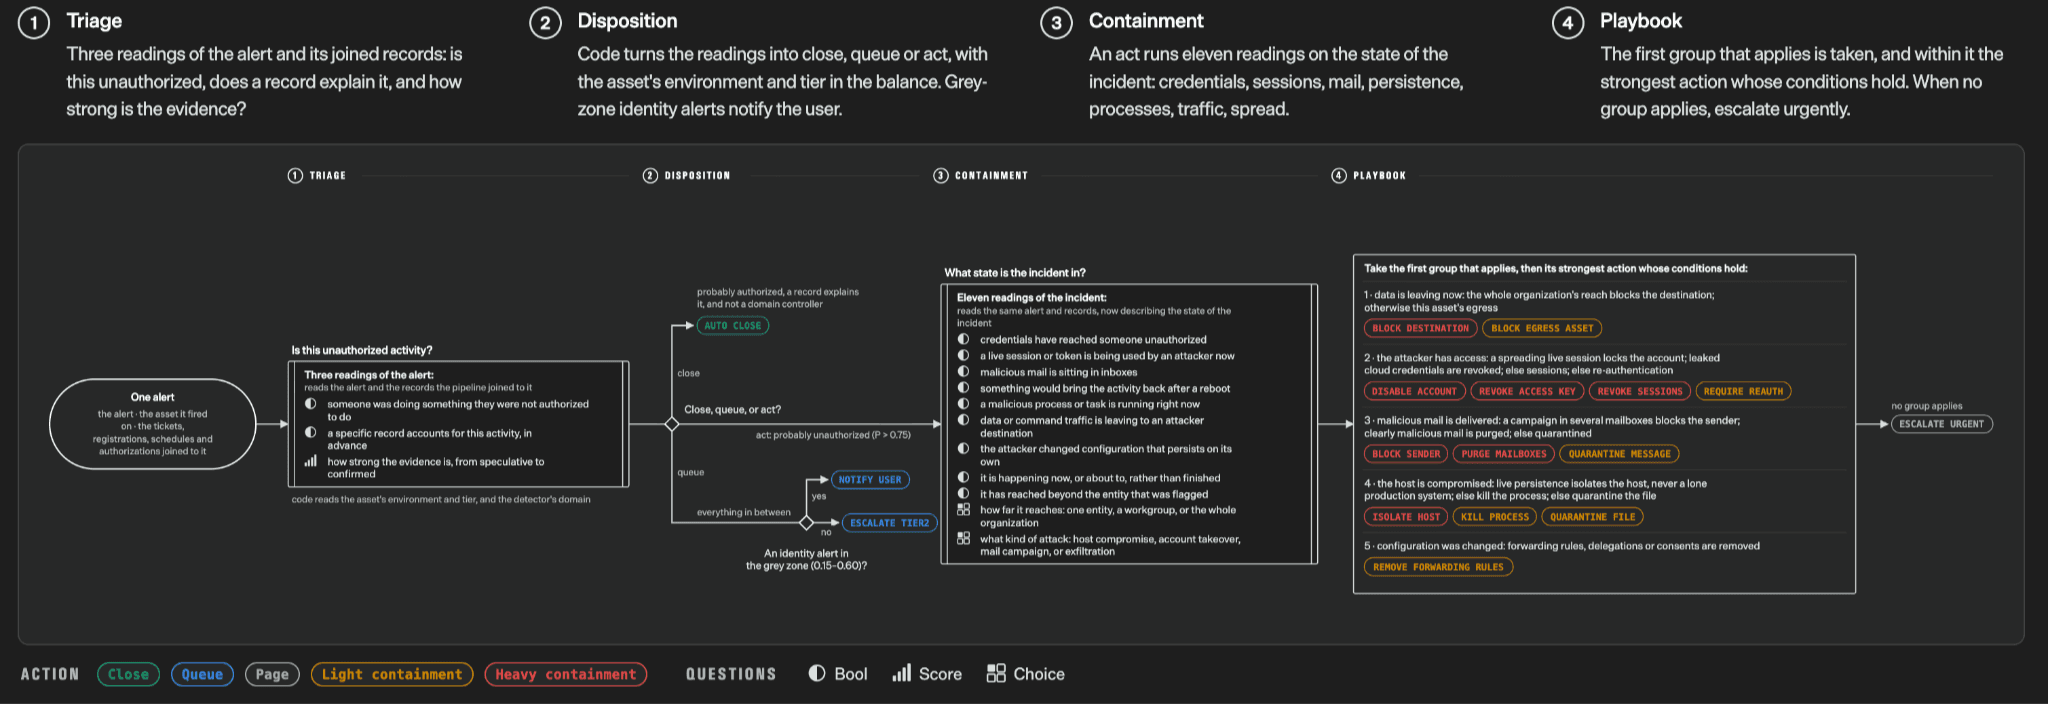
落到工程里,反复出现的场景有四类。路由与分类:工单分派、交易风控分层、多智能体系统里的任务分发,调用频次以百万计,LLM 单次调用在成本和延迟上都撑不住。护栏与复核:把另一个模型的输出再过一遍布尔判断,低置信或自相矛盾的答案先拦下再呈现。实时决策:语音助手是否打断、游戏 NPC 的即时反应,3 秒级的 LLM 往返直接毁掉体验。批量打分:百万级记录的评分标注,按 LLM 单价算账会直接否决项目。TypeSafe 官方的概括更短:智能 if 语句——手写规则太脆、LLM 调用太重的那一层。
成本结构是这个定位的另一面。官方博客算过一笔账:Doom 演示每秒查询 10 次,时薪约 7 美元,团队原以为会更高。当一次判断降到万分之一美分级,原本「不值得用 AI」的决策点全部开放了。模型以 Jevons 命名,用的正是杰文斯悖论的逻辑——蒸汽机效率提高后煤的消耗不降反升,判断成本的下降大概率带来判断需求指数级的上涨。
现在能不能用上
Jev 目前处于 early access,官网 waitlist 排队放号;没有公开的 API 定价页,未上架 OpenRouter 等模型聚合平台,请求/响应结构也与 OpenAI 风格的 chat API 不兼容,接入需要按其文档写专用客户端。模型权重不开放,没有架构论文,TypeSafe 表示技术细节「暂时保密」。
可以确定的事实:公司 2024 年创立,创始人是在 OpenAI 参与过 InstructGPT 的 Diogo Almeida,公开信息里团队称在隐身状态下做了两年;DCVC 领投的 4000 万美元种子轮与模型同日官宣。判断型 AI 是否真如官方数据那样又快又准,要等更多第三方复测;但「把字符串生成从模型里砍掉」这个方向本身,已经是发布当天整个讨论区公认成立的一步。