9 月 10 日,DeepSeek 正式发布 V4.1 Flash。按官方公告的定位,这是全新模型结构系列中目前最小的型号,552B 参数的 MoE 模型,原生支持多模态视觉理解,上下文长度 1M token。真正让它成为话题的,是官方给出的一组对比结论:经内部和外部多方测试,V4.1 Flash 在性能、费用、速度、总用时等指标上全面超越自家的旗舰 V4 Pro,因此 V4 Pro 进入有序下线流程。小尺寸型号接棒旗舰,这在 DeepSeek 的版本序列里是第一次。
定价:三档单价全部下调,缓存命中价降到 7.5 分之一
先看价格。新价格从 2026 年 9 月 10 日 12:00 起生效,以百万 token 计,高峰时段(北京时间周一至周五 9:00-12:00、14:00-18:00)费率如下,闲时费率为高峰的一半:
| 计费项 | V4.1 Flash(高峰) | V4 Pro(原价) | 倍数 |
|---|---|---|---|
| 输入(缓存命中) | 0.04 元 | 0.30 元 | 7.5× |
| 输入(缓存未命中) | 2 元 | 9 元 | 4.5× |
| 输出 | 8 元 | 27 元 | 3.375× |
| 并发限制 | 2500 | 500 | 5× |
降幅最大的是缓存命中价。Agent 类负载的特点恰恰是缓存命中占比高:系统提示、工具定义、仓库上下文在每一轮请求中原样重复,命中部分越长,这个单价对总成本的影响越大。拿一个典型场景算一笔账:50k token 的系统提示(全部缓存命中)加每轮 3k token 新输入加 1k token 输出,连续跑 1000 轮,高峰时段价格下,V4.1 Flash 花费约 16 元,同样的账单按 V4 Pro 费率算约 69 元,相差 4.3 倍。并发上限从 500 提到 2500,对做批量任务的服务商是另一个独立利好。
模型名改为 deepseek-flash 即可调用 V4.1 Flash。旧版 V4 Flash 与 V4 Flash Vision Exp 已下线,旧模型名 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 会被暂时路由到 V4.1 Flash。此前 DeepSeek 的视觉能力靠单独的实验性视觉模型提供,图文混合任务需要在两个模型之间切换,这次原生多模态把这个切换省掉了。
V4 Pro 的下线节奏有一个后续变化:公告原计划北京时间 9 月 14 日 12:00 之后把 deepseek-v4-pro 的请求全部路由到 V4.1 Flash 并按 Flash 单价计费;随后定价页脚注更新为「响应广大用户的需求」,9 月 14 日之后继续提供 V4 Pro 的 API 调用服务,计费方式保持不变。想继续用旧旗舰的开发者保住了选择权,代价是维持原价。
CED 架构:输入 8B、输出 16B 的非对称激活
V4.1 Flash 的核心变化在模型结构。此前主流 MoE 模型对输入和输出用同一套激活参数,而 V4.1 Flash 采用新的 Causal Encoder-Decoder(CED)结构:40 层 Transformer 拆成 20 层因果编码器加 20 层解码器,解码器的全局 KV cache 从编码器最终隐藏态投影得到,不再由解码器每一层自己的隐藏状态推导。输入阶段的每 token 激活参数只有 8B,输出阶段为 16B。
这个非对称设计针对的是 Agent 工作负载的成本结构。Agent 任务的 token 构成以输入为主:一轮工具调用循环里,历史上下文、工具返回结果反复进入输入端,而模型真正生成的输出往往只占小头。输入端激活压到 8B,意味着 prefill 阶段的算力和显存开销大幅下降,官方称成本显著低于已知的同尺寸模型。MoE 细分结构上,每层配置 1 个共享专家加 384 个路由专家,每 token 激活 6 个路由专家。
解码侧的计算密度更高(16B 激活),配合新预训练方式和更大规模的强化学习后训练,基准成绩没有因为输入端瘦身而掉队。后训练沿用 SFT → RL → on-policy distillation 的标准流程,改动集中在数据管线:大规模自动合成 agent 任务和环境,数据、任务、rollout 数量渐进扩展。模型还提供 1 到 100 的连续推理力度设置(reasoning_effort),用推理成本换准确率,官方测评数据均在 effort=100 的最大档取得。
预训练从零开始,多模态语料共 45T token,稀疏注意力先在 64K 序列长度上训练,训练到 34T token 时把上下文扩展到 1M。视觉侧由从头训练的 DeepSeek-ViT(2D-RoPE、3×3 pixel-unshuffle 下采样)加两层 MLP 投影器组成,图像嵌入与文本嵌入从预训练之初就联合处理。
KV Cache 压到 890 字节/token:CSA2、FP4 与有界重放
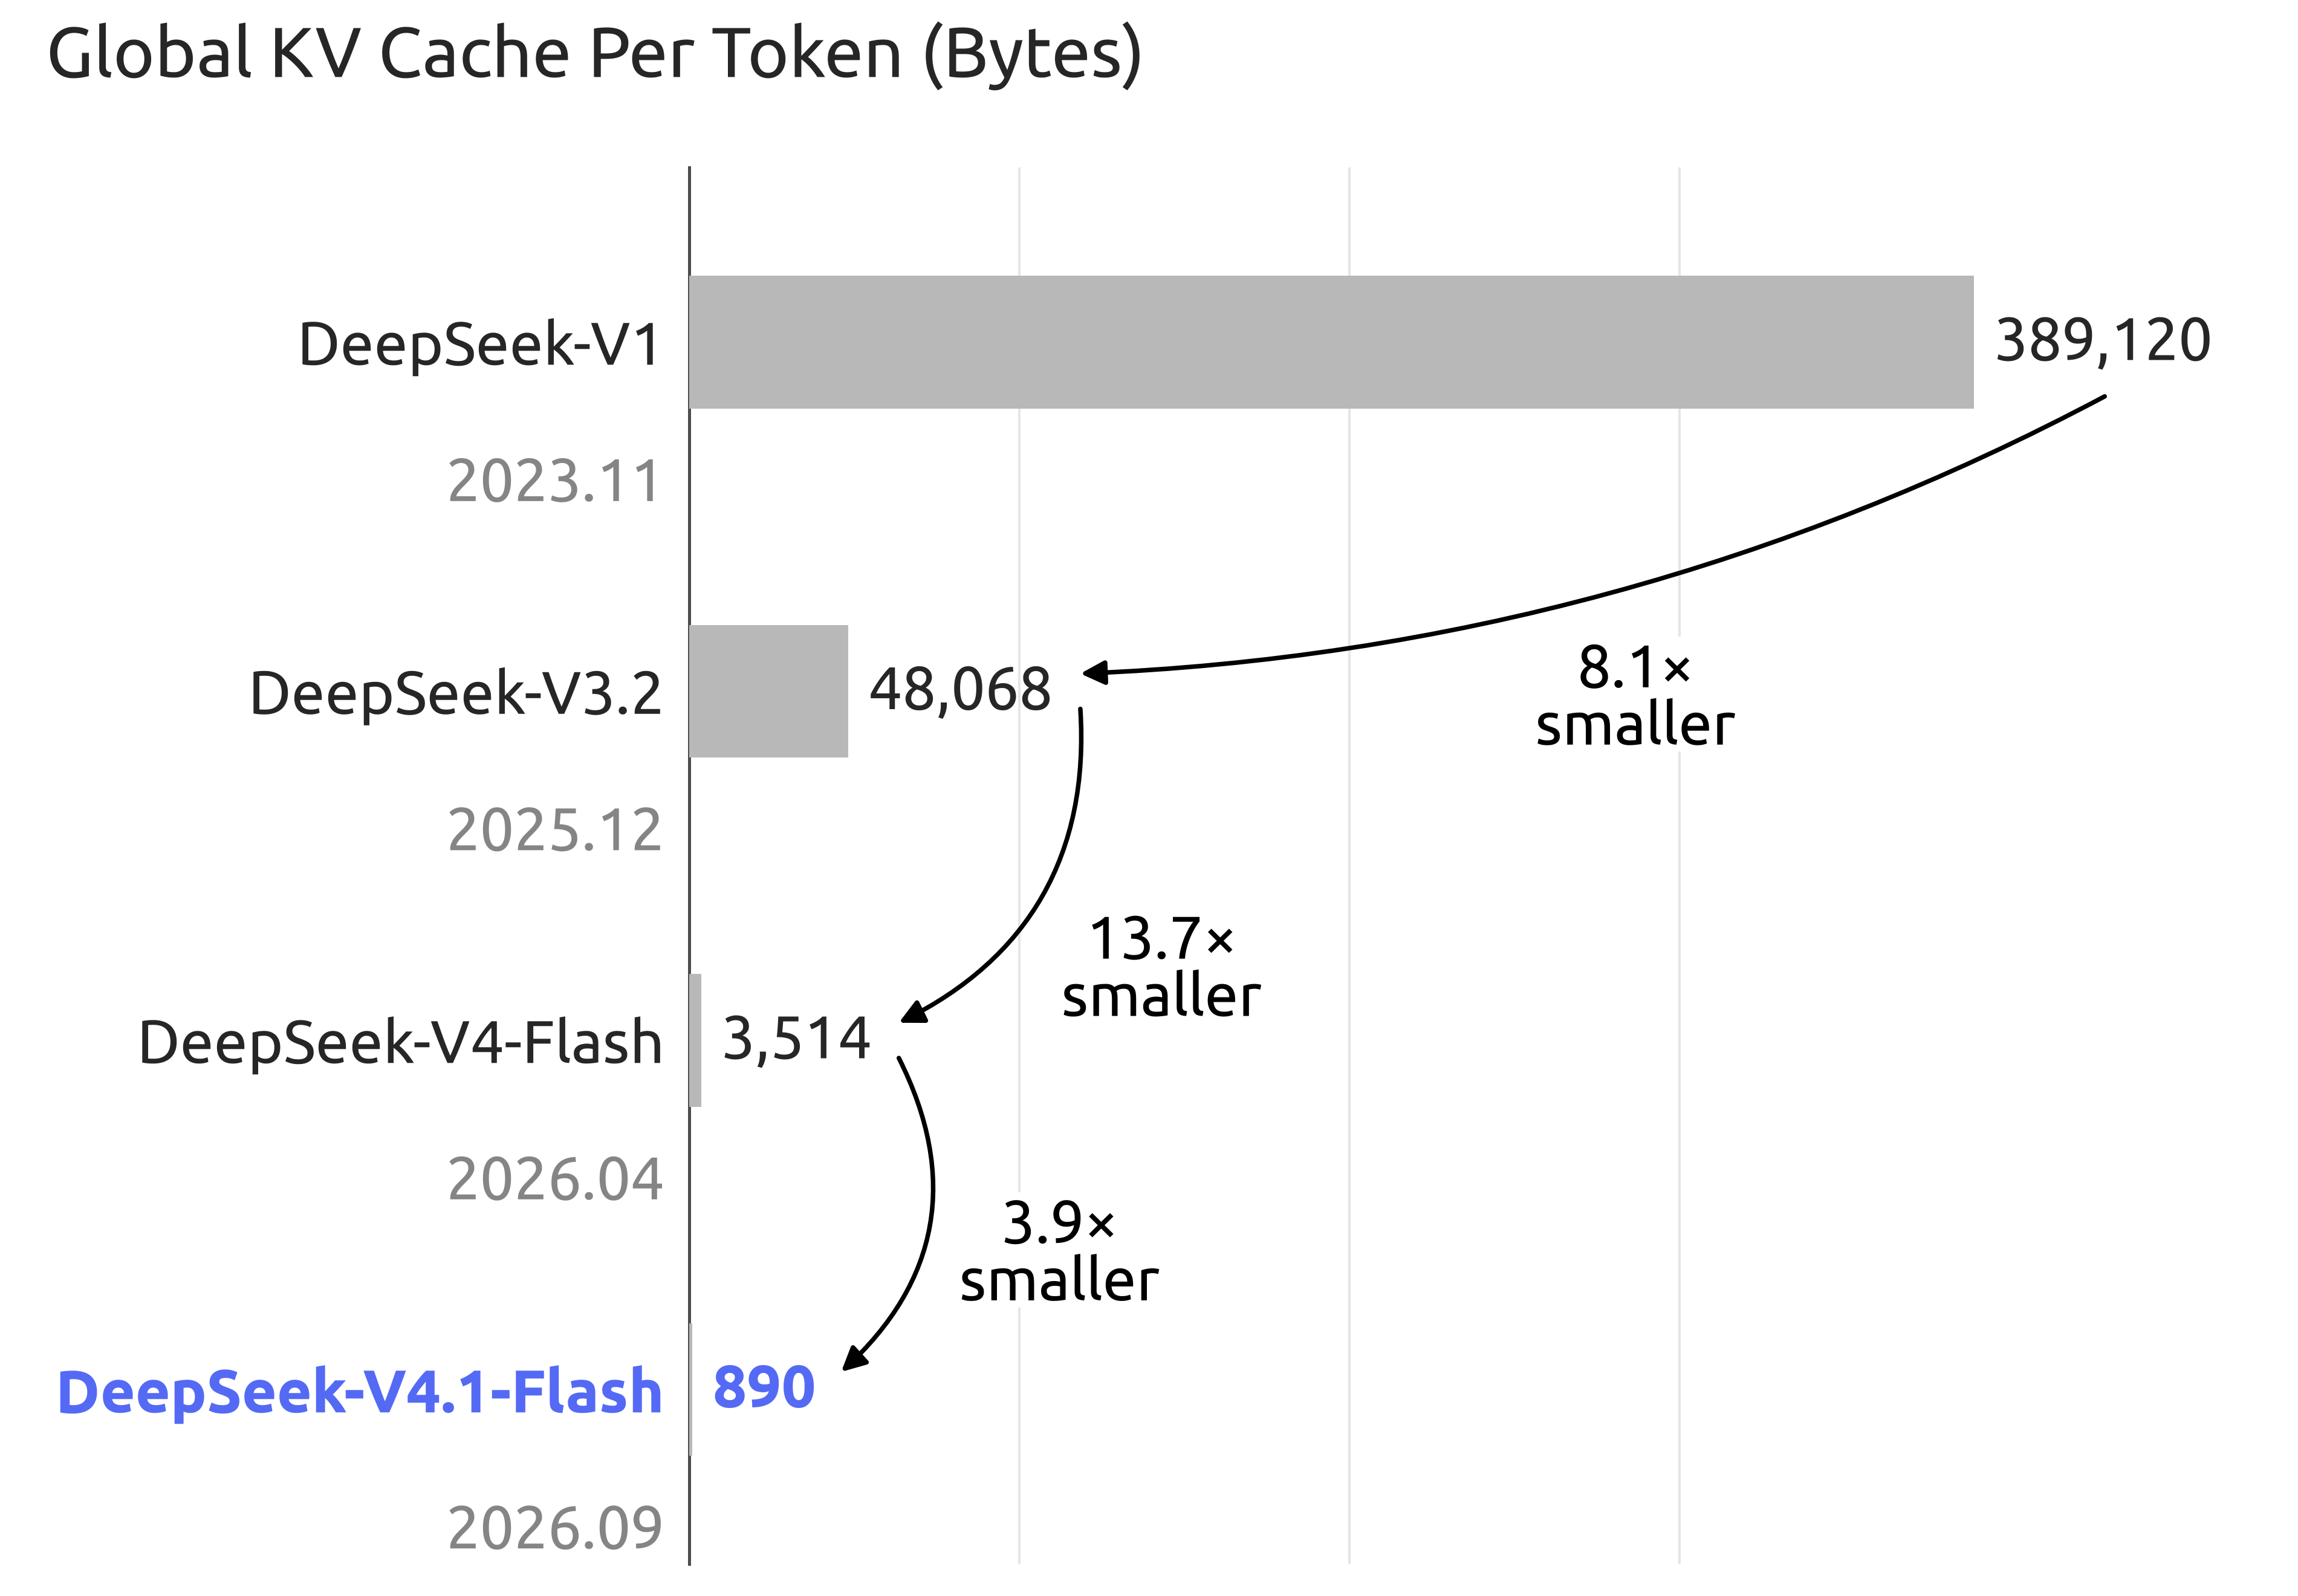
发布标题里「Pushing the Limits of KV Cache Compression」指向这个模型最硬的工程数字:全局 KV cache 压到每 token 890 字节。对比历代模型:DeepSeek-V1 是 389,120 字节,V3.2 降到 48,068 字节,V4-Flash 是 3,514 字节,V4.1 Flash 再降到 890 字节,相对初代累计缩小 437 倍。落到部署侧,官方给出的换算是:与上一代模型相比,HBM 需求降到 1/4,SSD 需求降到 1/8。
压缩由三项设计叠加完成:
CSA2(Compressed Sparse Attention 2)。每个注意力层被静态分配三种模式之一:Full、Reindex 或 Reuse。三种模式共享主 KV 和索引器 K,并复用 Top-K 稀疏注意力索引,避免每层独立维护一套缓存。解码器里还有一个层级稀疏索引器(Hierarchical Sparse Indexer),把后面的索引层限制在第一个 Full 模式层构建的候选池内,让更深层索引器的开销与上下文长度解耦。
FP4 主 KV 缓存。主 KV 用 E2M1 格式的 FP4 存储,每 16 个通道配一个 E4M3 scale。缓存位宽直接砍到四分之一量级,精度靠分组 scale 兜底。
SWA Bounded Replay。滑动窗口注意力(SWA)层的 KV 状态不再持久化到 SSD,需要时只重放最近 n_win 个 token 重建,把持久化 KV cache 的足迹降到上一代的约 1/8。对长上下文 Agent 任务来说,SSD 分层缓存正是成本和延迟的重灾区,这部分被直接拿掉了。
三项设计各管一段:CSA2 减少需要缓存的层数和索引开销,FP4 把留下的每字节再砍一半以上,Bounded Replay 把最冷的层级从存储层级里剔除。890 字节是三者相乘的结果。
Agent 成绩:DeepSWE 74.2 追平 Opus-5.0,大上下文场景领先全面拉开
智能水平是这次发布最大的争议点,也是官方敢于让 Flash 接棒 Pro 的底气。以下为 Hugging Face 模型卡中 instruct 模型(最大推理力度)的对比数据:
| Benchmark | Opus-5.0 | GPT-5.6 Sol | Kimi K3 | GLM-5.3 | DS-V4-Pro | DS-V4.1-Flash |
|---|---|---|---|---|---|---|
| GPQA Diamond | 93.4 | 94.1 | 92.9 | 88.1 | 92.4 | 90.9 |
| HLE(text-only) | 56.3 | 44.5 | 43.5 | 42.0 | 42.7 | 36.8 |
| Terminal-Bench 2.1 | 89.1 | 88.8 | 88.3 | 88.2 | 87.9 | 90.6 |
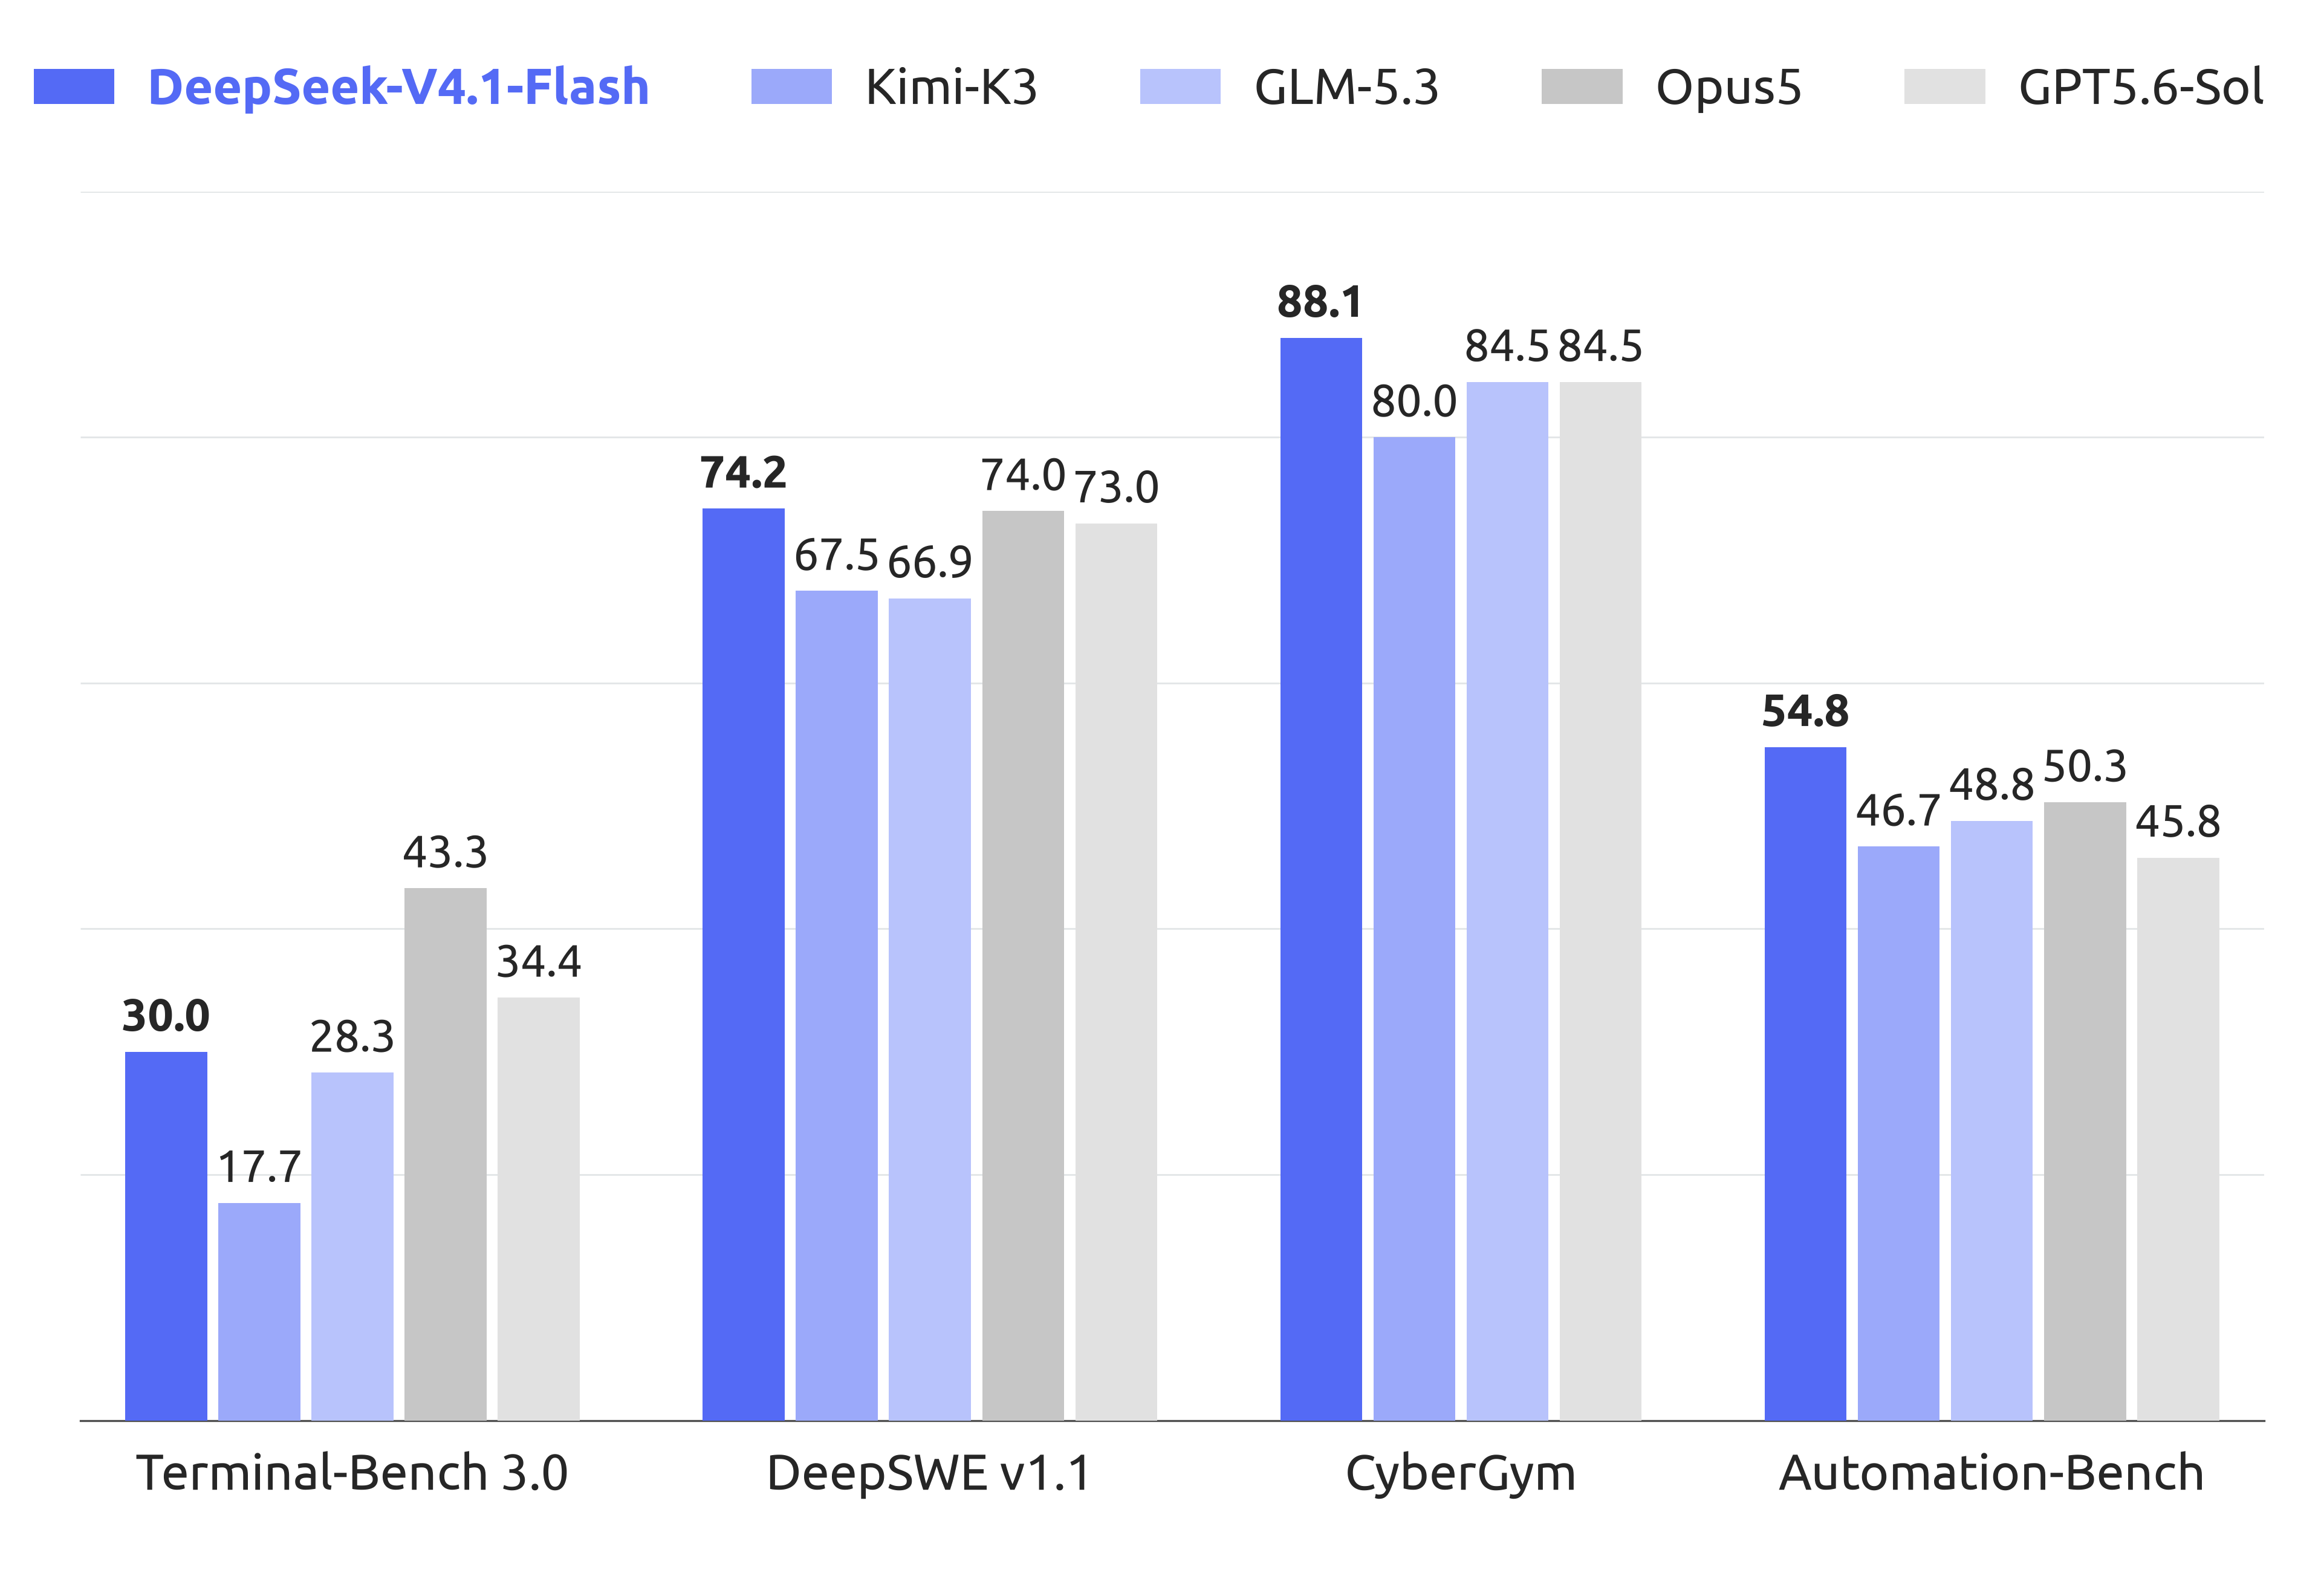
| Terminal-Bench 3.0 | 43.3 | 34.4 | 17.7 | 28.3 | 11.8 | 30.0 |
| Terminal-Bench 4.0 | 51.8 | 39.9 | 12.6 | 37.9 | 12.4 | 31.2 |
| DeepSWE v1.1 | 74.0 | 73.0 | 67.5 | 66.9 | 62.7 | 74.2 |
| CyberGym | — | 84.5 | 80.0 | 84.5 | 83.3 | 88.1 |
| AutomationBench | 50.3 | 45.8 | 46.7 | 48.8 | 43.2 | 54.8 |
| Agent's Last Exam | 28.6 | 26.7 | 27.6 | 28.5 | 25.7 | 31.8 |
| HLE(带工具) | 63.6 | — | 59.8 | 62.5 | 60.0 | 63.9 |
读这张表要把两个维度分开。纯推理维度(GPQA、HLE 无工具),V4.1 Flash 落后 Opus-5.0 十几个点,HLE 36.8 对 56.3 的差距是实打实的。Agent 维度则完全是另一番局面:Terminal-Bench 2.1 以 90.6 排在全部对比模型之首,DeepSWE v1.1 的 74.2 超过 Opus-5.0 的 74.0,CyberGym 领先第二名 3.6 个点,AutomationBench 和 Agent's Last Exam 均为全场最高。对比自家产品线,V4 Pro 在 Agent 榜单上全线落在 V4.1 Flash 之下(DeepSWE 62.7 对 74.2,Terminal-Bench 3.0 是 11.8 对 30.0),「Flash 全面超越 Pro」的官方结论在 Agent 负载上成立。
模型卡还给了一组脚手架鲁棒性数据:同一个模型在 Claude Code、Codex、OpenCode、mini-SWE 等八种脚手架下跑 DeepSWE v1.1,成绩从 65.6 到 74.2,极差不到 9 个点;Terminal-Bench 2.1 上八种脚手架的成绩区间是 84.1 到 90.6。模型能力对脚手架实现的敏感度不高,这让它对第三方集成方(腾讯 WorkBuddy、CodeBuddy、OpenCode 已全量接入)的适配成本更低。
大上下文评测补充了一个长尾:配备工具的 HLE 达到 63.9,是表中最高值,高于 Opus-5.0 的 63.6。1M 上下文加原生多模态在检索增强类任务上的收益,比裸推理榜单显示的更大。
开源与部署边界
权重以 MIT 许可证发布在 Hugging Face(deepseek-ai/DeepSeek-V4.1-Flash),发布后一个月内下载量 28.8 万次。仓库附带三份实用资产:自包含的 Python prompt 编码参考实现(含多轮对话、工具调用、思考模式、图片交错内容的测试用例)、提供同等协议能力的 Rust 库 deepseek-recipe,以及完整复现 DeepSWE v1.1 评测的 evaluation 目录。vLLM、SGLang 均已提供开箱即用的服务配置,官方推荐采样参数为 temperature 1.0、top_p 0.95,最大输出建议不低于 256K。
部署门槛需要按数字掂量:552B backbone 加 196B Engram 条件记忆模块,虽然每 token 只稀疏激活 8B/16B,但权重总量摆在那里,官方给大规模部署需求方预留的联系方式旁边写的前提是「2k 卡 GPU、有存储集群」。KV cache 的压缩改变的是同等 GPU 数量下的并发能力和上下文容量,权重本身的显存需求仍是大模型级别。对绝大多数使用者,现实路径是 API 或托管平台,自部署属于少数手里有千卡级资源的机构。架构层面 Engram(基于 token 查找的稀疏访问条件记忆)和 DSpark 投机解码(半自回归草稿生成加置信度调度验证)是两个值得单独跟进的组件,模型卡对它们的描述尚简略,论文链接发布时留空,细节要等后续技术报告。
从 V3.2 的 MLA 到 V4-Flash 的稀疏注意力,再到这一代的 CED 加 FP4 缓存,DeepSeek 三代连发都在做同一件事:把每 token 的固定开销往下压。这一代把「压缓存」做到了 890 字节,同时用 Agent 榜单证明小激活模型接得住旗舰的位置。V4.1 Pro 尚未发布,输入激活 8B 的 CED 结构能扩展到多大参数量,是这条产品线上下一个待验证的问题。