同一个 70B 模型,BF16 精度需要约 140GB 显存才能放下,4-bit 量化后只要 40GB 左右,推理吞吐还能再往上走一截。代价是精度损失,而损失的多少几乎完全取决于量化工具链的质量。NVIDIA Model Optimizer(ModelOpt)是 NVIDIA 把自家的量化、剪枝、蒸馏、投机解码技术整合成的开源工具库,2025 年 1 月开源,Apache 2.0 协议,目前是这个领域星数增长最快的项目之一。本文拆解它的技术结构、两个最新的核心算法,以及真实模型的量化结果。
项目定位:输入、优化、导出三段式
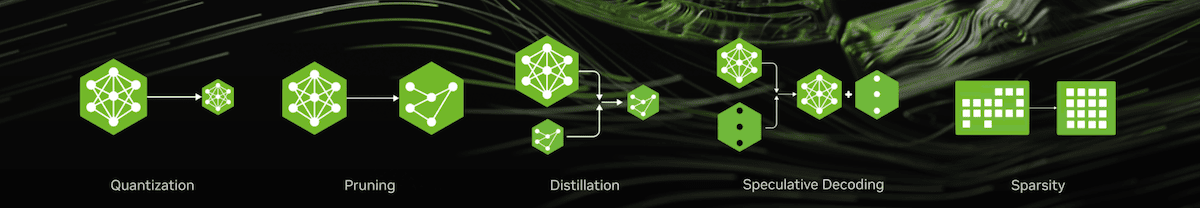
ModelOpt 的工作流分三段。输入端接受 Hugging Face、PyTorch 或 ONNX 格式的模型;优化端提供 Python API,把量化、剪枝、神经架构搜索(NAS)、蒸馏、投机解码、稀疏化这些技术组合起来;导出端把优化后的 checkpoint 交给下游推理框架,vLLM、TensorRT-LLM、SGLang、TensorRT 都在支持列表里,统一的 Hugging Face 导出 API 同时覆盖 transformers 和 diffusers 两类模型。
六类技术各自的位置:
| 技术 | 作用 | 典型收益 |
|---|---|---|
| 训练后量化(PTQ) | 不动训练流程,压缩权重精度 | 模型体积缩小 2-4 倍 |
| 量化感知训练(QAT)/蒸馏 | 用少量训练步骤找回量化损失的精度 | 极低比特下的精度恢复 |
| 剪枝 | 删除冗余参数 | 参数量与显存占用下降 |
| 蒸馏 | 用大模型教小模型 | 部署模型变小,行为保留 |
| 投机解码 | 训练 draft 模块预测额外 token | 解码延迟下降 |
| 稀疏化 | 只存非零参数及其位置 | 存储与计算量压缩 |
量化格式上,ModelOpt 覆盖 FP8、NVFP4、INT8、INT4,算法层面有 SmoothQuant、AWQ、SVDQuant、双量化,GPTQ 也在其中。NVFP4 是 NVIDIA 为 Blackwell 架构设计的 4-bit 浮点格式:每 16 个权重共享一个 FP8 block scale,权重本身用 E2M1 编码,能直接打 Blackwell 的 FP4 tensor core。
Local-Hessian:换一种算 scale 的方式,白捡回 2 个百分点
NVFP4 量化里有一个容易被低估的环节:block scale 怎么定。默认做法(max scaling)取每个 block 内 16 个权重的最大值来定缩放系数。ModelOpt 团队在 2026 年 9 月的博客里给出了改进算法 Local-Hessian,核心变化只有一个:不再最小化权重本身的误差,改为最小化矩阵乘法输出的误差。
对线性层 Y = WX,量化相当于先把权重除以 scale、舍入到低精度网格、再乘回 scale,产生的量化误差 Δ 依赖 scale 的选择。max 和 MSE 这类算法只看 ‖Δ‖ 本身,Local-Hessian 看的是 ‖ΔX‖,即这些误差经过真实校准数据放大之后在输出端造成的偏移。把输出误差展开,得到的二次型里出现输入二阶矩矩阵 XXᵀ——它正好是输出误差对 Δ 的 Hessian 矩阵的一半,作用是给每个权重坐标的误差加权,权重取决于该输入坐标实际能撬动多少输出。
精确求解需要在每个 block 的 126 个候选 FP8 scale 里做联合搜索,组合数不可行。Local-Hessian 用块对角近似:每个 16 权重的 block 独立优化自己的 scale,忽略 block 之间的误差交互,一个 Triton kernel 就能并行处理整层。这个近似在 GPTQ 一系的算法(OBS 谱系)里被反复验证过有效。
Qwen3.5-9B 全层 W4A4 量化的结果(数值来自 NVIDIA 官方博客):
| scale 选择方法 | MMLU | HellaSwag | WinoGrande | GSM8K | 平均掉分 | WikiText PPL |
|---|---|---|---|---|---|---|
| BF16 基线 | 78.69 | 78.04 | 73.40 | 87.64 | 0 | 9.20 |
| Max scale | 75.81 | 76.33 | 70.64 | 74.60 | 5.10 | 10.08 |
| MSE scale | 76.49 | 76.61 | 72.45 | 76.72 | 3.87 | 9.98 |
| Four-over-six | 75.32 | 76.62 | 70.40 | 76.42 | 4.75 | 10.02 |
| Local-Hessian | 76.81 | 76.50 | 71.19 | 80.89 | 3.10 | 9.90 |
最大的变化在 GSM8K:74.60 到 80.89,6.3 个百分点。数学推理对权重误差最敏感,而输出误差目标恰好压住了这部分损失。换 GPTQ 做舍入后组合还能再进一步,平均掉分从 3.10 降到 2.94。
成本结构上这个算法是零运行时开销的:scale 只在制作 checkpoint 时算一次,部署时直接复用,推理吞吐没有任何损失。不过组合不总是正向的,官方也给出了反例——Qwen3.8-27B 上 Local-Hessian 加 GPTQ 反而低于单独使用,最终发布的 checkpoint 只用了 Local-Hessian。算法选择存在模型依赖,这提醒使用者 benchmark 自己的模型而不是套用默认配置。
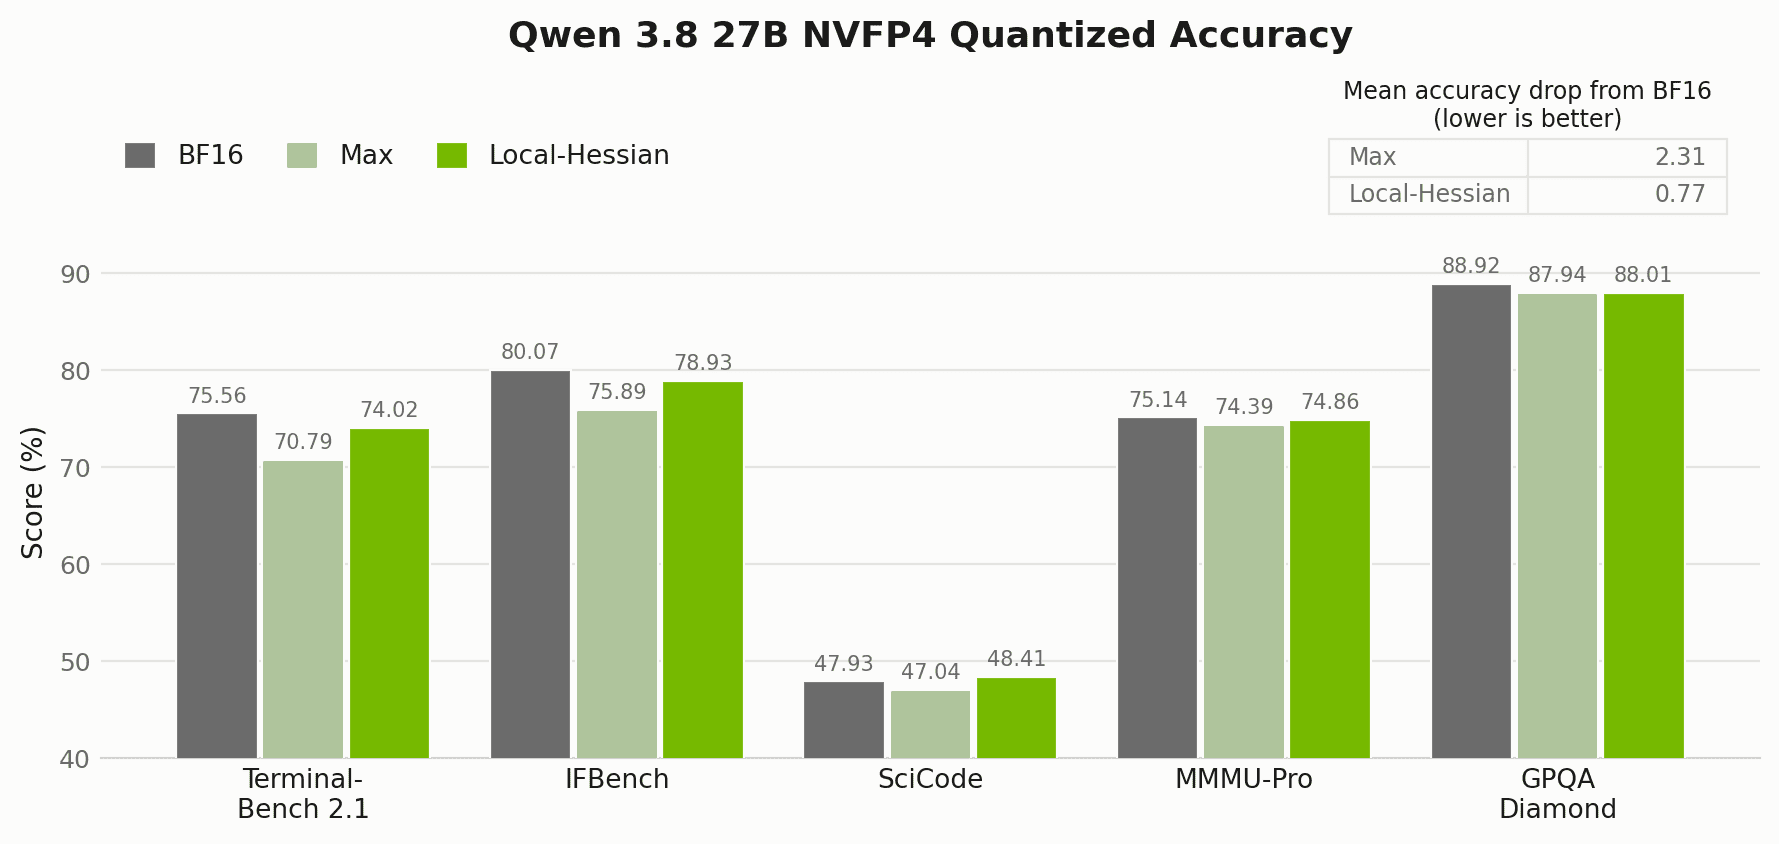
上图是 Qwen3.8-27B 在五个评测集上的表现:Local-Hessian 把平均掉分从 max 算法的 2.31 压到 0.77(该模型、该配置下的数值,与前表 9B 的 5.10→3.10 是两个不同实验)。
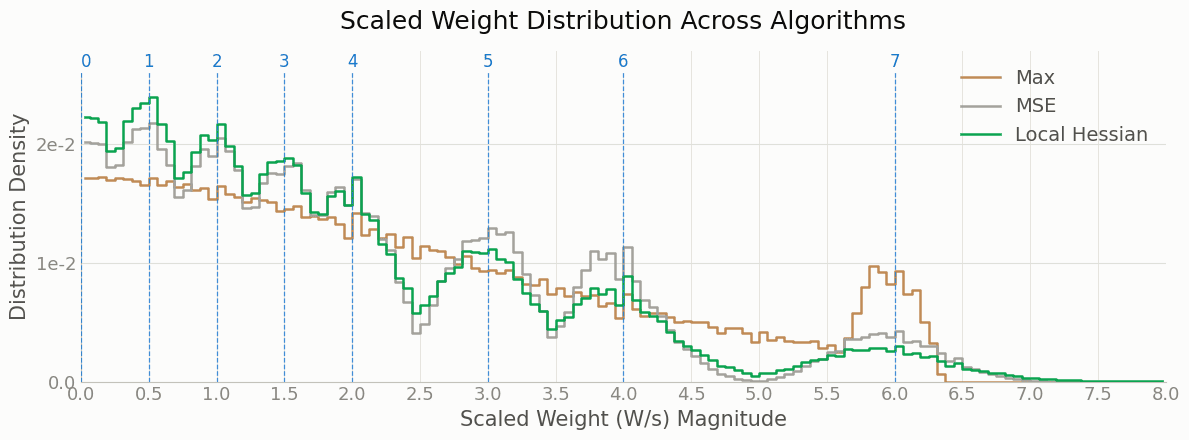
scale 的分布变化也能说明问题。max scaling 把 W/s 的质量堆到 6.0(E2M1 格点最大值)附近,MSE 和 Local-Hessian 则把权重对齐到可表示的格点上。对齐格点本身不足以解释精度差距——两种 MSE 类算法都对齐了格点,只有以层输出误差为目标函数的 Local-Hessian 拿到了最大收益。
AutoQuantize:混合精度分配交给了约束求解器
LLM 的量化冗余分布不均匀:attention 投影、网络末端少数几层对量化极度敏感,MoE 专家层则相当宽容。直觉上,只把少数敏感层留在 FP8 或 BF16、其余全部压到 FP4,就能保住精度同时拿到几乎全部的压缩收益。难点在于找出哪些层敏感——传统做法是对每个模型做逐层消融实验。
ModelOpt 的 AutoQuantize 用三步求解替代逐层手工消融。第一步打分:对每个算子估计量化的敏感度,用二阶泰勒展开近似损失变化,Hessian 用对角 Fisher(梯度平方)替代,把敏感度变成「输出误差 × 梯度平方」的加权,一次反向传播就能算完所有层。第二步算成本:用有效比特(NVFP4 计 4.5、FP8 计 8、BF16 计 16)建模每个格式的平均位宽成本。第三步求解:在用户给定的有效比特预算下,把「每个算子选一种格式、总成本不超预算、总敏感度最小」表述成整数线性规划(ILP),交给求解器找最优分配。
打分阶段的加速数字最能说明问题。直接测量法(KL 散度方案)每评一层要做一次全模型前向,复杂度 O(N²layers),在 Qwen3.6-35B-A3B 上敏感度估计要跑约 14 小时;AutoQuantize 的梯度评分是 O(Nlayers × Nformats),同样模型约 16 分钟,52 倍加速,峰值显存 29GB(4×RTX 6000 Ada,128 样本、序列长 512)。
工程细节上有一个容易被忽略的设计:部署约束感知。TensorRT-LLM、vLLM、SGLang 这些运行时要求耦合算子共享同一种量化格式——Q、K、V 投影必须一致,MLP 的 gate/up 投影必须一致,MoE 层的所有专家必须一致。AutoQuantize 直接把这些约束编进 ILP,把每组耦合算子当成一个联合决策,敏感度求和、成本求和。这样搜出来的分配方案导出后不需要再手工调整格式对齐。
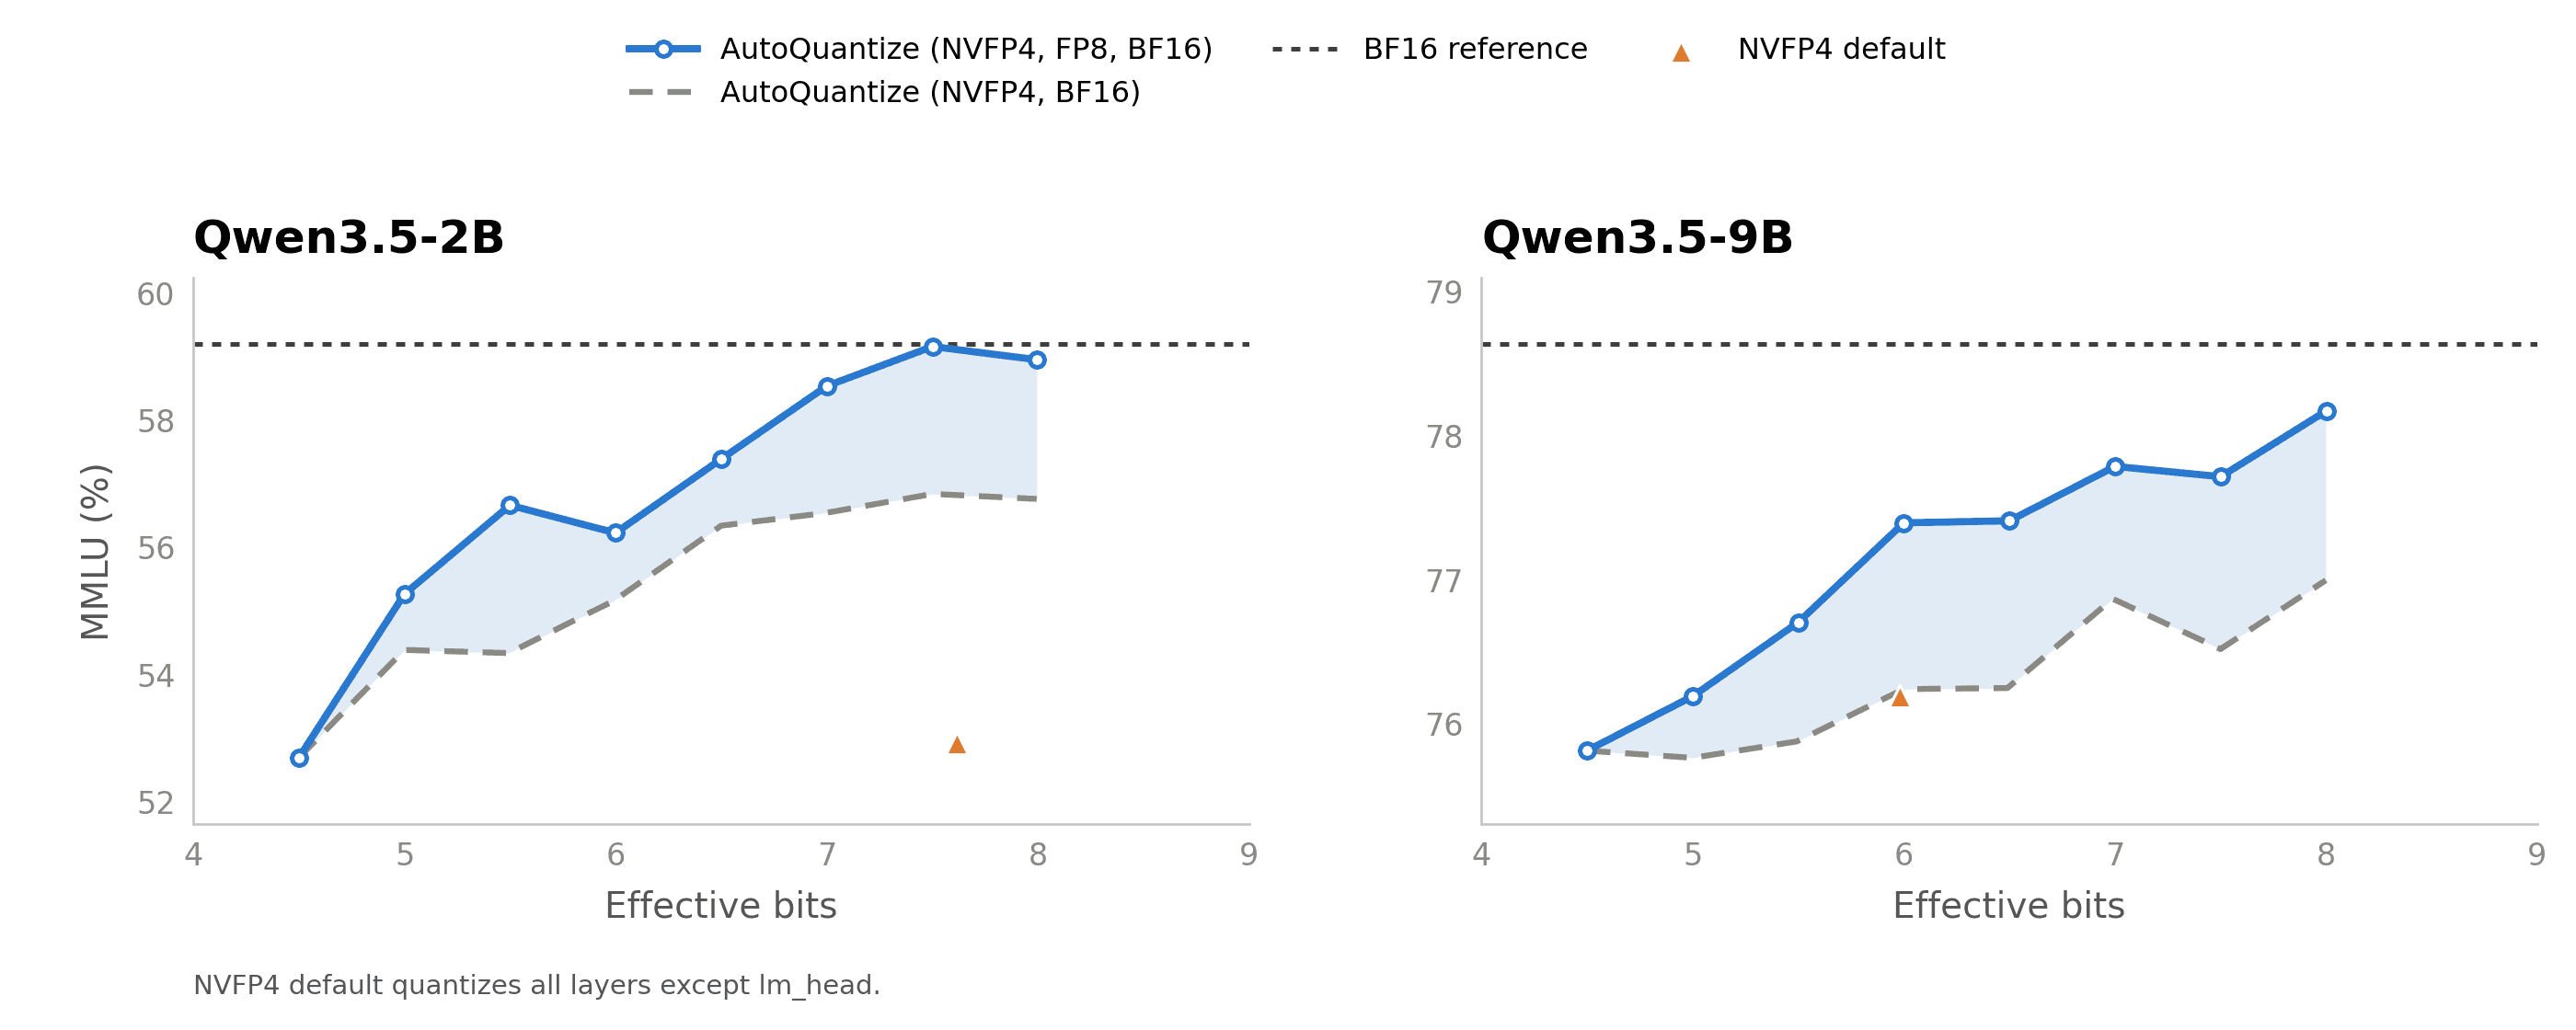
在 Qwen3.5-2B 和 9B 上的预算扫描曲线显示:同一预算下,菜单里同时放 NVFP4、FP8、BF16 三种格式的分配,在每个预算点都不差于只有 NVFP4+BF16 的组合。敏感层不需要直接退回 BF16,FP8 是更便宜的中间档。
全链路实战:从 550B 到端侧模型
这些技术组合起来的效果,官方给出的几条流水线数据:
Nemotron 3 Ultra 550B 用 ModelOpt 量化成 NVFP4,decode 密集型推理吞吐达到 GLM-5.1 754B FP4 的 5.9 倍,同时精度与 BF16 持平,checkpoint 在 Hugging Face 开放下载。Qwen3.6-35B-A3B 走 NVFP4 W4A4 PTQ 加量化感知蒸馏(QAD),vLLM 吞吐达到 BF16 的 1.30 倍,checkpoint 缩小 3.1 倍,W4A4 的精度损失被蒸馏步骤找回。Nemotron-3-Nano-30B-A3B 走剪枝加两阶段蒸馏加 FP8 量化,vLLM 吞吐 2.6 倍、显存占用降到 1/2.6。
两个第三方案例更接近普通团队的使用方式:欧洲模型 Domyn 用 Minitron 剪枝加蒸馏把 Colosseum-355B 压到 260B;波兰团队 Bielik.AI 做出 Bielik Minitron 7B,体积缩小 33%、速度提升 50%、保留 90% 质量。Adobe 用 ModelOpt 加 TensorRT 优化扩散模型,视频生成延迟降 60%,总体拥有成本降 40%。
上手路径与边界
安装是标准 pip 流程:pip install -U nvidia-modelopt[all],或直接用预装好的 NVIDIA 容器镜像(nvcr.io/nvidia/pytorch、nemo、tensorrt-llm)。HF 模型的 PTQ 一条命令完成量化加导出,官方发布的 Qwen3.8-27B NVFP4 checkpoint 复现命令里,校准配置是 512 条样本、序列长 2048、batch size 1。NVIDIA 在 Hugging Face 上维护了一个预量化 checkpoint 集合(DeepSeek-R1-FP4、Llama-3.3-70B-Instruct-FP4、Nemotron 3 系列等),不想自己跑校准的可以直接下载部署。
边界同样明确。NVFP4 的吞吐收益依赖 Blackwell 的 FP4 tensor core,Hopper 及更早的硬件主要走 FP8/INT8 路线。Local-Hessian 和 AutoQuantize 都还列着明确的下一步:稀疏 MoE 的低数据 regime 适配、量化误差的组合效应建模、用真实硬件延迟替代有效比特做成本函数。0.x 版本阶段 API 保持约一个月周期的弃用迁移窗口,生产环境建议锁定版本。
对自建推理服务的团队,这个库把「量化实验室工作」变成了「配置文件 + 一条命令」:敏感层自动识别、格式分配自动求解、导出直接对接 vLLM/TensorRT-LLM。精度敏感的场景,Local-Hessian 这类零推理成本的校准改进是目前性价比最高的一档——它只动 checkpoint 制作阶段,部署侧什么都不用改。
来源:
- NVIDIA Model Optimizer GitHub 仓库(README、Latest News)
- Improving NVFP4 Accuracy with Local-Hessian Weight Scales(NVIDIA 官方博客,2026-09-09)
- AutoQuantize: A Fast Automatic Mixed-Precision Assignment(NVIDIA 官方博客,2026-08-24)
- 模型量化:使用 NVIDIA Model Optimizer 进行后训练量化(NVIDIA Developer)