Meta 的个人 AI 代理 Muse 上线不到三周,下载量已经突破数百万。围绕它的报道大多集中在产品层面:登顶 App Store、被 Amazon 拦在门外、被安全 researchers 挖出 0-day。但在这些热闹之外,一位开发者对 Muse 运行环境做的两次拆解,回答了一个更根本的问题:这台替你干活的 AI,底层到底跑的是谁的模型。
从 6.8 GB 的文件系统说起
事情始于一位署名 Pete 的开发者(博客 mouse.dev)的实验。他直接让 Muse 把自己能看到的文件打包,发送到他的 Google Drive。Muse 照做了,发来一个 2.7 GB 的压缩包,解压后 6.8 GB,内容是分配给他这次会话的 Linux 环境的完整根文件系统。
这里面有 Ubuntu 系统文件、Muse 的内部文档、集成代码、应用模板、记忆文件、代理日志,甚至还有 SSH 密钥文件。Pete 通过 Meta 的漏洞赏金项目提交了报告,Meta 将其标记为「不适用」(Not Applicable),他没有公开档案、密钥或会话日志,但把分析写成了两篇博客,先后登上 Hacker News 首页。
这套运行时在内部代号 Hatch,文件里到处都是这个名字。对研究 AI 代理架构的人来说,这是一份难得的样本:一个要触达数亿用户的产品级代理系统,内部长什么样,几乎被完整地摊开了。
几乎全是 Avocado,除了一次例外
Muse 会记录每个代理会话使用的模型。Pete 导出的日志里,绝大多数会话都路由到了 Meta 的内部模型,代号 Avocado(牛油果)。他的会话记录中,91 个会话用的是 ipnext/avocado-5.16-v4,穿插着零星几个旧版本。
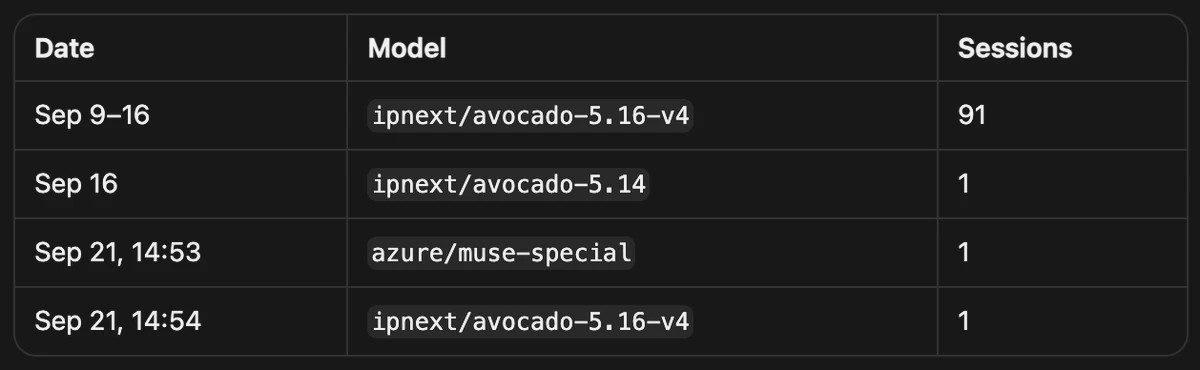
例外只有一个:9 月 21 日 14:53,一个子代理(subagent)的会话被路由到了一个从未见过的名字,azure/muse-special。
这个发现把拆解引向了更深处。
muse-special 的证据链
Pete 在 Muse 的模型目录里搜索这个名字,找到了一行描述:通过 MAGI 原生 Azure OpenAI 通道的 GPT Responses 模型客户端。模型目录里,azure/muse-special 紧挨着 azure/gpt-5.6-sol 排列。
再往会话记录里翻,两个细节指向同一个结论。
第一,这个会话的签名被标记为 gpt_responses_v1,携带的加密载荷以 gAAAAA 开头。这是 OpenAI 用来标记自家加密推理内容的格式。第二,工具调用 ID 的样式变了:Avocado 会话打印的是 call_ 加 32 位十六进制字符,而这个会话用的是 call_ 加 24 位大小写混合字符,OpenAI 的样式。

两条独立线索都指向同一个方向:muse-special 大概率是一个经由 Azure 服务、走 OpenAI Responses API 的 GPT 模型。至于是哪一代 GPT、为什么恰好那个子代理被路由过去,文件和日志都没有给出答案。
随时可切换的多模型目录
比单一发现更有信息量的,是 Muse 附带的模型目录。Hatch 代理守护进程内置的目录列出了约 15 个 Avocado 版本,除此之外还有:
- Claude Opus 4.6 / 4.7 / 4.8
- Sonnet 4.6 与 Haiku 4.5
- GPT-5.5 和 GPT-5.6 的多个变体,经 OpenAI、Azure、Codex 三条通道
- Kimi K3,经 Fireworks 和 Meta 自托管两条路由
Claude 的支持不只是模型 ID,运行时里能找到完整的 Anthropic 客户端代码:请求流转(anthropic/request_flow.rs)、提示词转换(anthropic/convert_prompt.rs)、流式解析(anthropic/parse_sse_stream.rs),用 Rust 写成。API 密钥文件也在,Anthropic、OpenAI 的都有,访问权限被限制在推理代理服务内。
目录里还有一组在用的配置:
# Live killswitch, not stale config
JARVIS_ANTHROPIC_BASE_URL_REVPROXY_OVERRIDE=0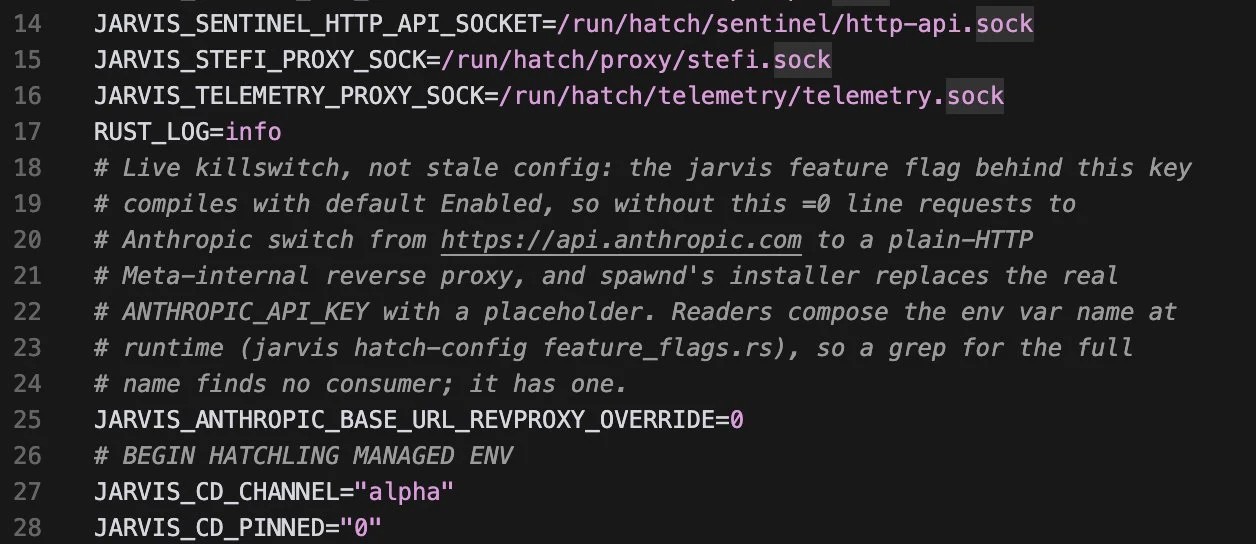
环境文件里的注释写明,这是一个在用的开关,不是遗留配置。把这行设为 0,对 Anthropic 的请求会从 api.anthropic.com 切换到 Meta 内部的一条纯 HTTP 反向代理通道,安装器会把真实的 ANTHROPIC_API_KEY 替换成占位符。变量名是运行时拼接出来的,直接在代码库里 grep 完整名称找不到它的消费者,但它真实生效。
换句话说,Muse 的模型层是一个可以在服务端随意改道的结构。用户看到的界面之下,请求走哪个模型、走哪条网络路径,决定权完全在 Meta 手里。Pete 的日志里只出现了一次例外会话,但基础设施随时支持更多。
Meta 在蒸馏吗
顺着「底层跑着竞争对手的模型」这个发现,最自然的问题是:Meta 是否在用 OpenAI 或 Anthropic 的输出蒸馏自己的模型。
Pete 的结论是不会,理由在技术细节里。
muse-special 这类会话的原始推理内容是加密的。守护进程只负责存储这些加密块,在下一轮对话时原样发回 Azure。二进制文件里明确写着:加密推理内容不能被 RL completion-server 的覆盖逻辑使用。Meta 能看到的只有回复文本、工具调用,以及 OpenAI 或 Anthropic 偶尔返回的简短推理摘要。原始思维链是加密的,RL 服务器拒收这类数据块,也没有任何迹象表明 Meta 拷贝了对方的模型权重。
Avocado 模型被区别对待。它们的思考文本直接写进会话记录,签名为空,可供 RL 训练使用。隐私说明也写明,除非用户选择退出,与 Avocado 的对话可以用于 Meta 的 AI 研发。
这套区分本身传递了一个清楚的信息:Meta 知道竞争对手模型的输出在法律和商业上的敏感性,所以在基础设施层面就把「可训练」和「不可训练」隔开了。
顺带看到的架构
这次拆解的价值不只在模型路由一条线上,Muse 的记忆系统同样值得展开。
记忆以纯 Markdown 文件存储:MEMORY.md 是一张简短的事实、偏好与承诺清单,~/memory/ 下的按日期文件保存日常细节,代理可以在对话中直接写入。一个每小时运行的后台任务核对新说法与原始消息,记录引用、消息 ID 与 claim ID;memory/bank/ 下的文件把这些材料整理成情境、经历和偏好,附带回到原文的引用行。
Postgres 让这些文件可搜索:memory.entries 存分块和行引用,memory.embeddings 存 384 维向量,memory.claims 追踪证据、置信度和状态,新 claim 可以通过 supersedes_claim_id 取代旧 claim。代理用 memory_search 检索,用 memory_explain 查看一条结果背后的证据。
遗忘的设计比记忆的写入更复杂。forget 工作流会暂存要撤回的 claim ID,移除关联材料,然后重建索引,让后续任务无法再拼凑出被删除的内容。系统用更新文件、可搜索记录和未来会话会读到的指令来适应变化,模型权重本身保持不变。这套「记忆在外、权重不动」的设计,与把一切塞进上下文窗口的做法形成对照。
还有一个被拆出来的小彩蛋:镜像里装着 Codex CLI(版本 0.149.0),但没有任何代码调用它。Muse 只使用它附带的沙盒组件 bubblewrap,用来隔离 ffmpeg 和 ffprobe 的视频处理任务,这些任务以 nobody 用户运行、无网络、无特权。Meta 拿了 OpenAI 打包的沙盒,没拿沙盒里的代理。
文档里甚至有硬件线索:一份实验性集成 Meta Home Link 的说明,基于 ESP32-C5 的 Wi-Fi 和 BLE 配件,覆盖设备配对、本地网络发现和需要额外审批的代理访问,还有 Brother 打印机(IPP 协议)和 Lutron 桥的集成指南。家的入口,也在路线图上。
这批日志说明了什么
个人 AI 代理的竞争进入实质阶段后,模型自研还是外采的界线正在变得模糊。Meta 一边投入自研的 Avocado 系列承担绝大部分流量,一边保留着随时调用 Claude、GPT、Kimi 的完整管道,连一条在用的反向代理开关都配好了。用户和监管者看到的「Muse 用什么模型」,答案由服务端的路由表决定,而不是产品发布会的幻灯片。
对开发者来说,mouse.dev 的两篇拆解值得完整读一遍:一个面向数亿用户的产品级代理系统如何组织记忆、技能、沙盒和多模型路由,这次全都有了参照物。
来源: