title: "Hindsight 技术解读:拿到 LongMemEval 94.6% 的 Agent 记忆架构" date: 2026-09-25 tags: [AI, 开源, Agent, Memory, Hindsight]
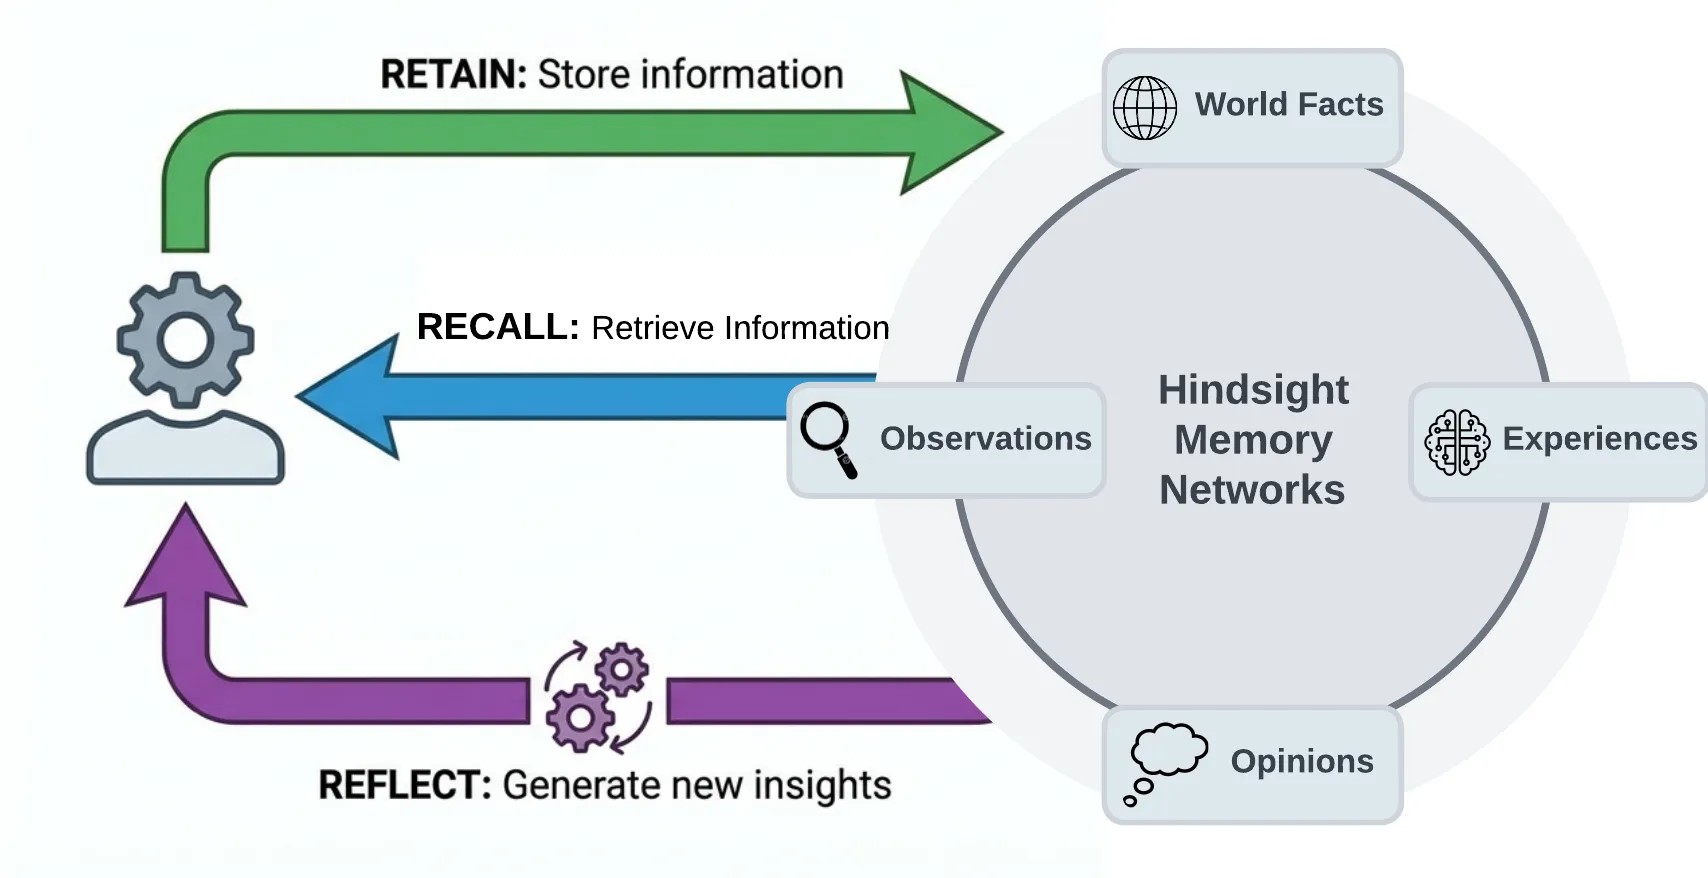
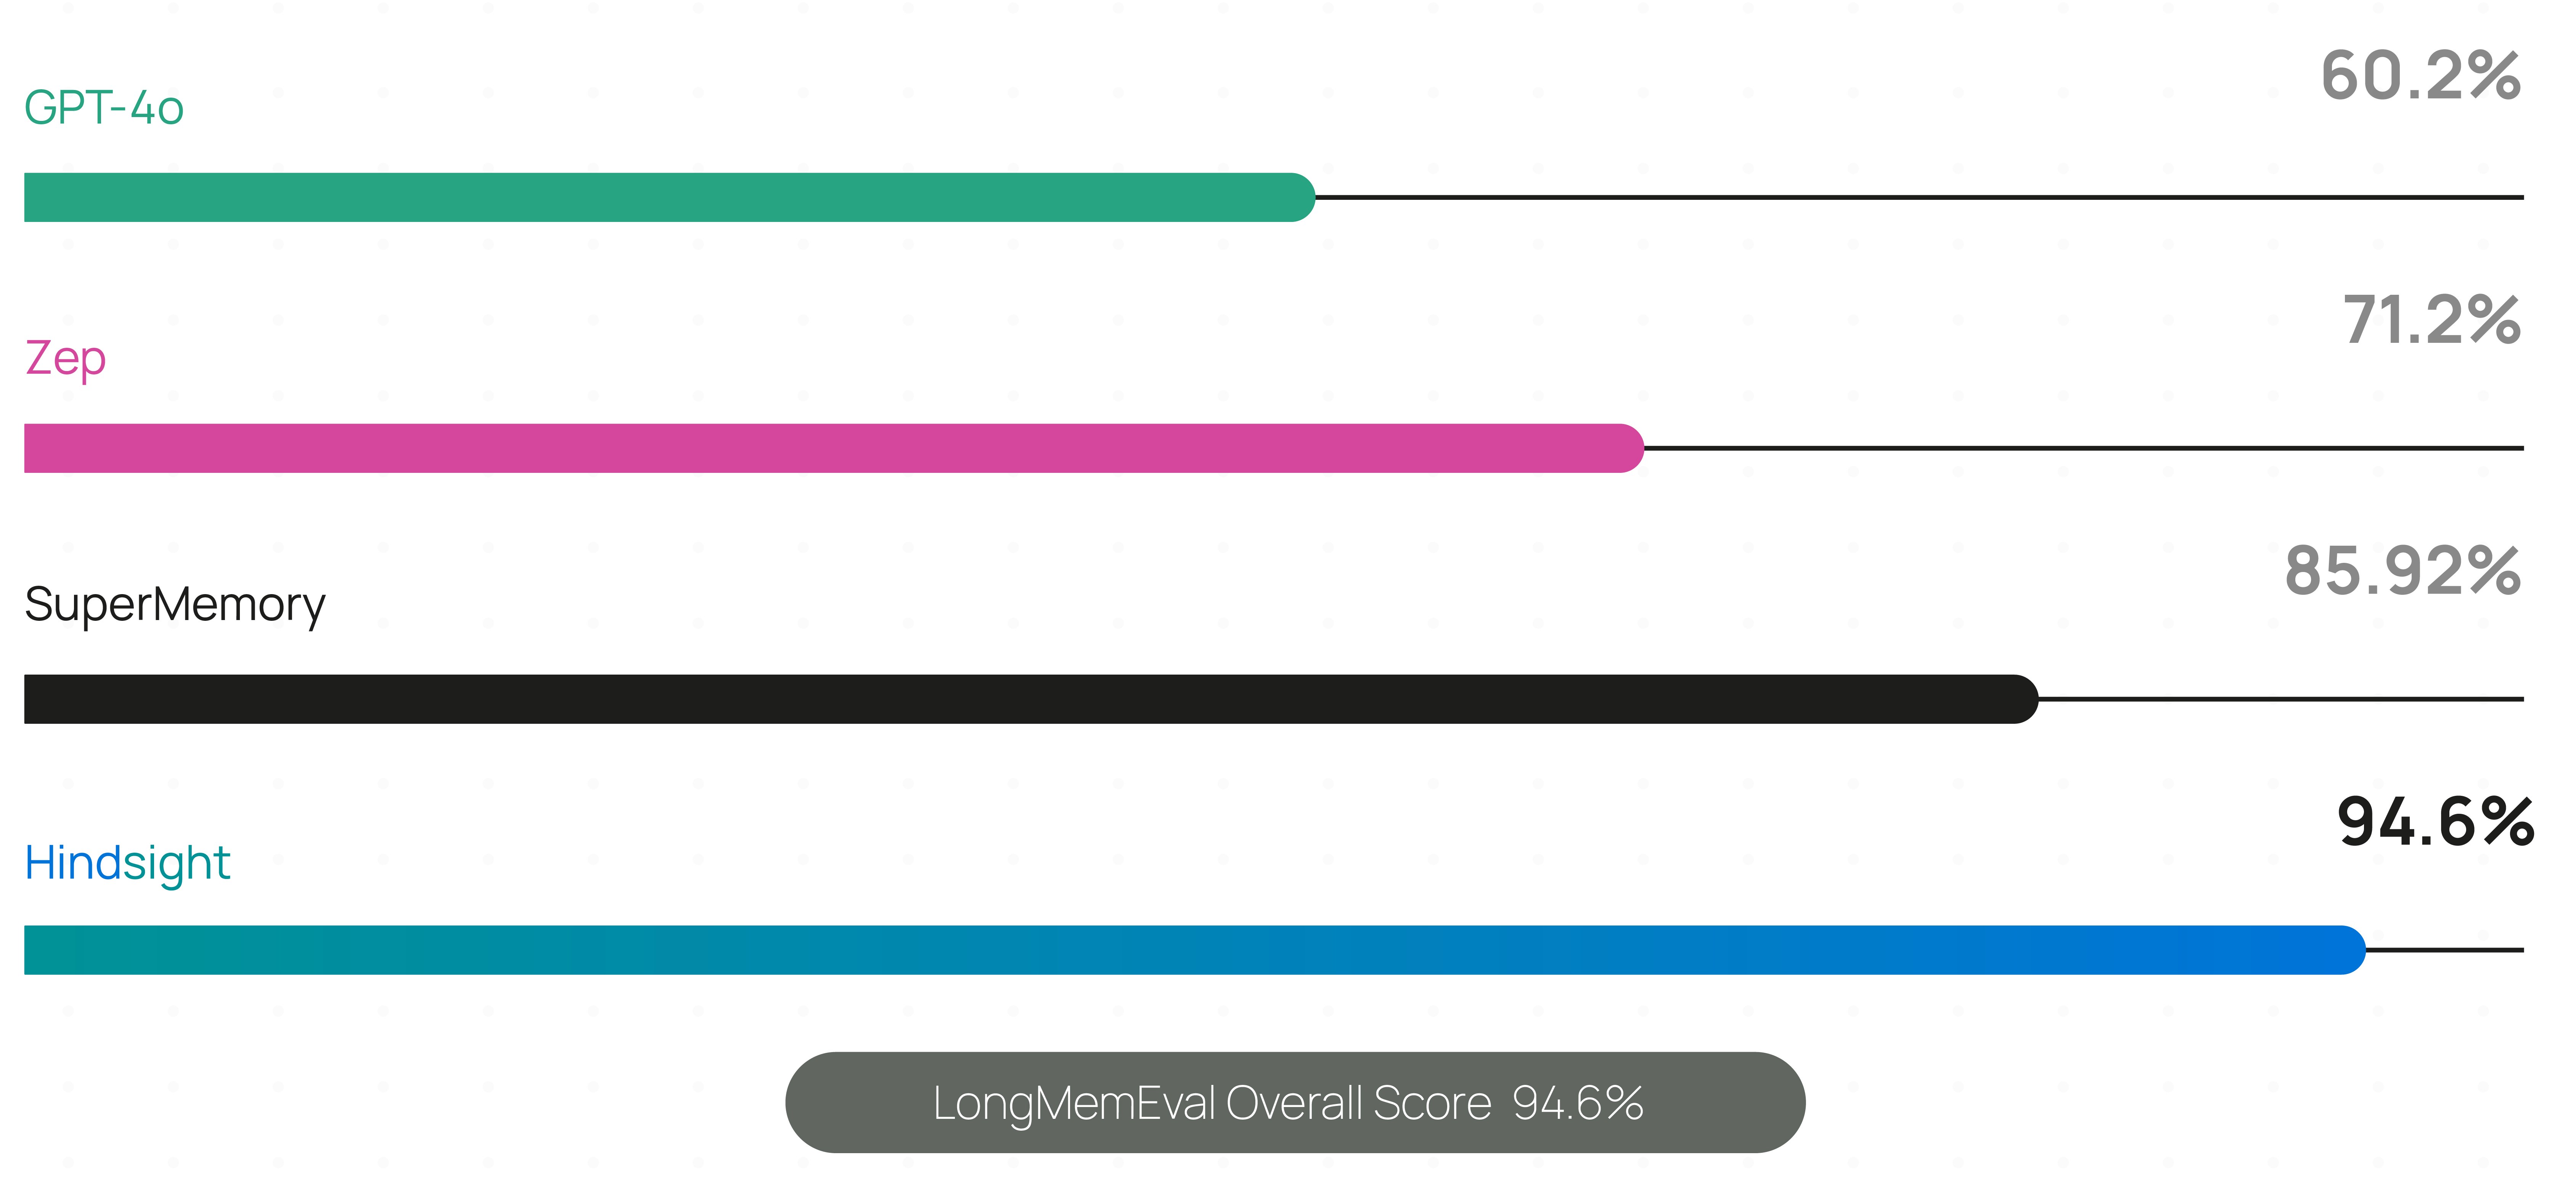
Agent 每开一个新会话就失忆一遍,这个问题的主流解法是把历史对话切片存进向量库,检索时取相似度最高的几条塞回提示词。Hindsight(Vectorize.io 开源,MIT 协议,GitHub 已达 2.7 万 star,单日新增 star 超过 1600)给出了另一套架构:把记忆当成一等地基而不是外挂缓存,用四张相互独立的网络组织信息,配合三个原语操作完成写入、检索和推理。它在 LongMemEval 长期记忆基准上拿到 94.6% 的总分,超过 SuperMemory(85.92%)、Zep(71.2%)和 GPT-4o 全量上下文(60.2%);论文版本(arXiv:2512.12818)里,同为 20B 开源模型做底座时,Hindsight 把整体准确率从全量上下文基线的 39% 拉到 83.6%。这篇文章拆它的四网络架构、三个操作、检索管线和证据合并机制,最后给出部署配置的取舍。
RAG 式记忆的三个结构性缺陷
先看被替代的方案。当前主流 agent 记忆实现(向量检索切片、知识图谱快照)共享同一条流水线:从对话流里抽取显著片段,嵌入后存入向量库,检索时按相似度取 top-k 注入无状态模型的上下文。论文把这条流水线的问题归纳为三点,每一点都能在工程实践中找到对应症状。
证据与推断不分层。「用户说过他在 Google 工作」(证据)和「用户大概是个工程师」(推断)在向量库里是两条平级的记录。当两者冲突时,系统没有机制判断哪条更可信,只能靠时间戳或向量距离做弱排序。会话越多,互相矛盾的「记忆」越多,检索质量随规模下降。
**长时程组织能力缺失。**向量检索天然只回答「哪条片段和查询相似」,回答不了「这个用户三月份的需求到五月份变成了什么」。时间维度、实体关系、因果链条在嵌入空间里都被压成一个点,跨会话的信息演化无从追溯。
**推理过程不可解释。**top-k 注入的片段没有来源标注,模型基于哪些记忆得出结论无法回溯。对需要审计的企业场景(金融、医疗),这是合规硬伤。
Hindsight 的回应是把这些能力做进存储层的结构里,而不是在检索层打补丁。
四张记忆网络:World、Experience、Observation、Opinion
Hindsight 把一个记忆库(bank)内部组织成四个逻辑网络,对应人类记忆里几种不同性质的内容:
| 网络 | 存什么 | 例子 |
|---|---|---|
| World facts | 关于世界的客观事实 | 「烤箱会很烫」 |
| Experiences | agent 自身经历过的事 | 「我碰了烤箱,真的很疼」 |
| Observations | 从多条记忆合并出的、带证据的信念 | 「该用户偏好简洁回复(8 条证据)」 |
| Mental models / Opinions | 对某个问题的常设答案,随记忆演化后台重写 | 「这个用户的画像」 |
关键设计在前两类与后两类的分离:world facts 和 experiences 是原始记录,只追加不修改;observations 和 mental models 是合成层,每一条都挂着支撑它的证据链。新证据到来时,合成层的信念被「精炼」而非覆盖——新信息可以强化、削弱或扩展一个既有信念,但原始证据始终可回溯。这直接回应了证据与推断不分层的问题:冲突不再靠相似度排序裁决,而是靠证据链的强度。
记忆库之间严格隔离(bank 级),没有跨库泄漏;每个 bank 还能配置倾向特征(怀疑程度、字面理解程度、共情程度),影响 reflect 推理时的立场。多语言默认保留原语言和字符集(「张伟」不会被规范化成 "Zhang Wei"),这对中文用户是实打实的细节。
三个操作:retain / recall / reflect
架构的外部接口只有三个原语:
retain(写入):输入原始文本,LLM 从中抽取事实、时间数据、实体和关系,经过规范化后写入四网络对应的索引。写入的产物是实体表、时间序列和稀疏/稠密双路向量表示的组合,为后续检索铺路。
recall(检索):查询时四路检索策略并行执行——语义(向量相似度)、关键词(BM25 精确匹配)、图(实体/时间/因果链接)、时间(时间范围过滤)。四路结果用倒数排名融合(RRF)合并,再过一个交叉编码器重排模型精排,最后按 token 预算裁剪。这一段是标准的现代检索管线,但四路并行保证了「三月份发生了什么」这类时间查询不会被语义相似度绑架。
reflect(推理):对整个记忆库做深度分析,用于回答「需要思考而非查找」的问题。README 给的例子:AI 项目经理反思项目上有哪些风险待缓解;销售 agent 反思为什么某些外联消息有回复而另一些没有。reflect 的结果会以可追溯的方式更新记忆库本身。
Benchmark:39% → 83.6% 意味着什么
论文的核心实验设计值得细看:同一个 20B 开源模型做底座,对比全量上下文基线和 Hindsight 架构。全量上下文意味着把所有历史对话原文塞进提示词,这是「大力出奇迹」的上限参照。结果:整体准确率 39% → 83.6%。全量上下文反而输,说明长时程任务里「把所有信息都给模型」不等于「模型能用好这些信息」——检索的结构化程度比上下文长度更关键。
换更大底座后,LongMemEval 到 91.4%,LoCoMo 最高 89.61%,对比「最强的先前开源记忆系统」的 75.78%。官方持续更新的榜单(benchmarks.hindsight.vectorize.io)当前显示总分 94.6%,领先 SuperMemory 8.7 个百分点、Zep 23.4 个百分点。榜单注明:Hindsight 的成绩由 Virginia Tech Sanghani 中心和华盛顿邮报的研究人员独立复现过,其余厂商分数为自报。这是少数把「谁测的」写清楚的记忆系统榜单,可信度分级明确。
另一组工程数字来自 v0.10.0 的发布日志:retain 流水线的峰值内存做到平坦化,从随文档线性增长改为常数占用,4MB 到 90MB 的文档用同一内存水位处理;分词器从 tiktoken 换成 quicktok 并默认 o200k_base。这些是让「一次写入」的成本可预测的底层改造,也是它敢说自己适合生产负载的底气。
部署形态与集成面
部署四条路:Docker 单容器(内置 pg0 嵌入式 PostgreSQL,数据卷持久化)、外接 PostgreSQL 的 docker compose、pip 装 hindsight-api 裸跑、Kubernetes Helm chart。存储层支持 PostgreSQL + pgvector 或 Oracle AI Database 23ai。模型侧 25+ provider,包括 ollama、lmstudio、llamacpp 三个纯本地选项,以及 openai-codex、claude-code 这类「用现有订阅不用 API key」的通道。
接入成本的分档设计:最省事的是 LLM wrapper,wrap_openai() 一行包裹现有客户端,记忆的存取全自动,底下走 LiteLLM 覆盖 100+ 模型;要精确控制时机就走 SDK/REST 直接调 retain/recall/reflect;CLI 编码 agent(Claude Code、Codex、Cursor 等 13 种)有专门包,按 git 历史和过往会话自动建 per-repo 记忆库;每个服务实例默认内建 MCP 端点(http://localhost:8888/mcp/{bank_id}/),任何 MCP 客户端可以把三个操作当工具挂载。
生产侧的清单也齐:Prometheus 指标、bank 级配置分层(全局环境变量 → 租户 → bank)、admin CLI(迁移、bank 修复、卡死操作清理)、webhooks(retain/合并/刷新生命周期事件)。一个值得单独点的功能是 Memory Defense:按 bank 开启的策略,对每条写入做 45 种模式的密钥/PII 扫描,命中后要么脱敏([REDACTED:github_token])要么直接拦在存储之外。记忆库是最容易漏敏感数据的组件(对话里什么都会出现),这个功能属于把安全做进了数据面。
边界与适用判断
两个诚实的边界。其一,论文的对比对象是「全量上下文」和「向量检索式记忆」,没有覆盖「模型上下文工程」路线(把关键信息结构化写进系统提示词,如 CLAUDE.md 类方案);对于信息量小、结构固定的场景,一个手写 markdown 文件仍然更简单。其二,LLM 抽取质量决定记忆质量:retain 依赖 LLM 抽取事实和实体,抽取模型弱,记忆库的噪声就高,这是所有 LLM-in-the-loop 记忆系统的共同约束。
适用判断随之而来:需要跨会话积累经验、按用户个性化、且要解释「为什么这么答」的 agent(AI 员工类、长期协作类)是它的主场;单次问答、无状态工作流用不上这套架构,README 自己也承认对简单 n8n 流程「可能过重」。
论文(arXiv:2512.12818)、文档、benchmark 榜单全部公开,仓库 MIT 协议,Hindsight Cloud 提供托管选项。2.7 万 star、单日 +1600 的增长速度,说明 agent 记忆这个方向正处在基建化阶段:模型能力的差距缩小时,谁记得住谁就赢。
来源:Vectorize.io Hindsight GitHub 仓库 · 论文 Hindsight is 20/20 (arXiv:2512.12818) · 官方 benchmark 榜单