2026 年 9 月 23 日,Anthropic 发布预印本《Autonomous AI agents discover reverse transcriptases with tandem repeat arrays》,同时宣布成立内部生命科学研究组。预印本记录了一次完整的无人工干预基因组挖掘:约 950 个 Claude 智能体在 21.5 小时内扫过 19.4 亿个宏基因组蛋白聚类,从 20 万个逆转录酶(RT)聚类中识别出一个未被描述过的酶系统。研究组把它命名为 ART(array-associated reverse transcriptases,阵列伴随逆转录酶),主要存在于感染细菌的巨型噬菌体中,由三部分组成:逆转录酶基因、旁边的专属伙伴基因,以及上游一串间距规律的 DNA 重复序列。这个布局令人联想到 CRISPR 阵列,MIT 和 Broad Institute 的 CRISPR 先驱张锋在读完预印本后的评价是"逆转录酶相关的 RNA 重复阵列确实引人入胜,值得进一步研究"。
整个挖掘过程中,人类的参与被压缩到两端:开头写一份研究简报,结尾做湿实验验证。中间的搜索、分类、跟进、筛选、写报告全部由 agent 完成,共消耗 2.156 亿 token、77 个 agent 小时。

ART 长什么样:一个带"RNA 文库"的逆转录酶系统
先补一点背景。逆转录酶的任务是把 RNA 反转录成 DNA,这类酶在细菌免疫系统中很常见,retron(一种细菌防御系统)里的 RT 会把一条非编码 RNA 反转录成单链 DNA,配合效应蛋白在噬菌体入侵时释放杀伤、让宿主细胞同归于尽。过去几年,研究者陆续报告了数十种 RT 系统,绝大多数靠基因组挖掘发现:在序列数据库里翻找没人注释过的基因,找出不寻常的,推测功能,再做实验。
Anthropic 的挖掘把这套流程推到了前所未有的规模。agent 先构建 52 个 RT profile HMM(隐马尔可夫模型)在 19.4 亿蛋白聚类里搜索,过滤后得到 198,290 个 RT 聚类,归类成九大类;然后对 10,983 个 RT 基因座做邻接基因普查,统计出 3,564 个在 RT 附近反复出现的蛋白家族作为候选伙伴;再对 16 个家族逐一深挖,期间 agent 自己又开了 98 个跟进任务,把第 17 个候选家族补进了名单。17 个候选里只有 3 个最终确认为前所未见的 RT 关联,其余 14 个被判定为注释伪影、已知系统或泛邻居。战役结束时产出 19 份报告,其中 3 份描述了全新的 RT 谱系,ART 是其中之一。
ART 的三个标志性特征:其一,RT 蛋白的 N 端异常长,约 180 个氨基酸位于聚合酶结构域之前,而已知 RT 系统的这个位置通常不超过 50 个残基;其二,RT 上游 0.3 到 4.1 kb 的非编码区里散布着 3 到 21 个短重复拷贝,每个重复 15 到 49 nt,带约 15 nt 的回文核心,重复之间的间隔序列长 120 到 220 nt 且彼此无关;其三,RT 下游紧挨着一个专属伙伴基因。在检出的 95 个 ART 相关 RT 聚类中,28 个带有可检测的重复阵列。
这套阵列与 CRISPR 阵列的相似和差异都足够明显。相似在于"重复 + 间隔"的串联布局——CRISPR 正是靠这种阵列存储一段段入侵者 RNA 记录,从而获得可编程性;差异在于 CRISPR 的间隔序列只有约 30 nt、在相近菌株间频繁增删,而 ART 的间隔长得多、在亲缘噬菌体间按顺序保守传递,且所有 ART 基因座附近都找不到任何 cas 基因。预印本据此判断这是一类未知的非编码重复元件,而不是 CRISPR 的某个变体。
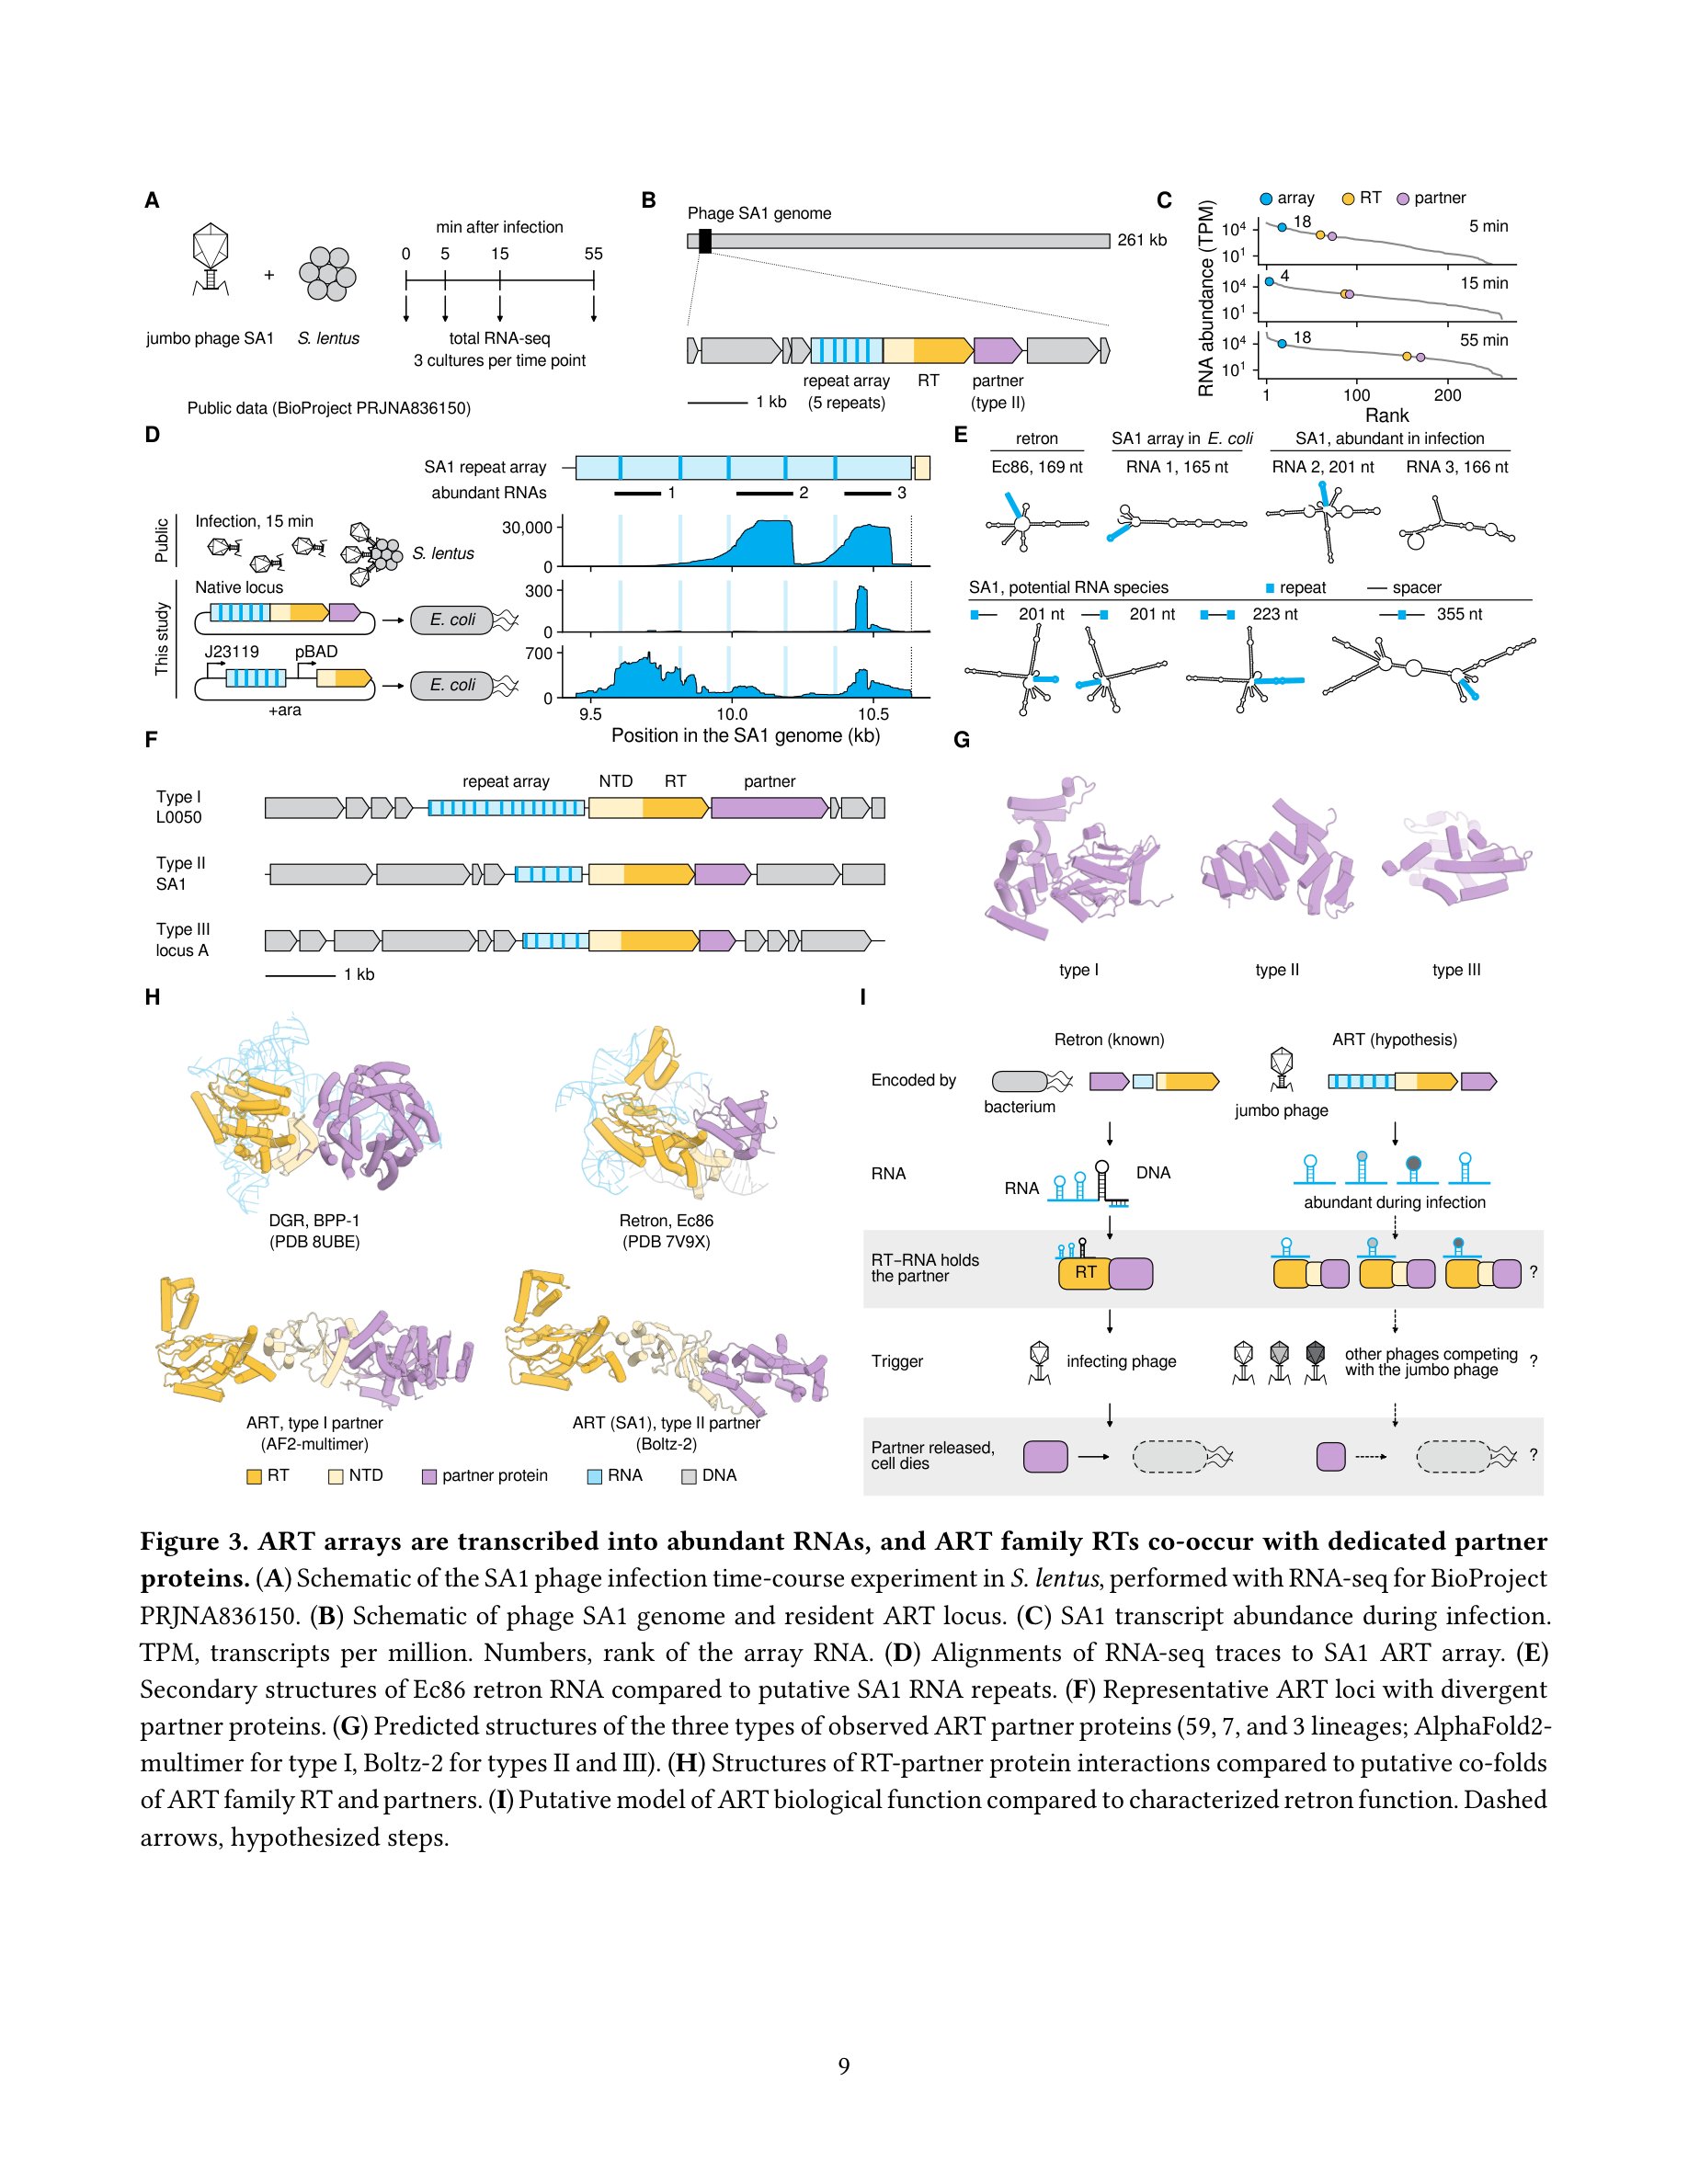
阵列不只是序列上的巧合。研究组调取了一项公开的金黄色葡萄球菌噬菌体 SA1 感染后不同时间点采集的 RNA 测序数据(BioProject PRJNA836150):感染后 15 分钟,来自 ART 阵列的 RNA 最高占到噬菌体全部 RNA 的 8%,跻身表达量最高的噬菌体转录本之列;把 SA1 的 ART 系统装进质粒在大肠杆菌里表达,小 RNA 测序同样看到一批边界清晰的短 RNA。也就是说,一条 ART 阵列会产出多种不同的短非编码 RNA,而 retron 只有一条专属 RNA。伙伴基因方面,三类彼此毫无序列相似性的伙伴家族几乎只出现在 ART 旁边:I 型约 600 残基、带两个 GNAT 类结构域,出现在 95 个基因座中的 59 个;II 型约 270 残基、全螺旋,局限于葡萄球菌噬菌体枝;III 型约 170 残基,只在一个环境亚枝里出现。结构预测显示 RT 的长 N 端与伙伴蛋白之间存在中等置信度的结合界面(ipTM 约 0.6)。预印本给出的工作假说是:每条单位 RNA 各自组装一套 RT-伙伴复合物,相当于一个酶配一个 RNA 文库,可能用来响应不同的触发条件——这套假说与 retron 的已证机制同构,但每一步都还没被实验证实。
那句"我用肉眼就能看到串联重复"是怎么发生的
回放会话记录可以看到发现的完整链条。某个 worker agent 最初注意到一类巨型噬菌体 RT 总是挨着 RNA 聚合酶 β 类亚基基因,后来判定这只是谱系特异的基因顺序,但它把这条 RT 排进了跟进队列。监督者让下一个 worker 检查 RT 上游有没有 retron 式的非编码 RNA:这些 RT 上游只有 27 bp 左右的中位非编码区,太短,编码不了 RNA;而它们的近亲上游中位长达 940 bp。worker 把近亲的上游 DNA 原始序列直接读进上下文,然后写下:
"The L0050 (228,907 bp logan contig) flank is spectacular: I can see by eye a tandem repeat array: CATGTGTATCGCATGTT / CATGTGTTTCGCATGT repeating many times with ~100-180 bp spacers — that's a CRISPR-like or msDNA-like repeat array?!"
接下来它做了一名人类科学家会做的事:写脚本数重复拷贝(在一个基因座上数出 14 份 16-nt 重复,间隔 100 到 200 nt)、和已知 RT 系统的布局逐一对比、检索文献确认没有任何已有报告描述过这种模式,然后提交报告给人类评审。这批基因座里的 MarsHill 噬菌体,其原始基因组报告曾识别出 RT 并猜测上游有非编码 RNA,却漏掉了重复阵列和伙伴基因——同一份数据,人写的注释与 agent 的重新检视之间隔着一个发现。
重跑 10 次全部错过:识别阵列的真正条件
预印本里最诚实的部分是可复现性实验。研究组把同一场战役原样重跑了 10 次:几乎每次都能采到 ART 基因座,两次有 worker 把这个谱系当跟进对象研究,但没有一次去读 RT 上游的 DNA,阵列在所有重跑中全部漏网。研究组的解释是 RT 搜索空间太大,加上 harness 的非确定性行为。
于是他们改做固定输入基准测试:把 ART 序列直接放进模型上下文(无工具),或作为文件配分析工具,让 7 个 Claude 模型各跑 100 次描述任务,用裁判模型对照 10 条家族特征打分。结果出现了一个清晰的能力分界:Opus 5.5、Mythos 5.1、Mythos 5、Opus 5 四个最强模型显著领先 Opus 4.6、Opus 4.8、Sonnet 5。
反直觉的发现藏在工具维度上。直接把基因座放进上下文时,最强模型对阵列的识别率至少 90%;改成文件加工具后,识别率反而跌到最低 32%(Opus 5,第 4 级信息)。检查会话记录找到了原因:配工具的尝试里有 39% 从未把一段 200 nt 以上的连续 DNA 读进上下文,模型根本没"看见"完整的重复单元。把读入量与识别率挂钩后规律浮现:读过至少 200 nt 连续序列的尝试,识别率提升 16 到 32 个百分点;四个最强模型合并在读入 2,000 nt 以上时识别率达 76%,Mythos 5 单模型达到 96%。识别的关键前提是把原始数据直接读进上下文,工具调用本身替代不了这一步。
模型内部发生了什么:两个只对重复序列放电的信号
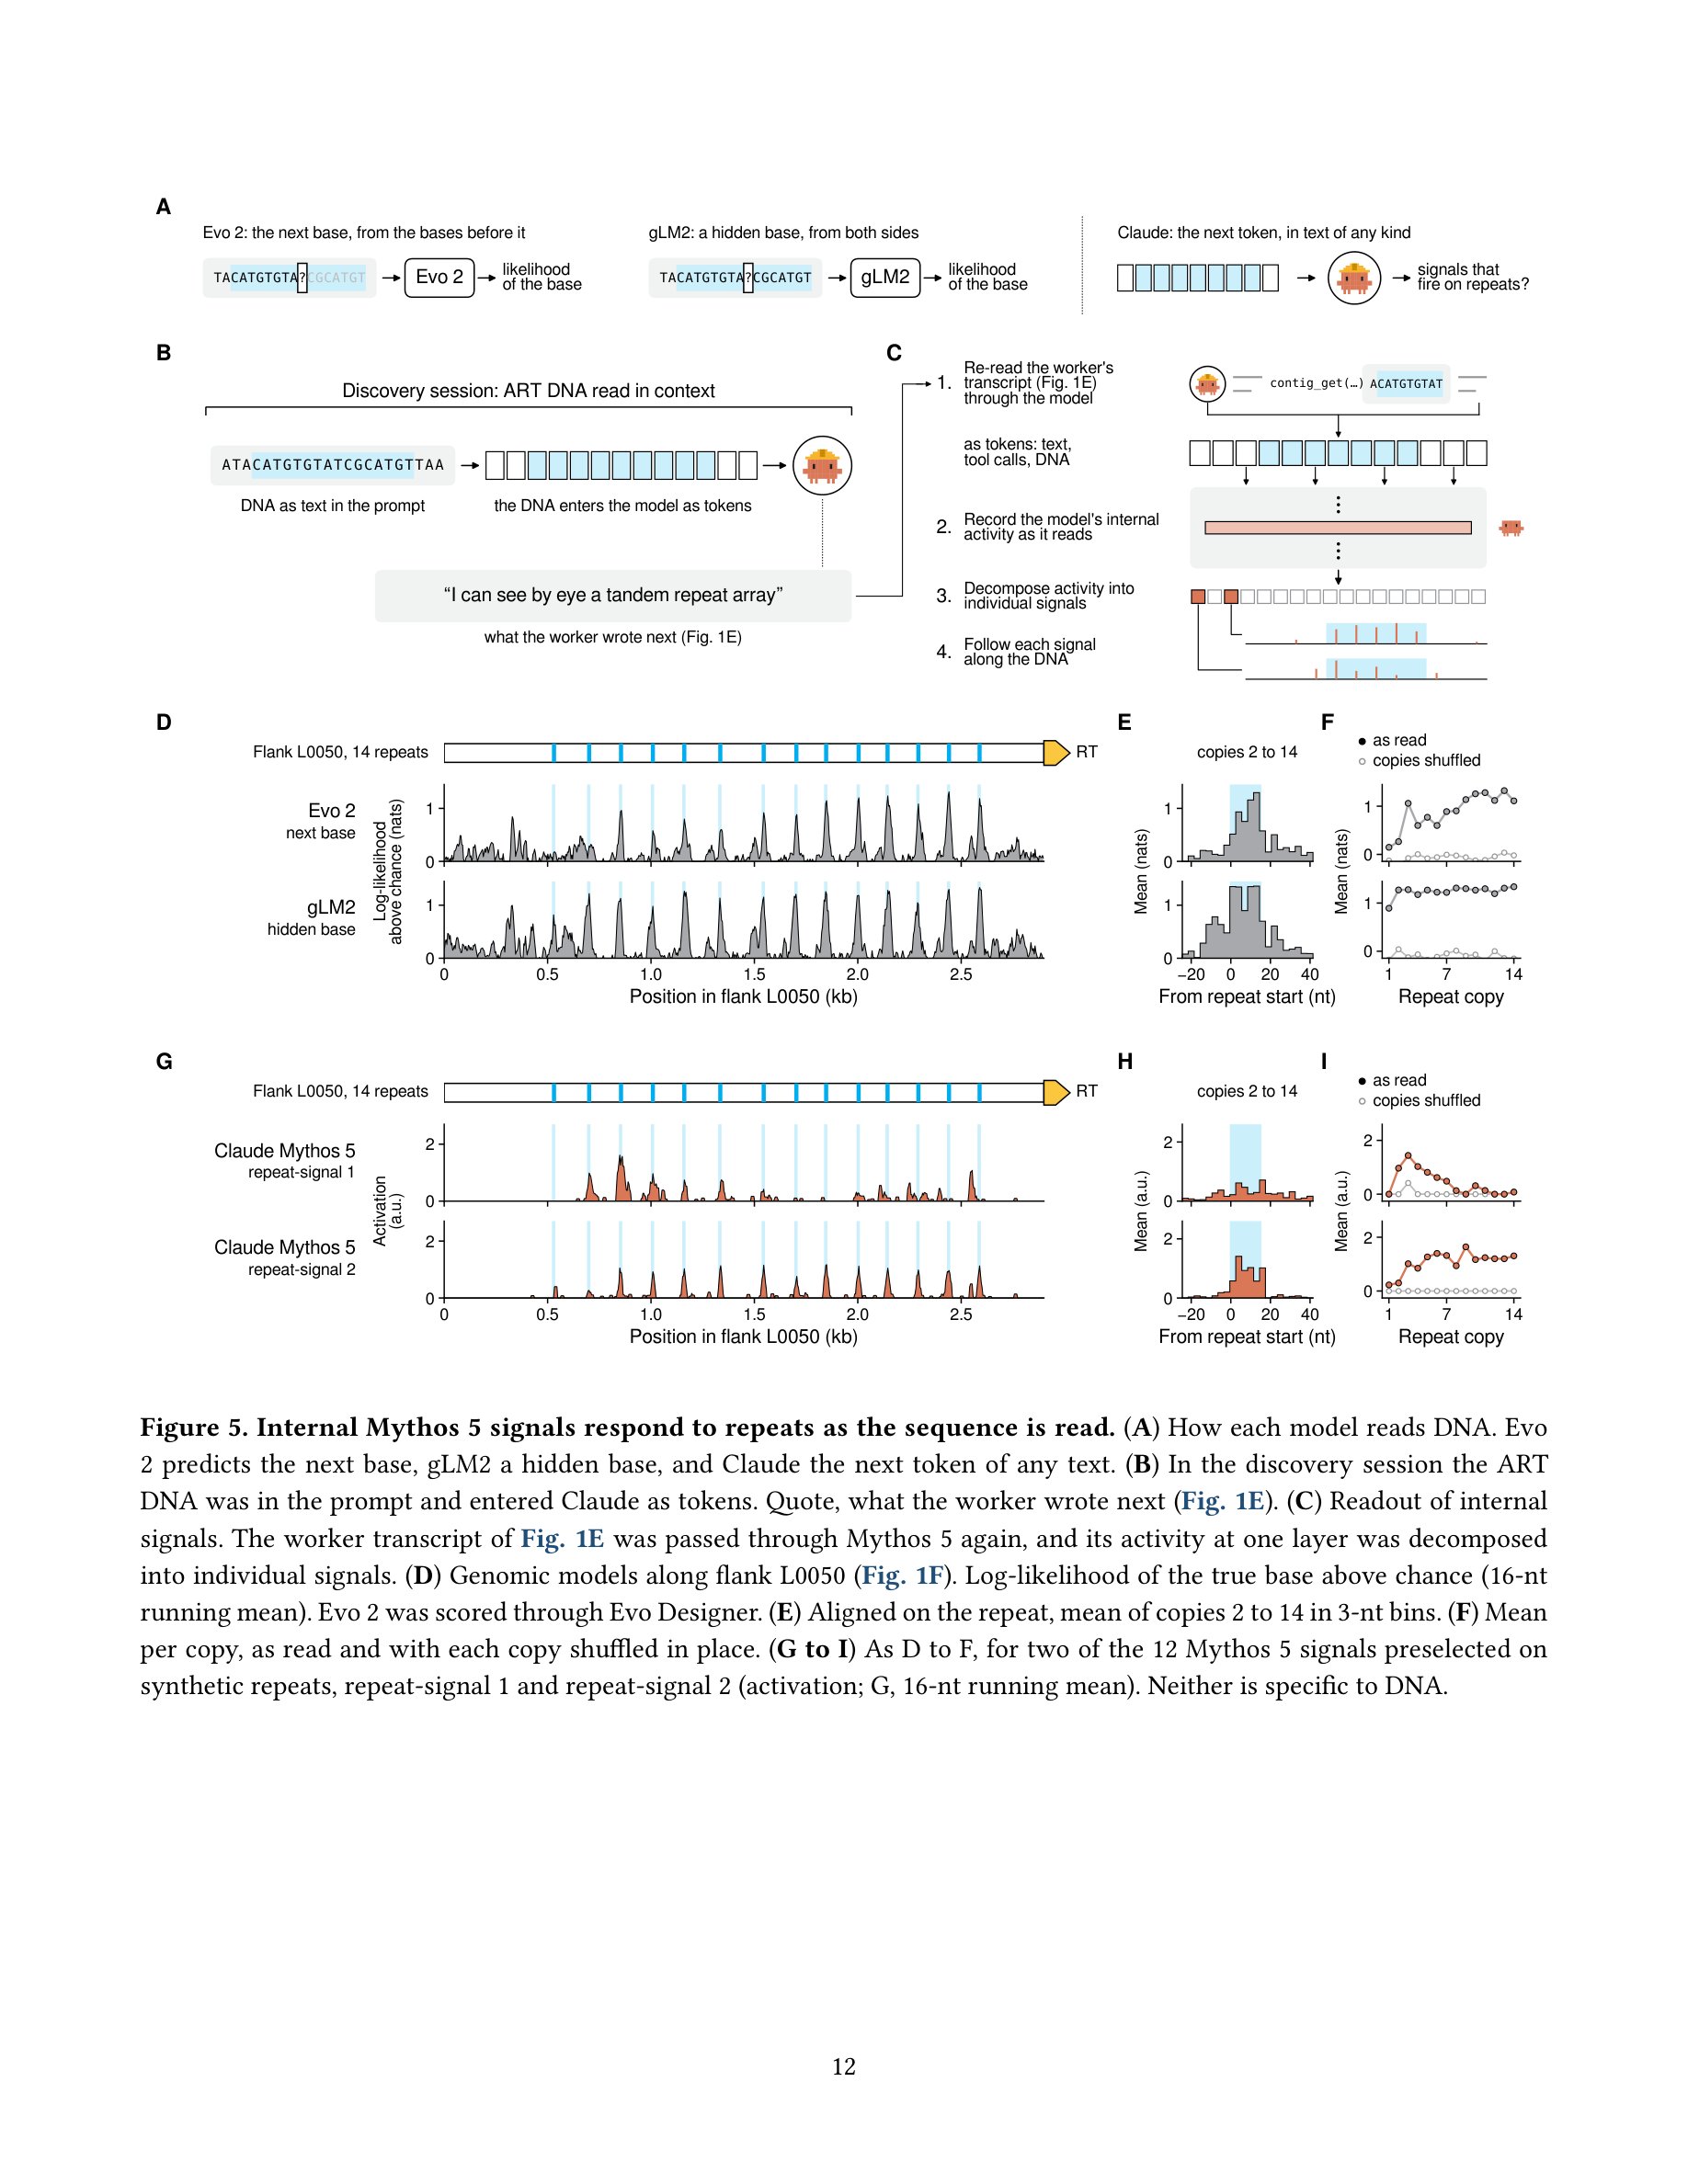
预印本进一步做了可解释性分析。先看专用基因组模型:Evo 2 和 gLM2 在 L0050 基因座上的对数似然曲线在 14 个重复位置全部出现峰值,把每份拷贝原地打乱后信号消失;gLM2 因为双向读序能预测包括第一份在内的所有拷贝,Evo 2 只能靠前文预测,对前两份拷贝束手无策。
再看 Claude 自己。研究组把当年的发现会话 transcript 重新喂给 Mythos 5,把某一层的内部活动分解成 12 个在合成重复序列上预筛过的信号,其中两个对 ART 阵列有反应:repeat-signal 1 在第三份拷贝处达到峰值后沿阵列衰减;repeat-signal 2 从第三份拷贝起增强并保持稳定,活性集中在重复本体及其后一个核苷酸。把每份拷贝原地打乱,repeat-signal 1 在 14 份拷贝中的 12 份上熄灭,repeat-signal 2 在全部 14 份上熄灭。信号放电之后紧跟着的,就是那句"我用肉眼就能看到串联重复阵列"。一个通用语言模型在纯文本 token 流上读 DNA 时,内部形成了与专用基因组模型同型的重复检测响应,这个响应直接触发了发现。
边界:这次发现没有证明的事
预印本对未证事项的列举同样清楚:ART 的 RT 酶活性没有被证明;阵列 RNA 是不是 RT 的底物没有被证明;RT 与伙伴蛋白是否真的相互作用、ART 对噬菌体有什么功能、触发条件是什么,全部未知。19.4 亿个聚类的普查也只覆盖了 RT 这一族酶。实验平台的边界同样写明:实验室只做 BSL-1 和 BSL-2 级别的工作,不接触能感染人类的病原体,所有湿实验由人类科学家执行。
数学领域的 AI 发现阶段,结论可以由模型自行验证;生物学的每个假说都要落到实验台上。Anthropic 选择在这个阶段就把中间结果公开,功能研究还在进行中。对工程侧的读者,这次战役留下了两件可复用的东西:一套 harness 模式——worker 提计划跑任务、supervisor 审查并开跟进任务、curator 维护共享知识库、editor 按锦标赛制评审报告,119 个任务里 98 个由系统自己派生,这套结构适用于任何"在噪声里找异常"的长任务;以及一条基准测试得出的经验——让模型直接观察原始数据,比给它更多工具更重要。MarsHill 的注释者没有看到的阵列,被一个把序列读进上下文的模型看到了。
来源:Anthropic 官方博客 "Claude discovers a novel enzyme system with CRISPR-like repeats"(2026-09-23);预印本 "Autonomous AI agents discover reverse transcriptases with tandem repeat arrays"(Yoon, Athukoralage, Ameisen, Kauderer-Abrams, Perry, Durrant, Anthropic)