9 月 22 日,Hacker News 上一个标题拿到 393 分热度:「Claude discovers a novel enzyme system」。点进去会发现链接指向的是 Apple 在 Hugging Face 上新放出的模型权重:LensVLM-9B。这个时间点适合作一个参照:同一个 9B 视觉语言模型(Vision Language Model,能同时理解图像和文本的多模态模型,下文简称 VLM),论文 5 月挂在 arXiv,权重 9 月下旬才开源,而讨论热度在权重放出后才真正起来。
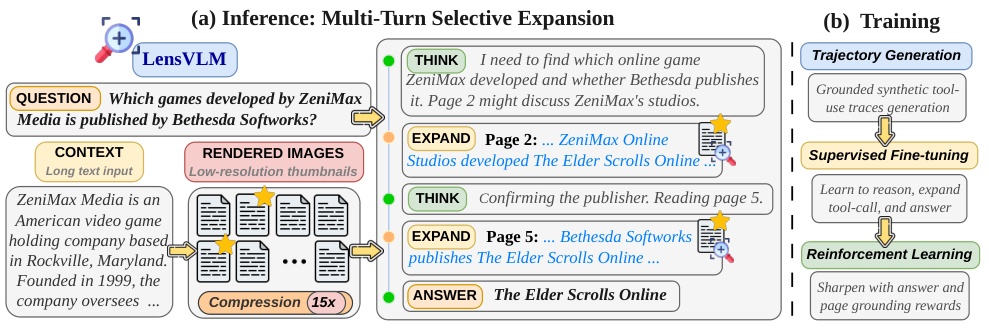
LensVLM 要解决的问题一句话就能说清:把长文档的文字渲染成图片喂给 VLM,压缩上下文;模型看不清的地方,自己决定"放大镜"看哪一页。论文编号 arXiv:2605.07019,作者团队来自 Apple 与杜克大学,代码和权重分别开在 GitHub(apple/ml-lensvlm)和 Hugging Face(apple/LensVLM-9B)。
为什么要绕道图像
长上下文的成本大头在注意力计算。Transformer 的自注意力随序列长度平方增长,一百万 token 的文档,注意力的计算量和显存占用都会变得难以承受。这些年主流的应对方式是检索增强生成(RAG,先检索出相关片段再喂给模型),但 RAG 有个结构性约束:它必须在看到问题之前就建好索引,并且在建索引时固定切块粒度和检索条数,之后不再改变。
LensVLM 所在的研究线选了另一条路:不把文本切分、不建索引,直接把文本渲染成图片,让 VLM 的视觉编码器来"读"。这条思路的关键在视觉 token 的经济性。VLM 的图像编码器把一张固定尺寸的图片映射成固定数量的视觉 token,Qwen3.5-9B 这个底座在三个渲染档位下分别把一张图编码成 72、48 或 24 个视觉 token。一张 A4 页面的文字按 token 算可能有六七百个,渲染成一张 24 视觉 token 的低分辨率图片,压缩率接近 30 倍。更妙的是压缩率可以连续调节:改渲染分辨率就行,不动 tokenizer,不需要重新训练。
代价是字变小了。视觉编码器的有效分辨率有限,压缩率上去之后字符尺寸跌破编码器能分辨的下限,模型开始"看不清"。论文给了一组数字:直接把压缩图像喂给底座模型,压缩率 15 倍时准确率从 72.4%(全文上界)跌到 31.3%,在三个渲染档位的平均对比里,15x 档甚至只剩 3.2%。像素里已经不含那些信息了,这不是提示词工程能救回来的。
先扫描,再展开
LensVLM 的核心动作分两步。第一步,模型扫描所有压缩页面图,这一步不要求读清每个字,只要求看出"答案大概在哪几页",粗粒度的版面证据(标题位置、段落形状、图表轮廓)在压缩后仍然保留。第二步,模型调用一个学出来的 Expand 工具,把选中的页面还原成未压缩形式,还原结果可以是源文本,也可以是高分辨率图像,拿到还原内容后再作答。
这个设计和 RAG 的根本差异在时机。RAG 在推理开始前就完成了选择(切块、索引、top-k 检索一次到位),LensVLM 的选择发生在推理过程中:模型带着问题扫一遍全文档,逐轮决定展开哪一页,每轮展开一页,后一轮的选择以前面几轮展开的内容为条件。论文把这个模式叫 selection-then-expansion。压缩在这里不再是单向的有损变换,而是模型可以按需撤销的一种状态。
GitHub 仓库里的 demo 完整展示了这个过程。给模型 15 张压缩页面图,问"在电影 Kiss and Tell 里出演 Corliss Archer 的那位女演员担任过什么政府职务"。模型先在压缩缩略图里扫到第 10 页提到"American actress, singer",调用 read_page 展开第 10 页,从还原文本里读到 Shirley Temple 曾任美国驻加纳和捷克斯洛伐克大使、白宫礼宾司长,两轮给出答案"Chief of Protocol of the United States"。

压缩率的度量:ICR 和 ECR
论文用了两个压缩指标,区分它们对理解实验结果很重要。
ICR(输入压缩率)度量渲染环节:文本 token 数除以视觉 token 数,只看压缩后喂进去多少。它由渲染配置决定,是静态的。
ECR(有效压缩率)度量模型实际处理量:原文 token 数除以"模型真正消费的全部 token",包括压缩视觉 token 加上每次 Expand 展开的文本。Expand 每调一次,读回来的内容都要计入上下文,所以 ECR 一定低于 ICR。选页越准、展开次数越少,ECR 越接近 ICR;选页越差,展开越多,压缩红利被稀释得越厉害。比较不同方法时 ECR 才公平,检索类方法(reader 只看检索结果)的离线索引成本不体现在 reader 输入里,LensVLM 的工具展开成本却实打实进入上下文,用 ECR 对齐后才在同一条线上比。
效果:4.3 倍压缩不掉点,10.1 倍反超所有基线
主实验在 7 个文本 QA 基准上进行(NQ、HotpotQA、MuSiQue、HELMET 训练域内,Qasper、LongBench v1、RULER 域外),文档长度限定在 32K token 内,判分用 LLM judge(Qwen3.5-397B)。关键结果:
- 4.3 倍 ECR 下,LensVLM 平均准确率 68.9%,与 72.4% 的全文上界基本持平;
- 对照组里,纯压缩图像(Comp. Image)和视觉压缩模型 Glyph 在同等压缩档位下都跌到个位数;
- 未训练的底座模型加 Expand 工具(Base + Expand)就有 39.2%(5x 档),说明"给工具"本身就带来一大截收益,后训练再往上加;
- 到 10.1 倍 ECR,LensVLM 的准确率-压缩权衡全面超过检索基线 ColPali、文本剪枝基线 LLMLingua-2 和视觉压缩基线 Glyph。
训练分两阶段。SFT 阶段用合成轨迹:底座模型直接从前沿模型蒸馏不可行(前沿模型在高度压缩的图像上推理时会产生带幻觉的噪声轨迹,而且 Expand 行为不是它们原生的),Apple 的做法是把标准答案和证据文本一起给合成模型(Qwen3.5-397B),让它在已知答案的条件下生成连贯的推理加工具调用轨迹,只训练"难样本"(底座不用工具答错的样本),冻结视觉编码器和投影层,只更新语言模型参数。RL 阶段用 DAPO 算法,奖励只看最终答案对错加一个答案门控的工具使用奖励,每条轨迹最多 8 轮工具调用。实测模型平均每条轨迹只调 1.3 次 Expand,没有出现工具滥用。
训练改变的三件事
论文的分析部分回答了"为什么有效",三个发现都带了可复验的数字。
第一,训练抹平了渲染敏感性。同一压缩率下换字体、换排版,底座模型的准确率波动 32 个百分点(同字体组内差距 18 点);训练后这个波动缩到 1 点以内。也就是说 LensVLM 学到的是对渲染方式鲁棒的压缩文本表征,任何单一字体下的字符识别都覆盖不了这种能力。
第二,注意力向展开文本集中。论文抓了 Qwen3.5-9B 的 8 层标准注意力(其余 24 层是 GDN 线性注意力,不含可比注意力矩阵),逐层统计模型在各个上下文段落的注意力分配。训练前模型把 16.5% 注意力放在自己的工具调用文本上、10% 撒在干扰图像上;训练后工具调用段降到 8.3%,干扰图像降到 5.7%,而 Expand 返回的文本段从 23.5% 涨到 38.2%。压缩率越高这个迁移越明显:15x 档下展开文本拿走 41.0% 的注意力。模型自己学会了"压缩图只用来定位,内容从展开文本里读"。
第三,工具选择有明确的适用边界。在原生文档理解基准 MMLongBench-Doc 上,Apple 训练了两个变体:OCR 工具(返回提取文本)和高分辨率放大工具(返回原图)。低压缩率下底座模型直接读原图反而最好;高压缩率下放大工具胜出(41.9% 对底座 31.1%),OCR 工具虽然也超过底座但落后于放大。论文的解释是 OCR 丢掉了版面和视觉线索,而这些线索在原生文档(表格、票据、图文混排)里携带任务相关信息。工具选型的实用结论:渲染文本用文本展开,原生文档用图像放大。
代码理解是零样本迁移的加分项。RepoQA 和 CodeQueries 两个代码基准上,LensVLM 没有做任何代码专项训练,纯粹靠"把代码当代文本渲染",每个压缩档位都超过 Glyph。压缩率在这两个基准上偏低(上下文短,工具调用的固定成本摊不平),作者也点明了这个方法的长上下文属性:文档越长,摊销越充分。
边界和使用建议
这份工作真正可复用的部分是它的设计判断,而不只是那个 4.3 倍的数字。
页面选择比视觉阅读更抗压缩。视觉阅读在 15x 压缩下崩溃,但"找出答案在哪一页"这个粗粒度任务在同等压缩下退化平缓得多(论文附录 8 的选择准确率曲线),这支撑了整个 selection-then-expansion 架构的可行性:压缩图够用来看结构,不够用来读内容,而这个"够"恰好覆盖了定位所需的全部信息量。
RAG 没有过时,两者互补。论文 §3.3 把适用场景说得很清楚:证据集中在少数段落、索引成本能被多次查询摊平时,检索仍然更优;证据分散、来源本身是带版面的原生视觉文档、或者离线索引不现实时,视觉压缩加按需展开更合适。论文甚至建议两者组合:先用便宜检索粗筛掉明显无关的块,再渲染压缩。
对开发者来说,上手成本已经压得很低。权重在 Hugging Face(apple/LensVLM-9B,基于 Qwen3.5-9B,Apple ML Research 模型许可),代码在 GitHub(apple/ml-lensvlm),README 里的 demo 两条命令能跑:准备一个文本文档,指定压缩档位(5x/10x/15x),模型自己完成扫描、选页、展开、作答的全流程。评测管线也是完整的,从数据准备(HotpotQA/NQ/MuSiQue 加干扰段落构造)到 LLM judge 判分都能复现。
9B 的底座、24 视觉 token 一页的压缩渲染、一个按需展开的工具调用,三个组件拼出了一种不依赖索引的长上下文处理方式。权重和代码都已经公开,这条"文本渲染成图像"的路线(从 PIXEL、Glyph 到 LensVLM)第一次有了可以自己跑的完整开源实现。
来源:
- 论文:LensVLM: Selective Context Expansion for Compressed Visual Representation of Text(arXiv:2605.07019,DOI: 10.48550/arXiv.2605.07019)
- 权重:apple/LensVLM-9B(Hugging Face)
- 代码:apple/ml-lensvlm(GitHub)