不训练、不联网、没有神经网络:有人用 gzip 做了一个"语言模型"
2026 年 9 月 22 日,Hacker News 首页出现一个 143 分、56 条评论的讨论,主角没有新模型发布会那样的排场,只有一个 6.5 KB 的 Python 文件:gzipt.py。它生成文本的方式是压缩——用操作系统自带的 zlib(DEFLATE 压缩算法)当"模型",配合 beam search(束搜索)逐字节续写莎士比亚剧本。没有神经网络、没有参数、没有训练过程,整个项目只依赖 Python 标准库。
这篇文章的作者是工程师 Nathan Barry,发布在个人博客 nathan.rs(2026-06-14 首发,9-22 被顶上 HN)。他提出的问题看起来像句玩笑:gzip 能当语言模型吗?答案比预期的更有意思——能,但方式很笨,而这个"笨"恰好把语言模型的底层原理拆开给你看。
压缩就是预测:一条信息论老定理
把压缩器和语言模型放在一起,乍看不搭边,实际上它们做的是同一件事:猜测下一个符号。
压缩器的逻辑是"见过的模式不再花钱":遇到重复内容就输出一个便宜的反向引用(back-reference),指向之前出现过的位置;遇到没见过的内容才老实写出原始字节。一段数据越"可预测",压缩后越短。一段完全随机的数据几乎没有结构可利用,压不动。
信息论早就把这件事写成了公式:编码一个符号需要的比特数是 −log₂p,p 是模型给这个符号的概率。概率越高,比特越少。所以任何压缩器肚子里都藏着一个概率模型,不管开发者有没有意识到。
这个等价关系在 2023 年被 DeepMind 的论文《Language Modeling is Compression》(arXiv:2309.10668,EMNLP 2023 Findings)系统地演示了一遍,结论相当反直觉:Chinchilla 70B 这个为文本训练的模型,把 ImageNet 图像块压到原大小的 43.4%(PNG 是 58.5%),把 LibriSpeech 音频样本压到 16.4%(FLAC 是 30.3%)——通用语言模型在图像和音频压缩上反超了专用压缩器。
既然大模型是压缩器,那反过来呢?论文附录里试过用 gzip 直接做生成,效果很差。Barry 的工作从这一步接着往下走:论文说"这条路走不通",他找到了走通的方法。
gzip 怎么"预测":32 KB 滑动窗口里的匹配
gzip 使用的 DEFLATE 算法核心是一个 32 KB 的滑动窗口:压缩当前字节时,算法在最近 32768 字节里找匹配,找到就把"距离 + 长度"编码成反向引用,比直接写字节便宜得多。
Gzipt 利用的正是这个机制。把整个莎士比亚语料(约 1.1 MB 的 tiny shakespeare 数据集)塞进 gzip 的窗口里,然后给一个提示词,比如 MENENIUS:\n(剧中人物名)。接下来对任何一个候选续写打分:
score(候选) = len(gzip(语料窗口 + 提示 + 候选))
压缩后总长度越短,说明候选续写与语料的重合度越高,gzip 越"认得"它。我在本机复现了这一步,同一个上下文下两个候选的实测数字:
| 候选续写 | 压缩后总长度 |
|---|---|
To be, or not to be(语料风格的正确续写) | 13029 字节 |
Xq7z, or not to be(乱写的开头) | 13033 字节 |
差距只有 4 个字节,但这 4 字节就是 gzip 的"置信度"。正确的续写能在窗口里找到更长的匹配,省下的字节就是分数。
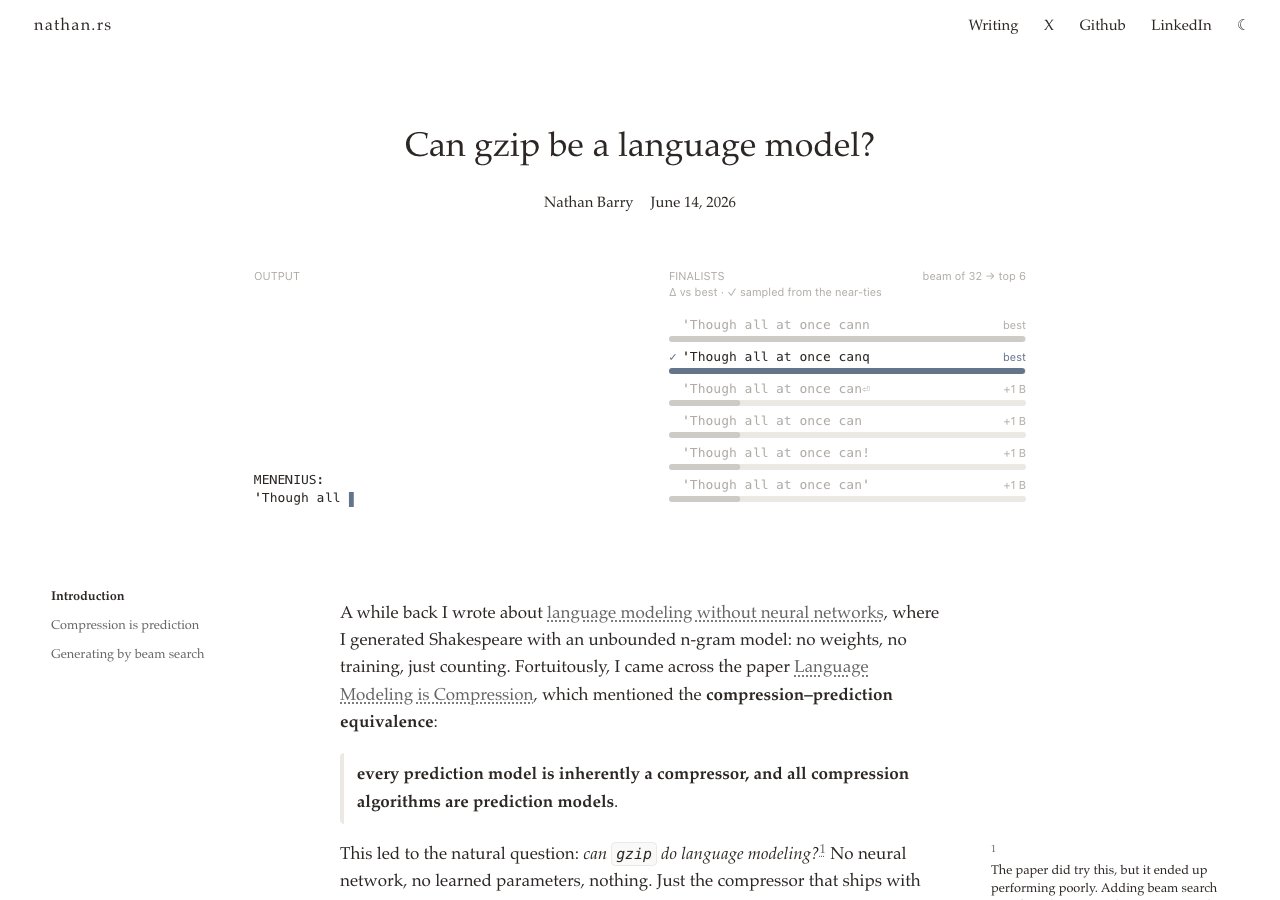
上面这张图是博客官方的生成过程回放动画(数据来自作者真实运行的一次记录):左边 OUTPUT 区逐字吐出生成文本,右边 FINALISTS 区把每个候选的压缩长度画成对比条,best 标注当前最优候选,+1B 表示比最优多花 1 字节。可以直观看到 beam search 每一步在做的事:所有候选拉出来比一遍压缩账单,最便宜的那个胜出。
贪心必死:为什么必须上 beam search
最直觉的生成方式是贪心:每一步只挑压缩后最短的那一个字节,接上去,重复。我按这个思路用 Gzipt 的打分函数实测了一次,提示词同样是 MENENIUS:\n,贪心 40 步的输出是:
'Thoug

AUFID

AUFID


...
三个字节之后就卡死了:模型发现自己刚写过 AUFID,窗口里最近的内容又成了最便宜的匹配素材,于是无限复读,然后一路换行到底。博客原文解释了原因:gzip 的压缩长度是整数,加一个字节经常不改变总长度,大量候选并列,信号全被量化噪声淹没;而且 DEFLATE 对"近处的匹配"收费更低,只要让 gzip 看见自己刚生成的内容,逐字复制就永远是局部最优解。
Gzipt 的修复分三招,全部写在那 6.5 KB 的源码里:
第一,成段搜索(horizon=24)。不逐字节决策,而是向前看 24 个字节:把每个候选序列扩展语料中出现过的所有字节值,打分,保留压缩长度最短的 32 个(beam_width=32),重复 24 层,最后把整段 24 字节一次性提交,再从头规划下一段。拉长决策视野后,"多花 1 字节"的噪声不再致命,因为比的是 24 字节 span 的总账。
第二,遮住历史(tail=80)。打分上下文 = 语料窗口(30000 字节)+ 最近 80 字节的生成内容。更早的生成内容对 gzip 隐藏——它想抄自己的旧账也找不到出处,只能回到语料里找模式。
第三,语料字母表剪枝。只有语料中出现过的字节值才参与候选,其余约 180 个字节值直接排除——一个不在语料里的字节永远不可能延长任何匹配,选它只会在并列时起作用,白白浪费算力。
还有一个纯工程细节很值得说:打分要对每个候选算一次"gzip(上下文 + 候选)",beam width 32 乘以字母表几十个字节值,每层要压几百次。Gzipt 的做法是先把上下文压进一个 compressobj,再用 copy() 克隆编码器状态喂给每个候选——上下文那 30 KB 的昂贵匹配搜索只做一次,候选只算增量。源码注释里写明这与 len(zlib.compress(context + seq)) 逐个算完全等价,但省了一个数量级的重复劳动。
实际生成效果:复现结果与"能力边界"
用官方参数(window=30000,horizon=24,beam_width=32,temperature=0.5,seed=3)在 tiny shakespeare 语料上跑 MENENIUS:\n,输出如下——与博客原文展示的输出完全一致:
MENENIUS:
'Though all at once canq

MARCIUS:
Pray now, nocamest thou to a morsel .

LARTIUS:
Hence, and
I' the end admire, where G
again; and after it ag .这个结果应该怎么读?逐字看,它不是合格的英语——canq、nocamest 都是拼接残次品,每次提交 24 字节的"整数开销"让句子边界模糊。但结构层面它学会了语料的骨架:人名后面跟冒号换行、对白成对出现、用词在莎士比亚词表内。它知道"这段文字长什么样",但不知道"每句话是什么意思"。
把 temperature 设为 0(每步选最压缩的候选、不采样),输出完全确定,可复现。temperature 大于 0 时则在最终候选里按压缩长度加权采样,输出有随机性。这和神经语言模型的采样机制是同一个思路,只是概率分布换成了压缩账单。
能力边界同样清楚。DEFLATE 的窗口只有 32 KB,"模型容量"上限就是一个 32 KB 的滑动窗口里能装下的模式,所以它永远学不了语法之外的抽象;逐字节打分的天性让它擅长局部拼接、无力全局规划;输出的"知识"全部来自那 1.1 MB 语料,窗口外一无所知。文章作者自己也在脚注里承认,论文当年试这个方向"表现很差",他加的 beam search 才把生成质量拉到"能看"的水平。
从压缩视角重新看大模型
这个玩具的价值不在输出质量,在于它把"预测"的神秘外壳拆掉了。神经语言模型和 gzip 在做同一件事:给下一个符号分配概率,选高概率的走。区别只是概率从哪来——gzip 的概率藏在 32 KB 窗口的匹配费用表里,大模型的概率压在几百亿参数里。
压缩视角给大模型的几个老话题提供了新表述。上下文学习(in-context learning)可以理解为"临时的压缩":模型在读你的 prompt 时相当于在调整自己的"编码表",few-shot 例子压得越顺,后面的输出越准。扩展定律(scaling laws)对应"更好的压缩器花更多比特也压得更短"。2023 年 DeepMind 那篇论文把这些对应关系系统化了,Barry 的工作则把方向反过来演示了一遍:不需要任何"智能"的结构,只要打分函数里有"熟悉度",beam search 就能把它组织成像模像样的文本。
对想动手玩的人来说门槛极低:整个项目就一个 gzipt.py 文件,依赖只有 Python 标准库的 zlib,python gzipt.py --corpus 你的语料.txt --prompt "开头" 就能跑,GitHub 仓库 nathanrs/gzipt(119 Stars / 15 Forks)。换个语料它就是另一个"文体模拟器"——原理决定了它只能复述模式,但演示"压缩即预测"这件事,它是能找到的最短路径。
来源: