一个 8 到 29 MB 的模型文件能装下什么?Cactus Compute 在 9 月 18 日发布的 Needle 3 给出的答案是:一套完整的端侧工具调用、结构化抽取和文本嵌入能力,外加一条从 2 层到 20 层、按需裁剪的"智能阶梯"。这个模型在 Hacker News 上线首日拿到 144 分和 25 条评论,GitHub 仓库 cactus-compute/needle 目前已有 11300 star,是这家端侧 AI 公司 Needle 系列的第三代作品——第一代 Needle 在 2026 年 5 月以 776 分登上 HN 首页,第二代 Needle2 在 8 月拿下了 537 分。
它要解决的问题是内存,不是智商
大模型厂商的竞争聚焦在参数规模上,Cactus Compute 反向而行。Needle 3 的定位写在官网第一行:面向手机、可穿戴设备、机器人、智能家居、汽车和微控制器的基础模型。整套权重是一个 CQ2 量化(2-bit)的二进制文件,最小 8 MB,最大 29 MB,运行引擎本身不到 1 MB。
团队对"为什么要做这么小的模型"有过明确回应。Needle 3 作者 HenryNdubuaku 在 HN 评论区说,对于能装下 8B 到 27B 模型的硬件,局域网部署的开源模型在通用任务上就是更好的选择;Needle 面向的是装不下它们的硬件:ARMv7、MIPS32(廉价 IP 摄像头里常见的 Ingenic 芯片)、RISC-V 和手表。他还给出了一个常被忽略的观察:对端侧模型来说,成本并不是真正的杠杆,可用性(availability)和延迟才是——设备不联网也能完成指令,请求不需要经过任何服务器。
也就是说,Needle 3 从设计之初就没有打算和通用大模型比写作、比推理。HN 评论区有一条获得认同的总结来自用户 janalsncm:通用大模型是瑞士军刀,Needle 是一把开瓶器。它只做一件事:把非结构化文本转成结构化的 JSON 调用,并且在低内存环境里快速完成这件事。
智能阶梯:一套权重,十九个模型
Needle 3 架构上最有意思的设计叫 Intelligence Laddering(智能阶梯)。模型的每一层都是一个容量单调递增的子网络,开发者可以从 2 层(2L)到 20 层(20L)之间任选一个深度裁出一个子网络,每个子网络都是独立可用的模型。参数规模从 29M 到 121M,文件体积对应 9 到 29 MB。
这套设计直接改变了微调和部署的经济性。官方给出的路径是:用 LoRA 在冻结的 20 层基座上全深度微调,然后 needle build 命令可以把任意深度的 4-bit 子网络打包成 .cact 文件,跑在同一个推理引擎上。一次微调,产出一条从手表到手机都能各取所需的模型梯队。
底座是 Laddered Simple Attention Networks(阶梯式简单注意力网络),官网给出的对比数据是:相同配置下每个 token 消耗的 MFLOPs 不到标准 Transformer 的一半。在树莓派 5 上,Needle 3 的解码速度为 400 到 4000 token/s,预填充速度 1000 到 10000 token/s。
还有一个容易被忽略的细节:121M 参数里有 70M 是 n-gram 表(团队称之为 engram)。作者在 HN 评论区解释,这类知识查询不需要过 MLP,模型判断"这个词是歌手名还是歌名"直接查表完成。这也是为什么一个 121M 的模型在工具调用这种"从请求里抄参数"的任务上表现超出参数量预期——360B token 的训练量大部分花在结构化数据生成管线上,按作者的说法,数据才是这个项目里最重的工作。
三个技能:调用、抽取、嵌入
Needle 3 只有三项能力,但每项都做到了"保证输出可解析":
工具调用:模型读取应用暴露的函数描述,选择正确的函数并从用户请求中填入每个参数。用户要两件事就返回两个有序调用;请求超出工具覆盖范围时返回空列表,而不是硬编一个。
结构化抽取:声明数据形状(Pydantic 模型),传入杂乱文本,拿回类型化字段。解码语法(decode grammar)从机制上保证输出一定能解析,发票、预约、表单都是典型场景。官方文档给了一个发票抽取的示例,vendor、total、due_date 三个字段从一段自然语言里直接抽出。
文本嵌入:同一个模型可以为句子生成向量,支撑完全本地的语义搜索、请求到工具的匹配和告警去重。
安全机制也做进了推理循环。每个响应都带一个来自校准头(calibrated head)的置信度分数,引擎内置 0.1 的下限,低于下限的调用会被扣进 suppressed_calls 而不是执行;应用侧可以按分数分流:高分直接执行、中分弹窗确认、空结果视为拒绝。对于必须命中的指令,工具可以声明 triggers 正则表达式,匹配时解码被限制在命中的工具集合内,即使置信度偏低也会发出调用。
真实成绩与真实翻车
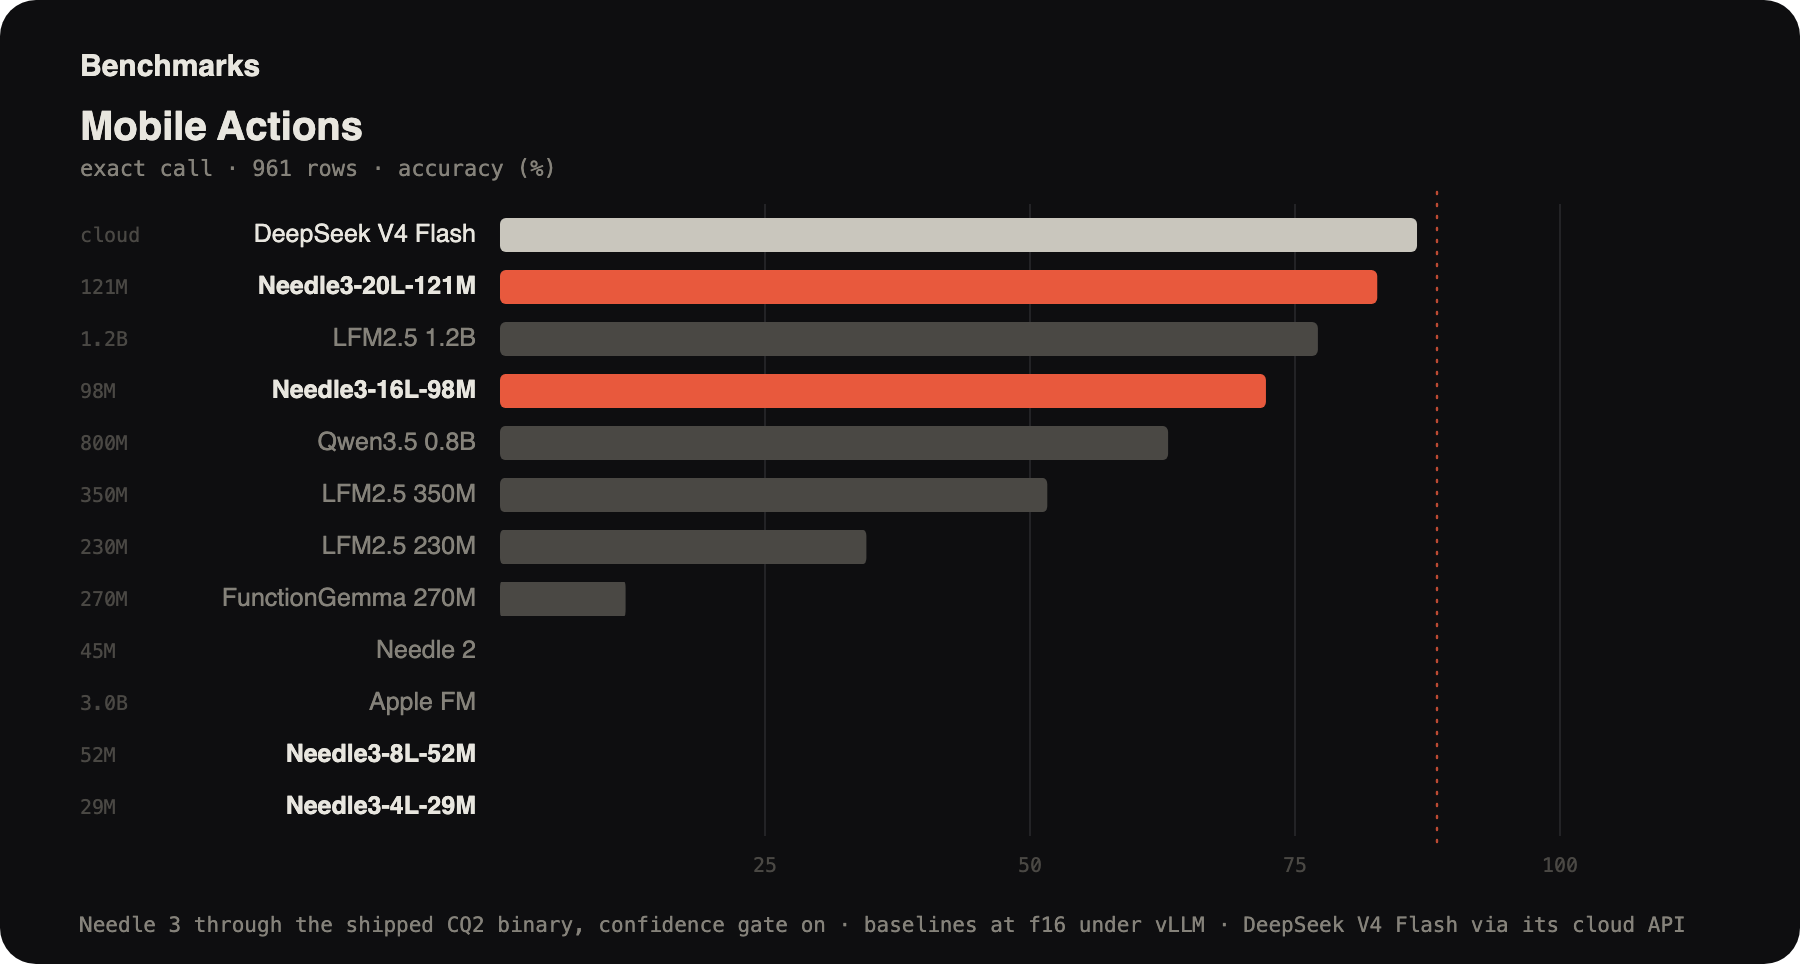
官方 benchmarks 图给出了 Mobile Actions 数据集(961 行,exact call 准确率)上的对比:通过云端 API 调用的 DeepSeek V4 Flash 排第一,Needle3-20L-121M 以小幅差距紧随其后,超过了参数量大十倍的 LFM2.5 1.2B;16 层子网络 Needle3-16L-98M 也跑在 Qwen3.5 0.8B 和一众开源基线前面。所有 Needle 3 成绩通过出厂的 CQ2 量化二进制测得,基线则为 f16 精度。
微调后的提升更明显:官方数据显示,在 DroidCall 数据集上微调能让每个子网络提升 18 到 36 个百分点,从 4 层(29M 参数)开始,调优后的子网络通过 DeepSeek V4 Flash 的成绩。官网的一句话总结是:4 层子网络在下游任务上微调一个 epoch 就能对齐 DeepSeek V4 Flash 的水平——当然,前提是"窄任务",离开微调分布就不再成立。
HN 评论区的实测反馈则提供了另一面的样本。有用户测试智能家居指令时发现,"I need a wee"被理解成了播放音乐(wee 是一个音乐流派),"I'm going to the toilet"得到回复"好的,我会打开马桶";"it's too cold"没开暖气,反而调低了恒温器。一位用户总结自己的测试体验是"我试的指令没有一个成功",作者当晚更新了演示预设的工具描述和 triggers。这些案例拼出了一个诚实的画像:模型对字面匹配和预设模式依赖很重,对语言中的隐含意图推理能力弱。作者在评论区承认"还有推理改进空间",并强调 Needle 是任务特定模型,工具描述写得好不好就是全部的关键。
这个短板被官方文档正面承认了。工具编写指南要求:一个工具对应一个动作、用枚举值对齐用户用语、必填参数没有证据时宁可扣下也不猜。换句话说,Needle 3 的准确率是"模型 + 认真写的工具描述"共同构成的,直接丢给它一堆随意的函数定义不会有好结果。
上手与部署
部署面覆盖了所有主流目标。每个平台对应一个预置引擎目录,needle build --platform 拉取引擎并把 needle3.cact 权重放在旁边:
| 目标 | 平台目录 | 产物 |
|---|---|---|
| macOS | macos-arm64 | needle CLI, libneedle.a, needle.h |
| Linux | x86_64, arm64, armv7, riscv64, mipsel | needle CLI, libneedle.a, needle.h |
| Android | arm64, armv7, riscv64 | needle CLI, libneedle.a, needle.h |
| iOS / tvOS / watchOS | 对应 arm64 | libneedle.a, needle.h |
| 浏览器 | wasm | needle.js, needle.wasm |
| WASI | wasm-component | needle.component.wasm, needle.wit |
Python 侧的用法只需一个装饰器:
import needle

@needle.tool
def get_weather(city: str):
    "Get the current weather for a city."
    return {"city": city, "temp_c": 27, "sky": "clear"}

agent = needle.Needle(tools=[get_weather])
print(agent.run("what's it like in Lagos right now?")["results"])微调走三步:needle finetune 在数据上跑 LoRA,needle build --lora 打包成调优档案,needle build --platform ... --layers 8 裁出目标设备需要的深度。
边界在哪,机会就在哪
把 Needle 3 放回端侧 AI 的版图,它的差异化清晰:前代 Needle 2 的 Simple Attention Network 架构细节站内已有专文,三代在这一底座上新增的智能阶梯把"一套权重、多个规格"变成了微调和部署层面的现实。对比其他玩家:Gemini Nano、Apple FM 这类厂商内置模型面向通用助手场景,体量在数百 MB 到数 GB;llama.cpp 生态的量化小模型保住了对话能力但起步仍需数百 MB 内存;Needle 3 则把赌注押在"自动化任务可以比通用对话小两个数量级"这个判断上,用 360B token 的结构化数据和 n-gram engram 把工具调用压进了 8 MB。
HN 评论区的一条质疑值得记录:用户 Tsarp 问这个模型的真实用例是什么——开放模型的 API 定价已经很低,注重隐私的用户可以在局域网跑 8B 到 27B。作者的回答重复了那个容易被忽略的事实:真正的目标硬件是那些连局域网方案都跑不动的设备,廉价摄像头、手表、微控制器,这个市场里根本没有"跑个大模型"的选项。
对开发者来说,Needle 3 的实用价值集中在两个场景:一是给低功耗设备补上"听懂人话并转成指令"的能力,让硬件厂商不必自己从头训练;二是作为云端大模型的本地降级层,断网时关键指令仍可执行。至于它不能做什么——写代码、聊天、开放域问答——官方没有掩饰,janalsncm 那句"开瓶器"的评价反而是最好的选购指南:如果你的产品只需要开瓶器,何必装一把瑞士军刀。
来源:
- Needle 3 官网(Cactus Compute)
- cactus-compute/needle GitHub 仓库
- Hacker News 讨论帖(2026-09-18,144 分,含作者 HenryNdubuaku 多轮回复)