9 月 8 日,NVIDIA 在官方开发者博客宣布让 Rust 成为编写 GPU 内核的一等语言:CUDA Rust 计划正式启动,两个开源项目同日亮相。消息在 Hacker News 上拿到了 689 分和 270 条评论。在此之前,Rust 已经大量出现在 NVIDIA 的系统层代码里,Nova Linux 显卡驱动用 Rust 写成,推理服务框架 NVIDIA Dynamo 的核心是 Rust,NVTX 性能追踪工具提供了 Rust 绑定。唯一的例外是 GPU 内核本身:开发者可以从 Rust 发起内核启动,但内核的代码往往要退回 CUDA C++。CUDA Rust 补上的正是这一段。
两条轨道,对应 CUDA 自身的两条轨道
CUDA Rust 没有做成单一方案,而是跟随 CUDA 自身的两条编程模型轨道各落一个项目。
第一条是 SIMT 轨道,对应项目 cuda-oxide。SIMT 是开发者用 CUDA C++ 或 numba-cuda 写了十几年的模型:你描述单个线程做什么,启动成千上万个线程并行执行。第二条是 Tile 轨道,对应项目 cutile-rs。Tile 是 CUDA 较新的编程模型,C++ 和 Python 侧早已可用:你描述一块数据(tile)上的计算,线程映射和内存布局交给编译器安排。
NVIDIA 在文中给出的选型建议是优先 Tile:编译器决定 tile 如何映射到不同架构,源代码里不必写死架构相关的选择;需要对线程和内存做精细控制时再退回 SIMT。编程模型和语言是两个独立的选择,NVIDIA 表示计划支持 CUDA Rust、CUDA C++、CUDA Python 之间的互操作,选哪个前端不会把开发者锁在生态系统之外。
SIMT 轨道:cuda-oxide,把 Rust 编译到 PTX
cuda-oxide 的核心是一个自定义 rustc codegen backend。编译时它拦截编译流程,把标注了 #[kernel] 的函数沿 Rust MIR、社区 IR 框架 Pliron、LLVM IR 一路编译到 PTX(NVIDIA GPU 的中间表示),其余代码交给标准 Rust 后端。GPU 相关的 IR dialect 和全部变换都留在 Rust 侧完成,直到标准 LLVM 后端接管。
依赖要求不算轻:Linux、计算能力 8.0 以上的 GPU、CUDA 12.x 或更新工具链、clang 与 libclang 头文件,外加一个固定的 nightly 工具链(当前是 nightly-2026-04-03)。cargo oxide doctor 可以一站式检查环境。
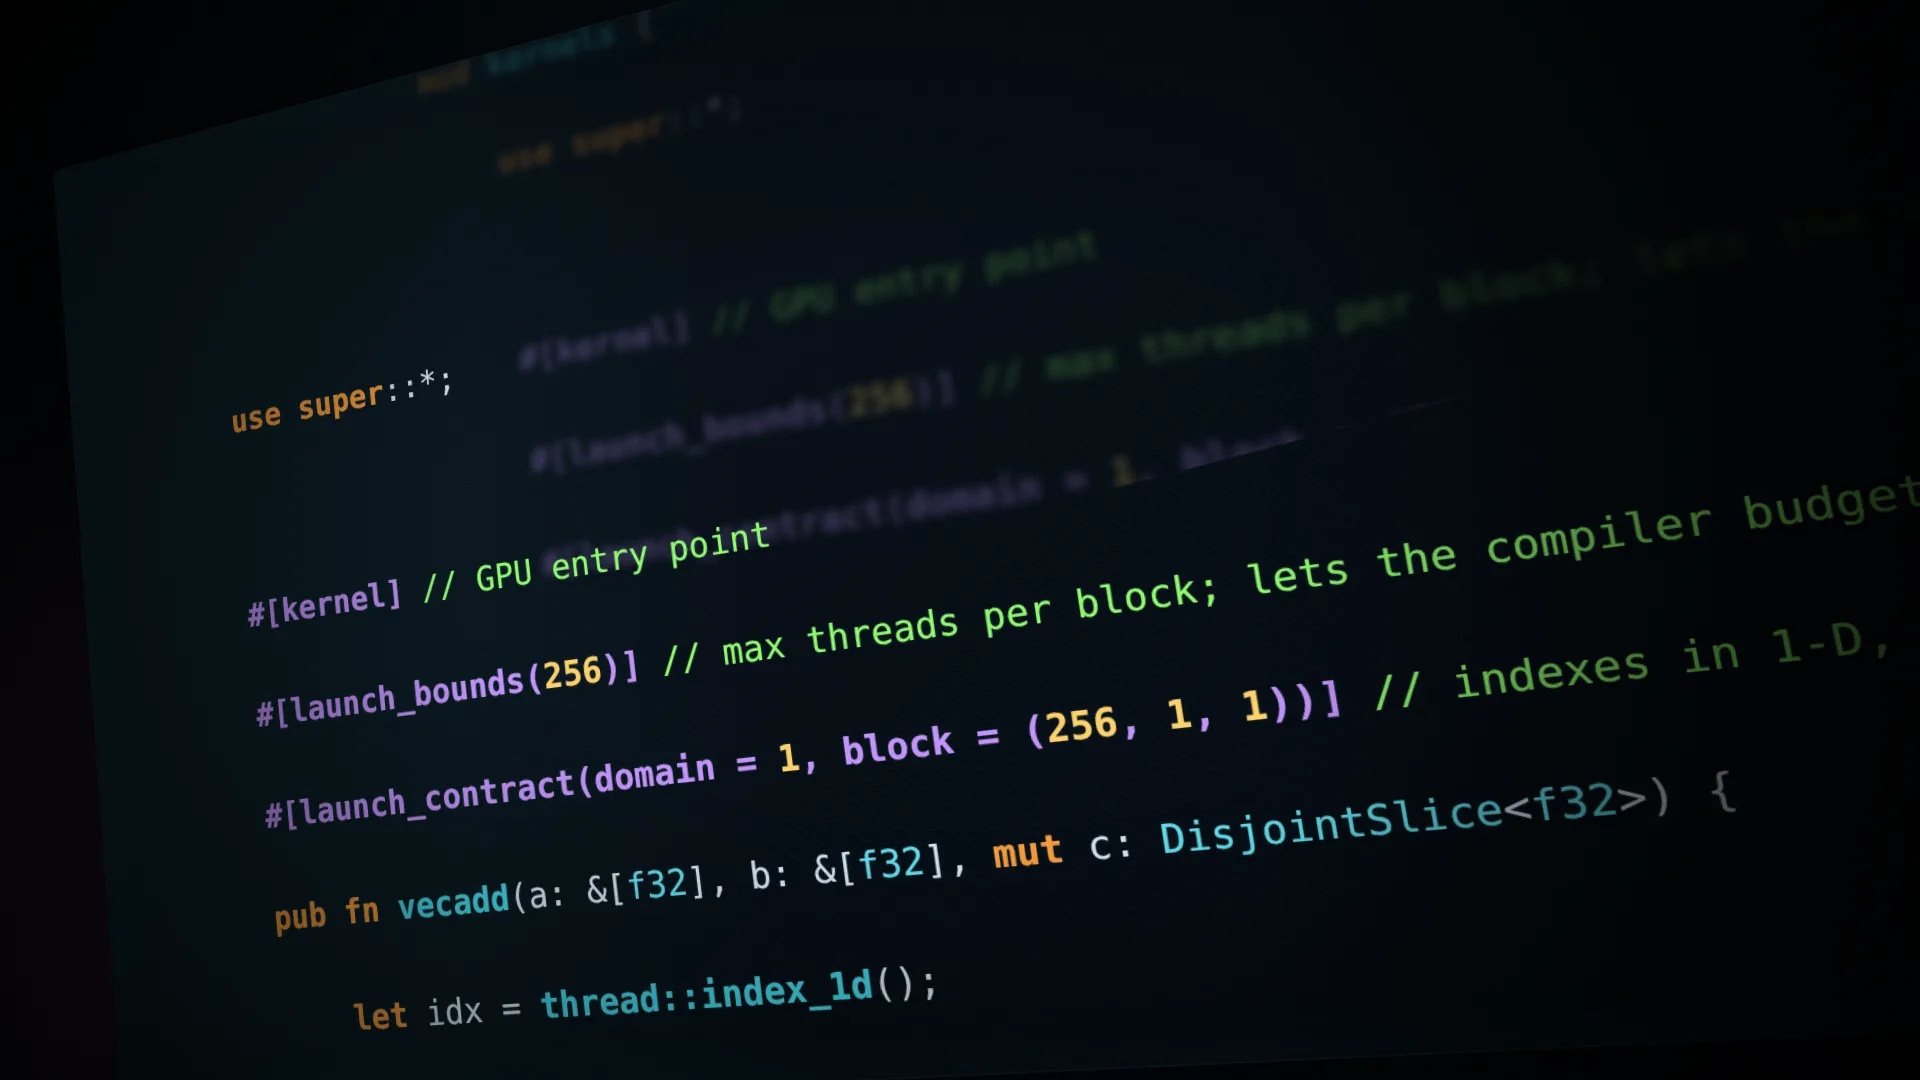
博客给出的完整示例是一个 1024 个浮点数的逐元素加法。内核签名承载了整个安全论证:
#[kernel] // GPU entry point
#[launch_bounds(256)] // max threads per block; lets the compiler budget registers
#[launch_contract(domain = 1, block = (256, 1, 1))] // indexes in 1-D, 256-thread blocks
pub fn vecadd(a: &[f32], b: &[f32], mut c: DisjointSlice<f32>) {
    let idx = thread::index_1d();
    let idx_raw = idx.get(); // the plain usize, for reading the inputs
    if let Some(c_elem) = c.get_mut(idx) {
        *c_elem = a[idx_raw] + b[idx_raw];
    }
}
三个类型各司其职。输入 a、b 是普通共享切片,所有线程可读。输出 c 是 DisjointSlice<f32>:每个线程只拿到自己那个元素的独占写权限。这个类型存在的理由是 &mut [f32] 在这里形状不对,数千个线程需要同一个可变借用,Rust 会直接拒绝。DisjointSlice 把一次可变借用拆成逐线程的碎片。
thread::index_1d() 返回索引类型而非裸整数,c.get_mut(idx) 只接受这种类型,越界访问作为必须处理的分支出现在代码里(返回 Option),没有机会演变成事后才发现的内存错误。
启动配置同样走检查而非信任:#[launch_contract] 声明内核按一维索引、256 线程块工作,prepare_vecadd 把调用方传入的 LaunchConfig1D 与这份声明以及设备实际限额核对,通过后签发一个令牌,安全的 vecadd 启动方法只接受这种令牌。没有契约的内核只暴露裸的 unsafe 启动方法。
宿主侧与设备代码写在同一个文件里,一条命令构建,不需要单独的内核 crate。首次 cargo oxide run 要构建整个 codegen backend,之后走缓存。
Tile 轨道:cutile-rs,stable Rust 直接可用
cutile-rs 高一个抽象层:计算以 tile 为单位描述,每个 tile 块作为单一逻辑线程执行一次内核体,背后由多少真实 GPU 线程支撑由编译器决定。实现机制是把内核 AST 通过 #[cutile::module] 宏嵌入宿主二进制,内核首次启动时经 CUDA Tile IR 即时编译(JIT)。
依赖明显更轻:计算能力 8.0 以上的 GPU、CUDA 13.3、stable Rust 1.89 或更新版本,不需要 nightly 工具链,也不需要自备 LLVM。crate 已发布到 crates.io,cargo add cutile 即可。
同一个逐元素加法,Tile 版本是这样的:
#[cutile::entry()]
fn add<const B: i32>(
    z: &mut Tensor<f32, { [B] }>, // exclusive output, one sub-tensor of B elements
    x: &Tensor<f32, { [-1] }>,    // shared input; -1 is a dynamic dimension, resolved at launch
    y: &Tensor<f32, { [-1] }>,
) {
    let tx = load_tile_like(x, z); // the slice of x lining up with this sub-tensor of z
    let ty = load_tile_like(y, z);
    z.store(tx + ty); // elementwise across the whole tile
}
输入形状里的 -1 是哨兵值而非尺寸,该维度在启动时从张量上读取,形状变化不需要重新编译。内核体对每个子张量执行一次,load_tile_like 加载的是整块 tile 而非标量。
宿主侧最关键的一行是 .partition([128]),它同时做三件事:给每个 tile 一块 128 元素的独占写区间(其他 tile 无法触碰);确定启动几何(1024 除以 128,共 8 个 tile);提供静态维度 B 的值。&mut 输出必须先 partition 才能传入,独占性由此落地。整个程序是一条延迟求值链,ones、zeros、内核调用乃至拷回主机都被记录而非立即执行,直到 .sync_on(&stream) 才真正运行,全程只有一个同步点。
两个内核,同一句安全承诺
两个项目防的是同一类 bug:数千个线程无固定顺序地访问同一块缓冲区,两个写入或一读一写撞在同一地址上,结果由到达顺序决定。这类竞态极少能按需复现,测试全绿、上线出事是常态。
cuda-oxide 把别名输入在编译期拦下。把输出缓冲区 c_dev 同时当作输入传进内核:
module.vecadd(&stream, &prepared, &c_dev, &b_dev, &mut c_dev)?;编译器直接拒绝:error[E0502]: cannot borrow c_dev as mutable because it is also borrowed as immutable。
cutile-rs 的检查更强一层,所有权跟随张量跨越启动边界。同一个别名写法:
let z = api::zeros::<f32>(&[1024]);
kernel::add(z.partition([128]), z, y)
编译器报 error[E0382]: use of moved value: z,z 已被 move 进第一次调用,不允许再出现。博客的原文评价是:cuda-oxide 检查每次启动调用,cutile-rs 的所有权主张是两者中更强的一个。
两条轨道的取舍落在这里。Tile 模型为开发者屏蔽了共享内存和线程索引,这类错误无从写起,安全性由构造保证(safe by construction),同时也是代价:需要手动管理共享内存的极致优化场景,Tile 给不了这个控制权。SIMT 保留控制权,但当下共享内存操作仍需 unsafe 块。共享内存是高性能 SIMT 内核的基石,NVIDIA 表示让这条路径安全化是进行中的工作。
项目现状:一个 alpha,一个已被外部引擎采用
NVIDIA 明确说明两个项目都处于早期,均未到生产就绪。cuda-oxide 是 early alpha;cutile-rs 更成熟一些,已发布到 crates.io,并已在 NVIDIA 之外被 HuggingFace 的 Grout 推理引擎和 mistral.rs 采用。API 覆盖不完整且会变动。
Rust 写 GPU 代码并非新事物,Rust-GPU、rust-cuda、cudarc、CubeCL 等社区项目先于官方入场,cuda-oxide 书中的生态附录给出了官方项目与它们的相对位置,NVIDIA 也提到正与 rust-cuda 的维护者协作。这一次的差别在于官方工程资源的投入规模,以及明确的技术路线:CUDA Rust 的投入会持续到 2027 年及以后。
配套动作同步展开:论文《Fearless Concurrency on the GPU》已发布,NVIDIA 研究科学家 Melih Elibol 在 9 月 8 日至 11 日蒙特利尔的 RustConf 2026 上做了同名报告。
对开发者的实际意义
对 CUDA C++ 开发者,CUDA Rust 不构成迁移压力。CUDA C++ 和 CUDA Python 是成熟的企业级工具链,官方的表述是继续投入。真正的问题域是那批已经在用 Rust 写推理引擎、服务框架和 agent 运行时的团队:此前他们的内核代码必须切回 C++,工具链、构建系统和内存安全模型全部断裂一次。cuda-oxide 让宿主与设备代码共享同一套类型定义,cargo oxide doctor 把环境检查纳入标准构建流程,这条边界消失了。
对 Rust 生态,这是 GPU 计算从「社区项目维持」进入「芯片厂商主线投入」的转折点。Cudarc 用户在 Hacker News 评论中对比指出,cuda-oxide 的优势是宿主与设备可共享 struct 定义,代价是把标准 CUDA 内核换成一个新的、仍在开发中的方言;也有评论者质疑内核语言的必要性,认为直接用 Triton 这类 DSL 更实际。这些分歧正是早期阶段的正常状态,官方博客自己也把「停止要求 pinned nightly 工具链」列为希望做到的事。
试用路径已经铺好:cuda-oxide 走 cargo oxide new 加 cargo oxide run 跑通模板示例;cutile-rs 克隆仓库后 cargo run -p cutile-examples --example hello_world。两个仓库都在 NVlabs 组织下,接受 issue 和 GitHub Discussions 反馈。
来源:
- Introducing CUDA Rust: Two Tracks for Writing GPU Kernels | NVIDIA Technical Blog
- NVlabs/cuda-oxide · NVlabs/cutile-rs
- 论文:Fearless Concurrency on the GPU