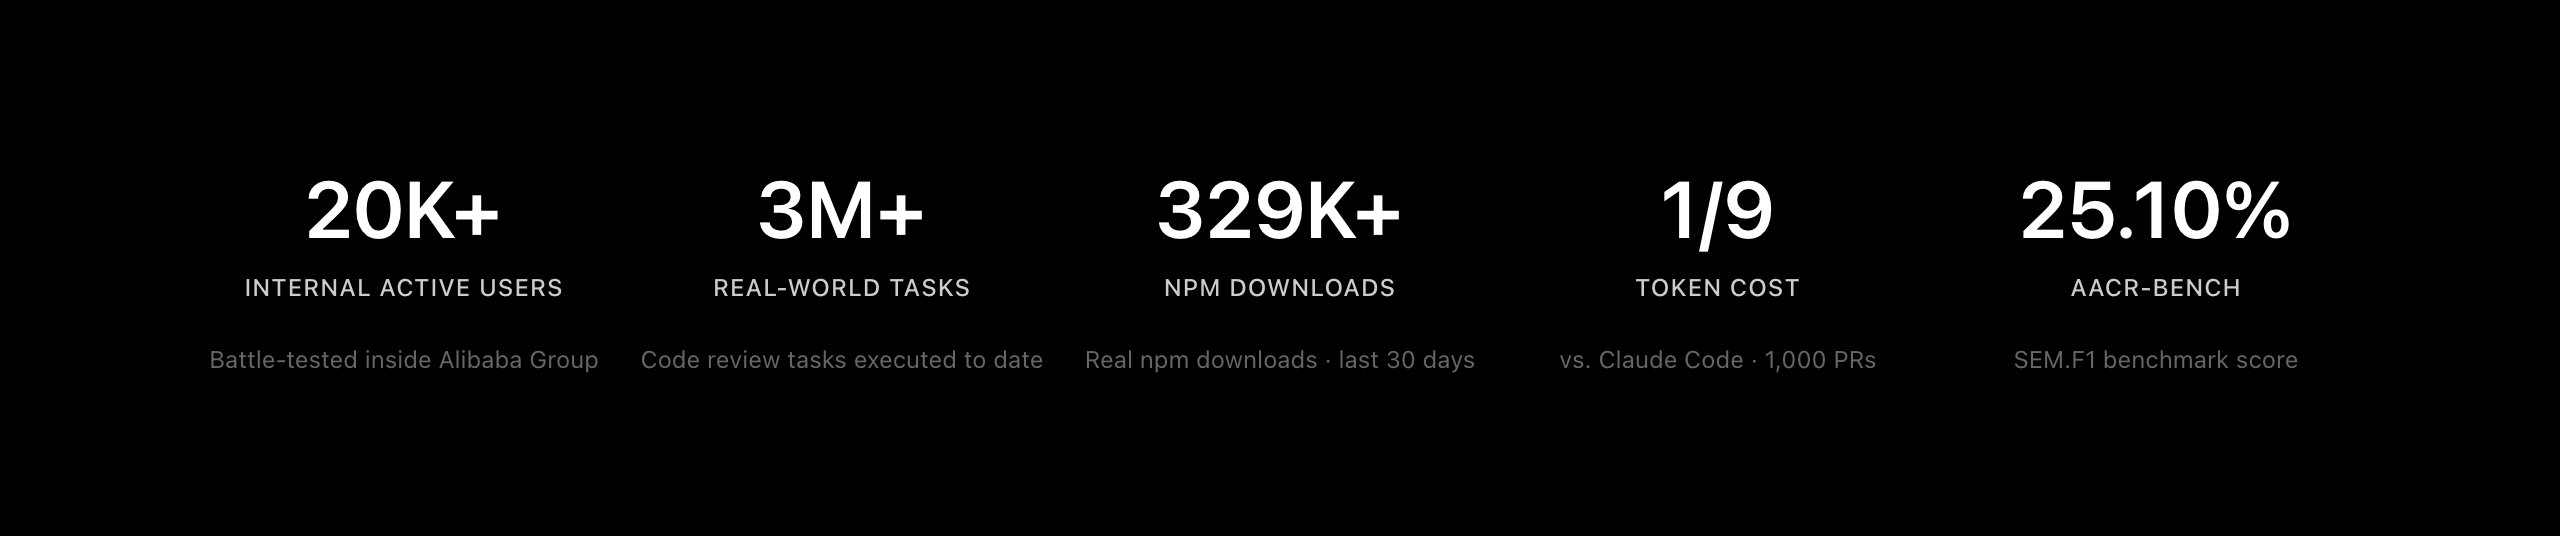
阿里巴巴的 AI 代码评审 CLI 工具 open-code-review 正在 GitHub Trending 上以单日新增超过 3200 star 的速度登顶榜首,累计 star 数达到 3.2 万。这个命令名为 ocr 的工具此前的身份是阿里集团内部的官方 AI 代码评审助手,按官方 README 的说法,过去两年服务了数万名开发者,累计识别出数百万个代码缺陷,如今以 Apache-2.0 协议开源,通过 npm install -g @alibaba-group/open-code-review 即可安装。
支撑这些数字的是一份公开的评测数据集 AACR-Bench:50 个热门开源仓库、200 个真实 Pull Request、覆盖 10 种编程语言,由 80 多名资深工程师交叉标注出 1505 个真实缺陷作为对照答案。数据集托管在 Hugging Face(Alibaba-Aone/aacr-bench),任何质疑其结论的人可以逐条复核。这份基准给出了一个相当反直觉的结论:同一个模型,套在专门为代码评审设计的工程流水线里,评审质量翻倍,token 成本只有通用 Agent 的九分之一。
先看数据:同一模型,两套架构,差距有多大
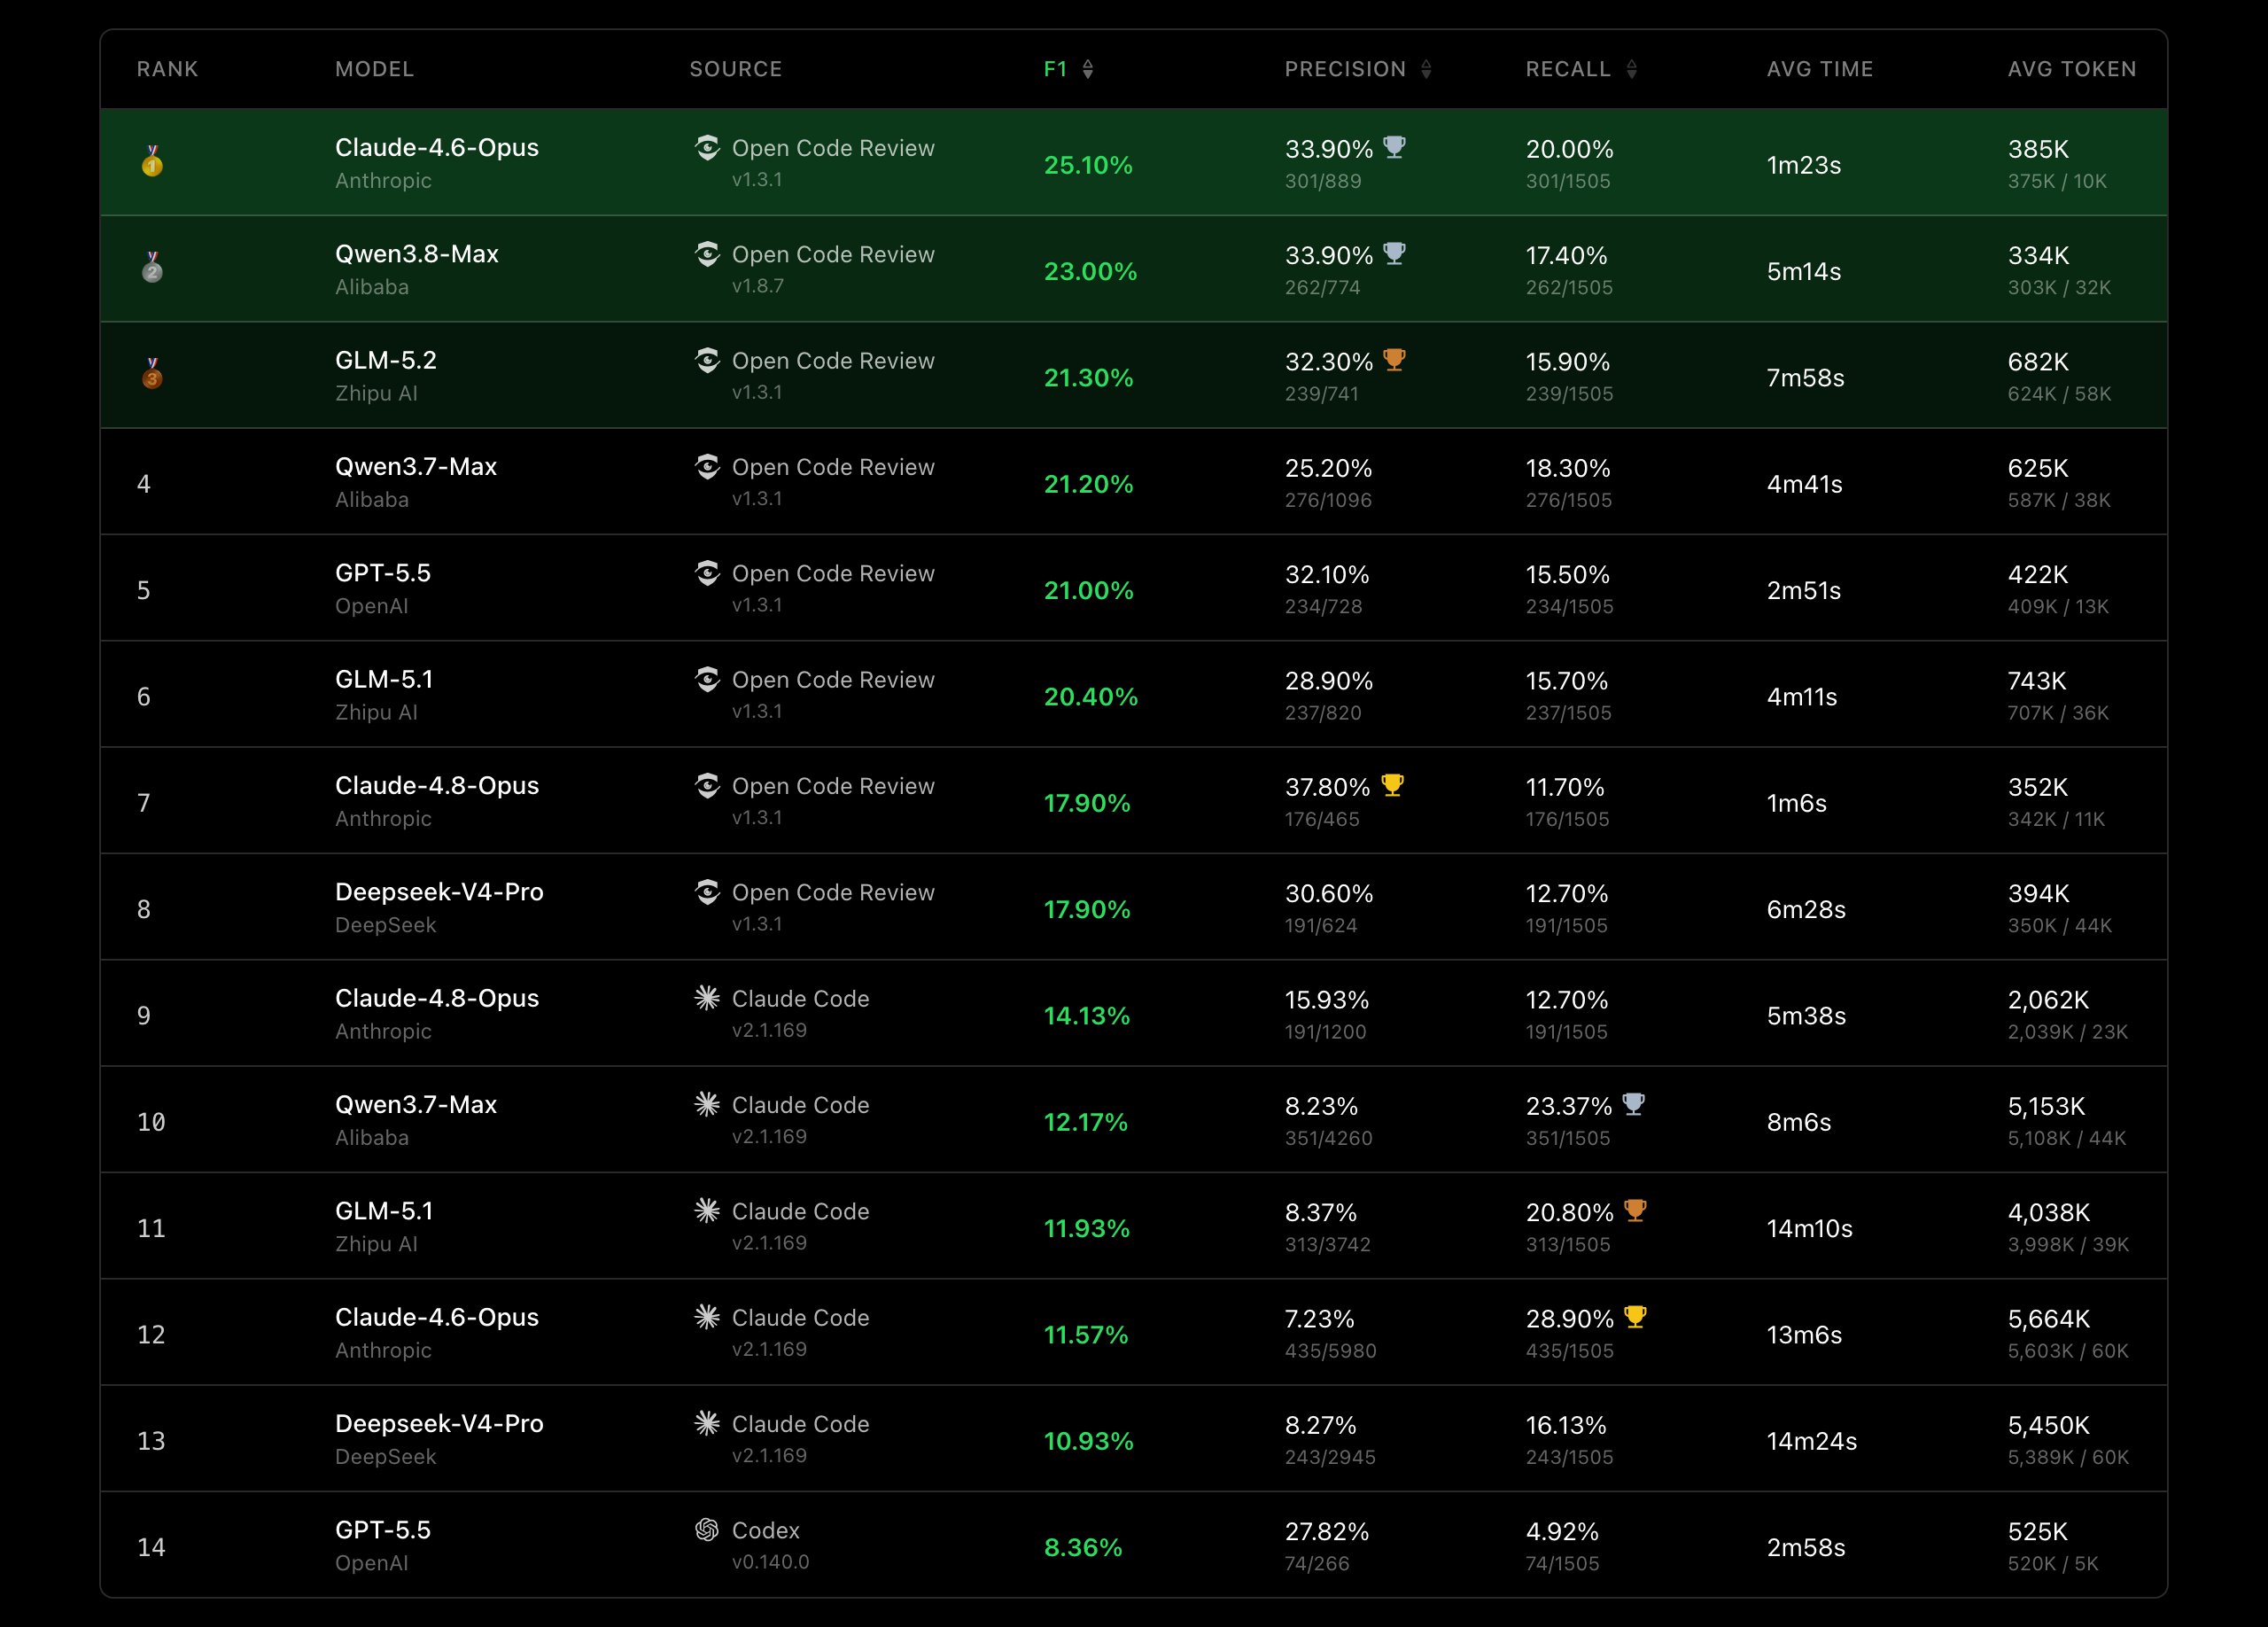
下表整理自官方 benchmark 图(AACR-Bench,指标为全部 1505 个标注缺陷上的得分):
| 模型 | 运行环境 | F1 | Precision | Recall | 平均耗时 | 平均 Token |
|---|---|---|---|---|---|---|
| Claude-4.6-Opus | Open Code Review v1.3.1 | 25.10% | 33.90% | 20.00% | 1m23s | 385K |
| Qwen3.8-Max | Open Code Review v1.8.7 | 23.00% | 33.90% | 17.40% | 5m14s | 334K |
| GLM-5.2 | Open Code Review v1.3.1 | 21.30% | 32.30% | 15.90% | 7m58s | 682K |
| GPT-5.5 | Open Code Review v1.3.1 | 21.00% | 32.10% | 15.50% | 2m51s | 422K |
| Claude-4.8-Opus | Claude Code v2.1.169 | 14.13% | 15.93% | 12.70% | 5m38s | 2,062K |
| Qwen3.7-Max | Claude Code v2.1.169 | 12.17% | 8.23% | 23.37% | 8m6s | 5,153K |
| GLM-5.1 | Claude Code v2.1.169 | 11.93% | 8.37% | 20.80% | 14m10s | 4,038K |
| Claude-4.8-Opus | Codex v0.140.0 | — | 27.82% | 4.92% | 2m58s | 525K |
三组对比值得逐项拆开看。
第一组:同模型同源对照。 Claude-4.8-Opus 跑在 Claude Code 里拿到 F1 14.13%,平均消耗 2062K token;排在该榜第 7 行的同款模型跑在 Open Code Review 里,F1 提升到 17.90%,token 降到 352K——token 只剩原来的 17%,F1 反而高出 3.8 个百分点。GPT-5.5 的对照更直观:跑 Open Code Review 时 422K token、F1 21.0%,同模型在通用 Agent 里的 token 量级普遍是它的 5 到 10 倍。
第二组:精度与召回的取舍。 Precision 衡量报出的问题里有多少是真缺陷(决定误报噪音),Recall 衡量真实缺陷里找到了多少(决定漏检率)。Claude Code 跑 Qwen3.7-Max 时 Recall 冲到 23.37% 全场最高,代价是 Precision 只有 8.23%——报 10 个问题只有不到 1 个是真的,平均消耗 5153K token。Open Code Review 的路线相反:用 33.90% 的 Precision 换 17.40% 的 Recall。官方在 README 里承认这是刻意的取舍,理由是评审场景里误报的代价高于漏报——每条误报都要消耗一个人的工作时间,而漏掉的缺陷还有编译、测试和后续评审兜底。
第三组:速度。 Claude-4.6-Opus 加 Open Code Review 的组合单次评审平均 1 分 23 秒、385K token,在 25.10% 的 F1 下是全场性价比最高的一行。作为对比,Claude Code 跑 GLM-5.1 需要 14 分 10 秒和 4038K token,换来的 F1 只有 11.93%。
需要说明边界:这份基准的标注和跑分都来自阿里团队,1505 个缺陷的标注质量没有第三方复核,README 中"数万开发者""数百万缺陷"等内部规模数据也是官方自述。但对照组设计(同一模型分别跑两套架构)让横向结论——架构带来的差异大于换模型的差异——有了可检验的结构。
通用 Agent 评审代码,问题出在哪
用过 Claude Code 之类的通用 Agent 做代码评审的人,大多撞过这三堵墙,官方 README 把它们归为同一类根因:
- 覆盖不完整:变更文件一多,Agent 会悄悄"抄近道",只挑一部分文件评,其余跳过。评审范围本身变成了概率事件。
- 位置漂移:报告里说的问题位置和实际代码对不上,行号或文件引用漂移,人要去代码里二次定位。定位失败的评审意见等于没有。
- 质量不稳定:自然语言驱动的 Skill 依赖提示词,提示词的小幅改动就能让评审质量大幅波动,难以调试和回归。
这三类问题的共同根源是:评审流程里那些"不允许出错"的环节,被交给了概率性的语言模型来决定。文件选哪些、规则套哪条、位置定在哪,每一步都是模型即兴发挥的机会,也每一步都是出错的机会。
核心设计:哪些环节不许出错,就别让模型碰
Open Code Review 的架构思路是混合制:确定性工程负责硬约束,LLM Agent 只负责它真正擅长的动态决策。
确定性工程这一侧,四个模块把流程钉死:
- 精确文件选择:哪些文件必须评审、哪些应该过滤,由工程逻辑判定,保证重要变更零遗漏。这是对"覆盖不完整"的直接回应。
- 智能文件捆绑:相关的文件被打包成同一个评审单元,比如
message_en.properties和message_zh.properties这类语言资源对会被绑在一起评。每个捆绑单元作为一个拥有独立上下文的子 Agent 运行,分而治之,超大变更集下依然稳定,并且天然支持并发评审。 - 细粒度规则匹配:用模板引擎而非提示词来匹配评审规则。内置规则集覆盖 NPE(空指针异常)、线程安全、XSS、SQL 注入等多语言规则。规则匹配交给工程逻辑后,模型的注意力被约束在具体代码上,从源头去掉了信息噪音。
- 独立定位与反思模块:评论定位模块负责把意见锚到精确的行级位置,反思模块负责复核意见本身的内容准确性,两个模块独立于生成流程,系统性压低位置漂移和误报。
Agent 这一侧,只做动态决策:
- 场景调优的提示词:提示词模板为代码评审深度优化,官方称在提升效果的同时降低了 token 消耗。
- 场景调优的工具集:这不是拍脑袋裁剪。工具集从大规模生产环境的工具调用轨迹里蒸馏出来,分析维度包括每个工具的调用频率分布、单工具重复率、新增工具对整条调用链的影响,最终得到一套专用于评审场景、行为可预期的工具集,替代通用 Agent 的大而全工具箱。
这套设计的本质是把评审流程里的确定性环节收归工程逻辑:文件覆盖、规则匹配、位置锚定由代码保证,模型只在"这段代码有没有问题"这个它真正擅长的问题上发言。
上手:五分钟跑通第一次评审
Open Code Review 是 Go 编写的 CLI,通过 npm 分发,npm install -g 全平台可用,也提供安装脚本、GitHub Release 二进制和源码编译三种替代方式。前置要求只有 Git ≥ 2.41。
# 安装
npm install -g @alibaba-group/open-code-review

# 配置模型(交互式 UI,选 Provider、填 API Key,自动测连通)
ocr config provider
ocr config model

# 工作区模式:评审所有暂存、未暂存和未跟踪的变更
cd your-project
ocr review

# 分支对比:评审 feature 分支自 main 分叉以来的全部变更
ocr review --from main --to feature-branch

# 单个 commit
ocr review --commit abc123

# 全文件扫描:不依赖 git 历史,审计陌生代码库
ocr scan
ocr scan --path internal/agent

# 输出 JSON(供 CI 或上层 Agent 消费)
ocr review --format json --output result.json
对 AI 编程工具的重度用户,还有一条不用配 API Key 的路径:Delegation 模式。Open Code Review 只负责它最强的部分(文件选择和规则解析),把模型调用整个委托给你正在用的编码 Agent(Claude Code、Codex、Cursor 都有官方插件),评审由宿主 Agent 用自己的模型完成。项目同时提供 MCP Server 和便携 Skill 两种集成形态,CI/CD 集成覆盖 GitHub Actions、GitLab CI 和 Gerrit。
评审结果可以通过 Session Viewer 在浏览器里逐条回放,标记"已修复"或"忽略"后,工作区里对应的行内标注会自动隐藏。可观测性走 OpenTelemetry,接入自建监控没有额外成本。
为什么这件事值得关心
AI 编程工具正在从"生成代码"卷向"检查代码"。生成端有 Claude Code、Codex、Cursor 在贴身肉搏,评审端此前没有跑出同等量级的专门工具,团队的实际做法大多是拿通用 Agent 加一段评审提示词凑合。这份 benchmark 给出的结构性结论是:在代码评审这个垂直场景里,"专用架构 + 任意模型"的组合击败了"通用 Agent + 更强模型",而且差距悬殊(F1 翻倍、成本九分之一)。
这个结论如果被更多独立评测复现,影响会落到两个群体头上。对工程团队,代码评审进入 CI 的最大障碍是误报噪音和 token 账单,25.10% F1 配 1 分 23 秒的组合第一次让"每次合并自动全量评审"在成本上成立。对做垂直 AI 工具的开发者,这是一个可参考的架构模板:把覆盖率、定位精度这些硬指标交给确定性工程,让模型只回答它真正擅长的子问题。提示词层面的"请仔细检查每一个文件"解决不了覆盖率和位置漂移,工程结构可以。
基准数据的利益相关方属性意味着这些数字应当被当作"厂商基准"看待,但 AACR-Bench 数据集本身已经公开在 Hugging Face,第三方复核的门槛被降到了最低。架构思路的 validity 不依赖这份基准的绝对数值——确定性流水线管流程、模型管判断的分工,在任何需要稳定输出的 LLM 应用场景里都值得试。
来源
- GitHub 仓库 alibaba/open-code-review
- AACR-Bench 数据集(Hugging Face)
- 官网与文档 open-codereview.ai
- npm 包 @alibaba-group/open-code-review(v1.12.4,2026-09-16 发布)