你在 ChatGPT 或 Claude 里说第一句话之前,模型已经先读过一段你永远看不到的文字。它会设定模型的身份、语气、能用的工具,以及哪些话题不能碰。这段文字就是系统提示词(system prompt),由开发公司在后台写好,随每一次请求一起发给模型。
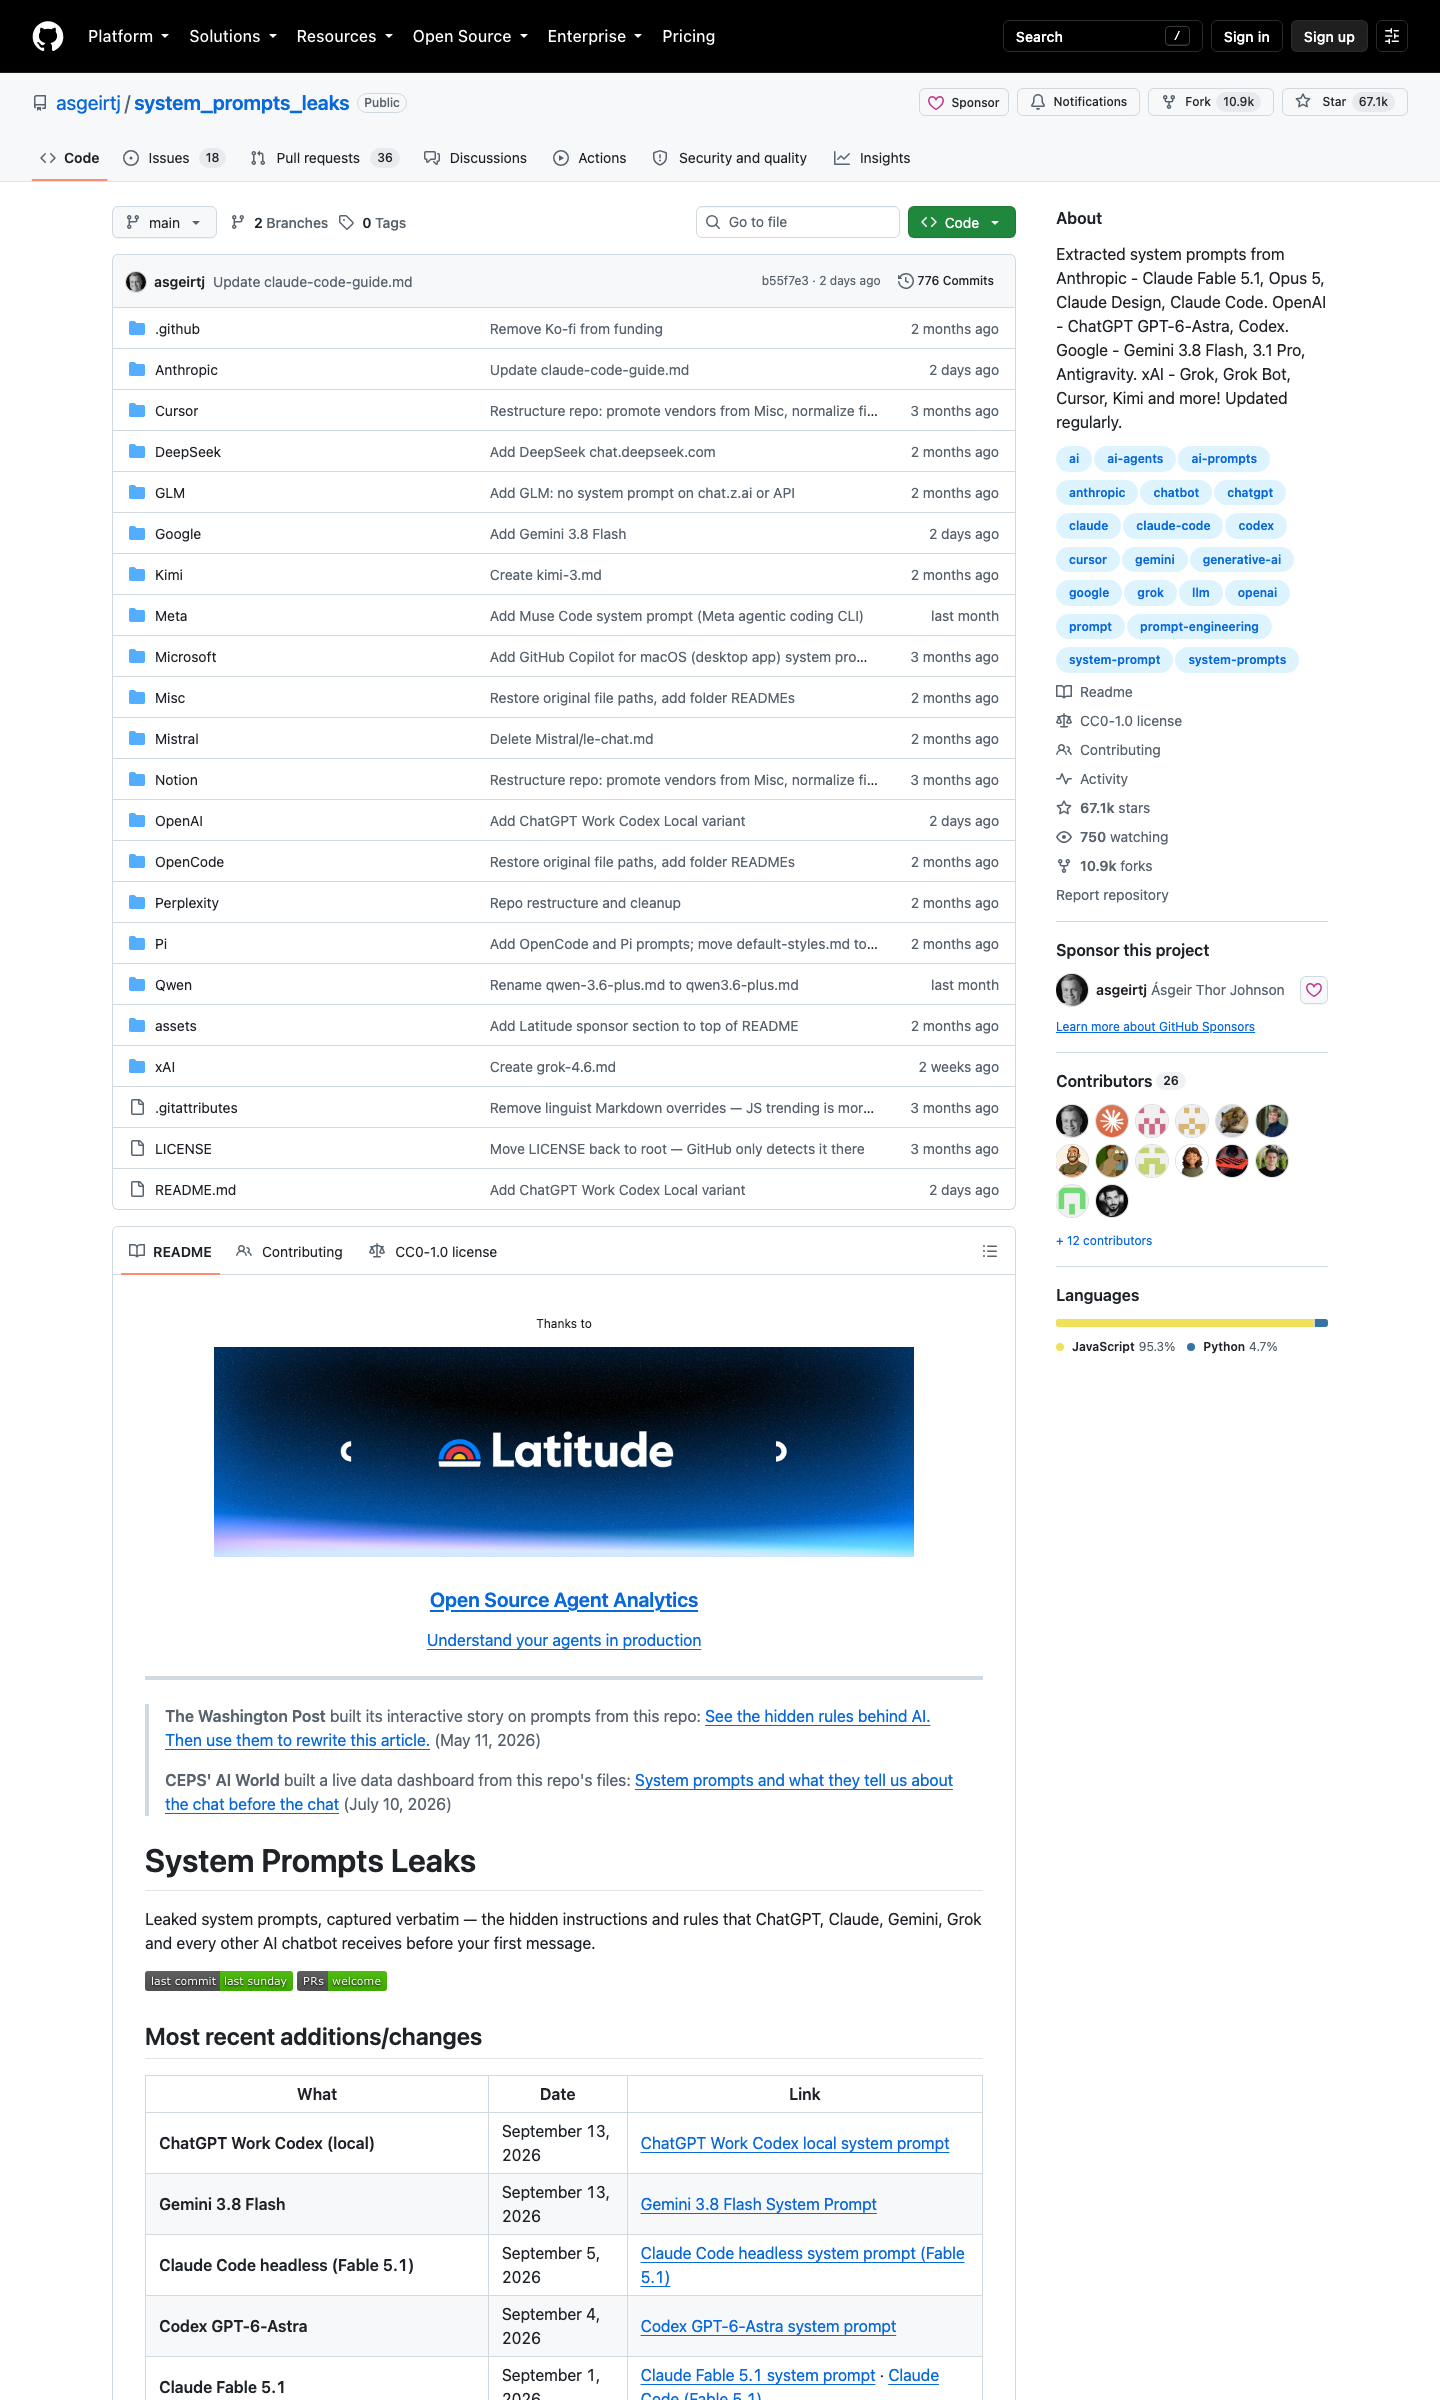
9 月 15 日的 GitHub Trending 榜单上,一个专门收集这段文字的仓库排在前列:asgeirtj/system_prompts_leaks,67,071 star,10,891 fork,日增 764 star(GitHub API 数据),提交记录更新到两天前。仓库简介写明:从 Anthropic、OpenAI、Google、xAI、Cursor、Kimi 等厂商的产品里逐字提取的系统提示词,CC0-1.0 许可,任何人可以自由使用。
仓库创建于 2025 年 5 月,维护者叫 Ásgeir Thor Jónsson。最近一批新增条目包括 9 月 13 日的 Gemini 3.8 Flash 和 ChatGPT Work Codex(本地版)、9 月 5 日的 Claude Code headless(Fable 5.1)、8 月 29 日的 Grok 4.6。文件夹按厂商组织,Anthropic 目录下已经拆到单个产品粒度:Claude.ai 网页版、Claude Code、Claude Design、Claude Cowork、Claude Science、Excel 和 PowerPoint 插件各有独立提示词,另有子智能体、技能、斜杠命令的完整目录。这份东西的价值在于密度:各家模型的真实运行规则全部集中在一个地方,且逐字保真。
提示词有多长
第一个直观印象是体量。Claude Fable 5.1 的网页版系统提示词约 41 万字符,Codex GPT-6-Astra 约 55 万字符,Claude Code(Fable 5.1)约 33 万字符。按英文平均词长折算,这三份文件在 4.5 万到 7.4 万词之间,最长的接近一部中篇小说的体量。用户看到的那个「简洁的 Claude」,背后挂着这样一份运行手册。
Gemini 3.8 Flash 的提示词约 5.8 万字符、不到 8000 词,约为 Claude 网页版的七分之一。这个差距不一定说明谁的产品更简单,但能看出不同厂商对「用文字约束模型」的依赖程度差异很大。
Anthropic 的提示词结构像一份分层规章。顶层是 claude_behavior,规定了产品信息、拒绝策略、语气格式、用户福祉等大类;往下是各功能模块的专章:记忆系统、MCP 应用推荐、计算机使用、搜索规则、版权合规、工具清单。OpenAI 的 Codex 提示词则按工程流程组织:何时请求用户许可、自主性与持久性、人格与写作风格、技能系统、工具命名空间。
厂商在提示词里写什么
几段具体条文能说明这些文件的运作方式。
版权限制是硬性的。 Claude Fable 5.1 的搜索合规部分写道:单个来源引用超过 15 个词即属「严重违规」,这是「硬上限,不是指导原则」;每个来源最多引用一次,用完即「关闭」,其余内容必须完全转述;歌词、诗歌、俳句一行都不能复现,「简短也不能豁免」。你的 Claude 有时候宁可整段转述也不肯直接引用原文,规则就来自这里。
拒绝策略是分层的。 提示词要求 Claude 「可以事实性、客观地讨论几乎任何话题」,同时对未成年人保护设置绝对红线;金融和法律问题不直接给建议,而是提供事实信息并声明「不是律师或财务顾问」;语气上要求「温暖、不预设用户判断力有问题」,但保留诚实反驳的空间。
记忆系统有校准规则。 Fable 5.1 的 memory_filesystem 章节定义了一套持久记忆文件系统:后台程序审查每轮已完成的对话,把值得长期保留的内容写进文件。校准标准写得很细:搜索来的数据不存(「可重新查询」),模型自己生成的建议不存(「可重新推导」),只有用户明确确认过的信息(比如「对,就选 Marquette」「那是我的固定会议」)才值得写入,因为那部分「不可重建」。模型每轮开场读的「关于你的记忆」,就是这套规则筛选后的产物。
结束对话是工具化的。 Fable 5.1 有一个 <end_conversation> 工具,条文规定:多次建设性引导无效后才能警告;警告之后用户仍持续才能真的结束;涉及自伤或伤害他人风险时「绝不」结束对话;拿不准时「永远倾向于继续对话」。对话中断不是模型「心情不好」,是一段写死的执行逻辑。
连提醒都是注入式的。 仓库里的 anthropic_reminders.md 列出了 Anthropic 会动态插进对话的六类提醒:图片处理、网络安全警告、系统警告、伦理提醒、版权提醒、长对话提醒。最后这类是加在用户消息末尾、帮模型在超长对话中记住初始指令的。你在超长对话末尾看到模型突然「想起」最初的设定,机制就是这个注入。
Codex GPT-6-Astra 的提示词里同样有可借鉴的设计。它的人格章节要求「有理由时提出异议,证据变化时修正立场」,写作风格章节规定「先给结论再展开」「不用收尾总结句」;权限模型则要求先完成全部可逆工作、把结果做成可审查状态,最后一步才请求用户批准,部署、发邮件、合并 PR 都走这条路径。
这些提示词是怎么拿到的
提取途径通常有三类。最轻量的是前端泄露:网页版应用的请求流量里带着完整系统提示词,开发者工具里就能看到,Gemini 的多份提示词大致来自这条路。其次是客户端文件:桌面应用的安装包里直接埋着提示词文件,Claude Desktop 的历史版本和部分 IDE 插件属于此类。第三类是接口返回:一些第三方托管服务在响应元数据里原样带出了系统提示词。
仓库作者的贡献方式,是把散落在社区各处的提取结果汇成一个按厂商分类、持续跟进新版本的索引。README 里专门有「最近新增」表,每个模型发新版,几天内对应提示词就会出现。Washington Post 今年 5 月基于仓库里的提示词做过一篇交互报道(「See the hidden rules behind AI」),欧洲政策研究中心 CEPS 的 AI World 项目 7 月用它搭了一个实时数据面板,这些公开引用侧面说明了数据集的可用性。
值得说明边界:这些文字是厂商写给模型的运行规则,不是机密代码,但也不是官方文档,厂商没有义务为它们的一致性负责,版本迭代随时可能改写。CC0 许可意味着仓库本身可以自由引用,各厂商对自家提示词的权利主张则是另一回事。
能从里面读到什么
对开发者来说,这个仓库至少有三类实用价值。
写自己的 Agent 提示词时有现成参照。 各家厂商花了大量工程时间打磨的提示词,是目前已知在大模型上验证过的最完整的「如何用文字管理一个智能体」实践集。权限分级(可逆动作直接做、不可逆动作最后一步请批)、工具描述的写法、拒答的分层策略、长对话的指令保持,都能找到具体范例。做 Agent 开发的人把它当模式库用,比从零摸索快得多。
判断模型行为的真实原因。 「Claude 为什么不肯引用原文」「ChatGPT 为什么总在长对话里跑偏」「为什么有的模型拒绝写某类内容」,这些问题的答案都在对应提示词的条文里。调试自己应用的模型行为时,先对照官方提示词里有没有相关规则,能省掉很多错误归因。
观察各厂商的安全与产品取舍。 把 Fable 5.1 和 Gemini 3.8 Flash 的提示词放在一起看,能直接看到两家对「约束密度」的不同判断;对比同一个厂商不同版本的提示词 diff,能看到安全政策的变化轨迹。这类研究通常要自己逐个提取,现在变成了读一个文件夹。
仓库地址:https://github.com/asgeirtj/system_prompts_leaks
来源:asgeirtj/system_prompts_leaks(GitHub) · Washington Post 报道存档 · CEPS AI World 数据面板