一个半年没有发过新版本的 AI 项目,正在 GitHub 上以每天五百多颗 star 的速度重新冲榜。9 月 15 日的 GitHub Trending 榜单上,666ghj/MiroFish 排在第五位,日增 524 star,总星数 72,964,fork 数 11,276(GitHub API 数据)。这个名叫 MiroFish 的开源项目,定位是「群体智能引擎」:用一大群由大模型驱动的智能体搭建一个平行数字世界,让它们在里面讨论、博弈,然后产出一份对现实事件的推演报告。
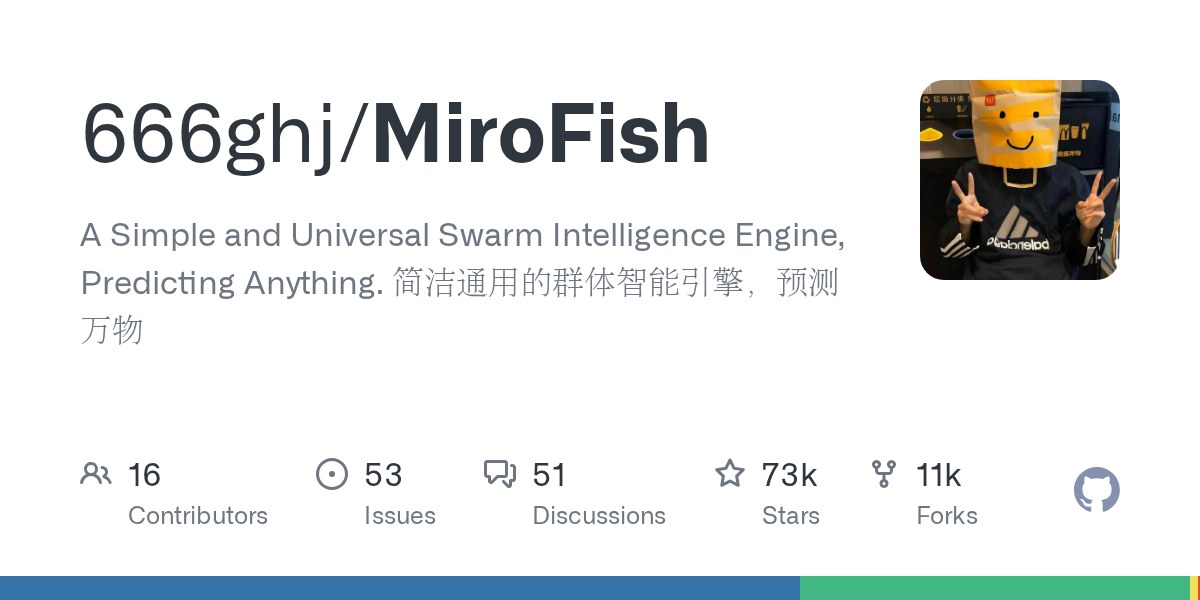
项目背后有盛大集团的孵化投入,据钛媒体 2026 年 3 月报道,盛大创始人陈天桥为它投了 3000 万元。开发者是北京邮电大学大四学生郭航江(网名 BaiFu),他的前作 BettaFish(多智能体舆情分析助手)在 2025 年底登上过 GitHub 热榜第一,MiroFish 则在 2026 年 3 月 7 日登顶 GitHub 全球趋势榜。半年过去,这个项目没有沉下去,反而在 9 月中旬拿到了单日 +524 的增速——这份数据值得把它的架构、工程现状和使用成本拆开看一遍。
五步,造出一个平行世界
MiroFish 的工作方式在 README 里写得很清楚,整条流水线分五步:
- 图谱构建:用户上传「种子材料」,可以是一份数据分析报告,也可以是一部小说。系统解析出关键实体与关系,用 GraphRAG(一种把知识组织成图谱、再供大模型检索的技术)构建动态知识图谱,并给智能体注入个体与群体的初始记忆。
- 环境搭建:基于图谱自动抽取实体关系,生成带有不同立场与背景的智能体人设,由环境配置 Agent 注入仿真参数。
- 模拟运行:启动双平台并行模拟,让数十到上百个智能体在两个独立的模拟环境中就同一议题展开讨论与博弈,系统自动解析预测需求,并动态更新所有智能体的时序记忆。
- 报告生成:模拟结束后,专属的 ReportAgent 用工具集与模拟后的环境深度交互,综合所有智能体的行动与演化结果,生成结构化的预测报告。
- 深度交互:报告不是终点,用户可以继续和模拟世界里的任意一个智能体对话,追问它为什么这样决策。
官方演示给了两个具体案例:一个是让智能体群体基于《红楼梦》前八十回的数十万字文本,推演失传的后四十回走向;另一个是用 BettaFish 生成的武汉大学舆情报告做种子,模拟舆情演化过程。两个案例的完整视频都发布在官方 B 站账号,项目还提供了在线 demo(666ghj.github.io/mirofish-demo)。
引擎底座与记忆系统
MiroFish 的模拟引擎不是从零写的。README 致谢栏写明,仿真层基于 CAMEL-AI 团队开源的 OASIS(Open Agent Social Interaction Simulations)。OASIS 是一个社交媒体模拟器,按其论文(arXiv:2411.11581)的说法,支持最多一百万个智能体在同一环境中互动,用于研究信息传播、群体极化这类大规模社会动态。MiroFish 在它之上做了三层封装:
- GraphRAG 图谱层:把非结构化的种子材料转成实体关系图谱,这是后续生成人设和注入记忆的数据基础。2026 年 7 月的提交记录里,有多次针对 ontology(本体结构)JSON 生成和校验的加固修复,说明这一层在实际运行中踩过不少坑。
- 记忆层:项目接入了 Zep 云服务来管理智能体的长期记忆与时序更新。Zep 是一个专门给 AI Agent 提供记忆存储的商用服务,MiroFish 的部署配置里 ZEP_API_KEY 是必填项。7 月下旬的提交集中处理了 Zep 超时、实体上下文校验等问题,等于把第三方依赖的边界摸了一遍。
- 报告层:ReportAgent 在模拟结束后还能调用工具回查模拟环境,而不是只靠模型对对话记录做总结,这让报告可以引用模拟过程中的具体状态。
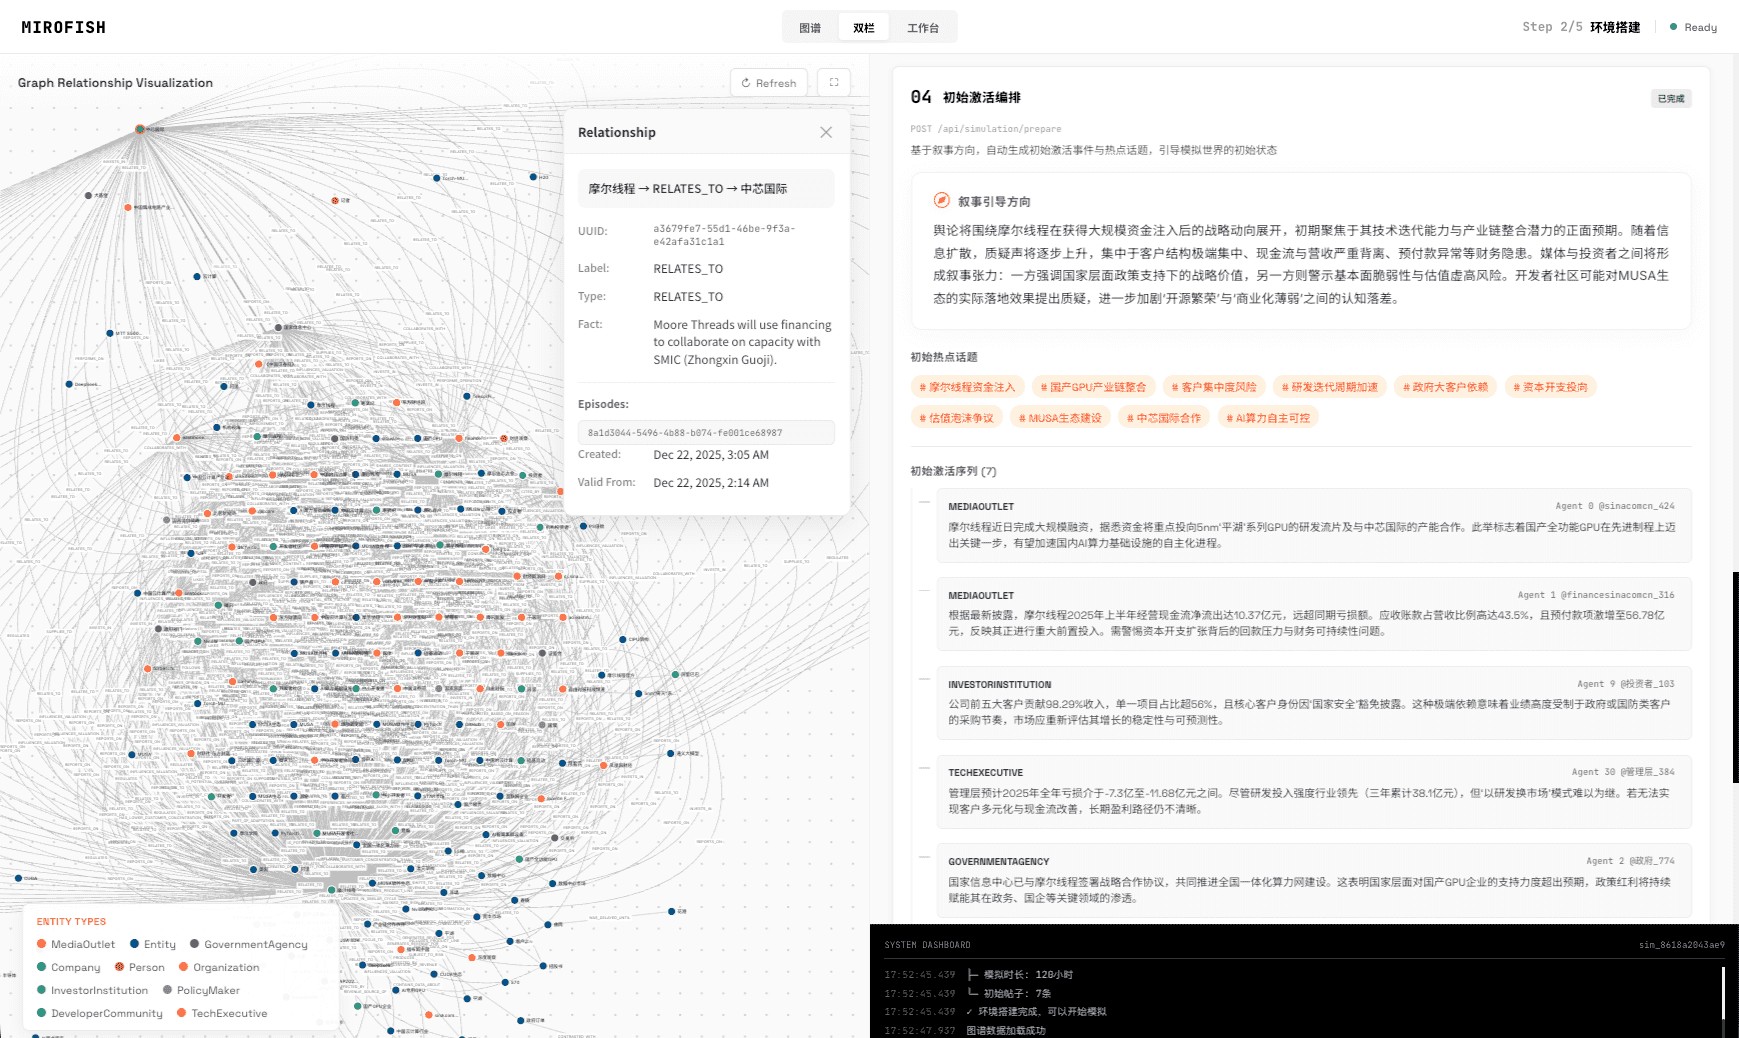
从截图里能直观看到这套系统的形态:左侧是以图谱形式铺开的上百个智能体及其关系边,右侧是每个智能体的角色档案(媒体机构、投资机构、政府部门、科技高管等),每条档案都标注了对应的 Agent 编号和参数量配置。
跑一次要准备什么
部署路径有两条:源码部署(Node.js 18+、Python 3.11 至 3.12、uv 包管理器,npm run setup:all 一键装依赖)或者 Docker(docker compose up -d,映射前端 3000、后端 5001 两个端口)。
真正的门槛在两把 API 钥匙上:
- LLM_API_KEY:模型调用走 OpenAI SDK 兼容格式,README 默认推荐阿里百炼平台的 qwen-plus。注意 README 里有一句成本警告原文:「High consumption, try simulations with fewer than 40 rounds first」——先从 40 轮以内的模拟试起,因为消耗很高。上百个智能体每人每轮都要过一遍大模型,token 消耗是乘法关系。
- ZEP_API_KEY:记忆服务的钥匙,Zep 云的免费月额度对轻度使用够用,重度模拟需要付费。
这套配置决定了它的实际使用成本结构:软件本身开源免费,但每一次推演都在烧模型 token。对个人用户体验新奇的推演(比如推一本小说的结局),成本可控;如果想让模拟规模上到几百个智能体、跑几十轮,账单会明显上来。
半年没有新版本,这意味着什么
9 月 15 日用 GitHub API 拉了一遍这个仓库的工程数据,有几个数字放在一起看很有信息量:
- 版本停在 3 月。仓库只有三个 tag:v0.1.0(2026 年 1 月 22 日)、v0.1.1、v0.1.2(2026 年 3 月 5 日)。此后七个多月没有再打过版本号。
- 提交节奏波动很大。最近 100 个提交(时间跨度 3 月 20 日至 8 月中旬)按月分布是:3 月 2 个、4 月 42 个、5 月 6 个、7 月 46 个、8 月 4 个,6 月为 0。4 月和 7 月是两个开发高峰,其余月份接近静默。9 月唯一一次提交是机器人自动更新 star 历史。
- 贡献高度集中。全部 307 次贡献记录里,作者 666ghj 一人占 266 次(约 87%),第二名的 Ghostubborn 贡献 34 次,其余贡献者合计不到 10 次。
这组数字刻画的是一个仍在「创始人驱动」阶段的项目:核心能力已经跑通、官方 demo 在线可用、券商金融工程团队(国联民生 3 月发布过 MiroFish 实测专题报告)已经开始拿它做宏观与行业趋势推演的测试;但工程上它还没有形成稳定发布节奏,8 月以来代码近乎停更,与 star 曲线的陡峭上行形成了明显反差。README 里同时挂着团队招聘信息([email protected],全职与实习),盛大注资之后,把原型推成产品大概率是接下来的主线。
对想要引入它的团队来说,这组数据的含义很清楚:可以把 MiroFish 当作能力验证和二次开发的底座(引擎是开源的,OASIS 本身也是独立项目),但不适合把它当作有长期版本承诺的生产级依赖。
仿真推演能当预测用吗
MiroFish 把「预测」这个词写进了 slogan(Predicting Anything),但它的机制决定了输出和真实预测之间有一段距离。整个推演的前提是:智能体的人设由大模型从种子材料里生成,它们的行为逻辑也是大模型在扮演。所以更准确的描述是——它推演的是「如果一群这样设定的人处在这样的信息环境里,舆论会怎么走」,而不是「真实人群会怎么走」。种子材料的立场和质量、人设分布的设定,都会系统性影响结果。
这不是贬义。作为一种决策预演工具,它的价值在于把一个议题的不同立场快速铺开、让对抗性观点在沙盘里先行碰撞,相当于给政策、公关、产品决策做一个低成本的沙盘推演。官方把它定位成「决策者的预演实验室」和「个人用户的创意沙盘」,前者对应舆情与政策模拟,后者对应小说推演这类娱乐场景。从官方 demo 的成熟度看,舆情模拟是当前最完整的场景,金融与政治预测在 README 里还挂在「coming soon」。
用大模型做多智能体社会仿真,OASIS 论文里已经验证过信息传播和群体极化的复现能力,MiroFish 把这条路线做成了带界面的完整产品。它能不能从「数字沙盘」长成真正的「决策外脑」,取决于接下来半年团队是否能补上工程化这一课——版本节奏和贡献者结构是目前观察这两个问题的最直接窗口。
仓库地址:github.com/666ghj/MiroFish,在线 demo:666ghj.github.io/mirofish-demo。
来源:MiroFish GitHub README 与仓库 API 数据(2026-09-15);钛媒体《陈天桥投的AI产品登顶Github,中国00后小孩哥开发》(2026-03-09);OASIS 论文 arXiv:2411.11581;国联民生金工《MiroFish实测:多智能体宏观与行业趋势推演》(2026-03-24)。