2026 年 9 月 11 日,一个账号名为 Chetaslua 的开发者发出了自己过去几天的作品:把果蝇全脑仿真的神经活动接进 ChatGPT。果蝇「说」出的第一句话是一个问题:
"i smell vinegar and yeast. i taste sugar. it is warm and bright. what should i do?" (我闻到醋和酵母的味道,尝到了糖,这里又暖又亮,我该做什么?)
这条帖子在 X 上拿到 1330 个赞,中文科技圈的转述帖又添了 336 个赞,36 氪今天把它排上了热榜。演示视频里有一个可以复核的硬数字:给仿真脑糖味输入,负责进食动作的 MN9 运动神经元发放率冲到约 78 Hz;混入苦味,这个数字掉到约 3 Hz。方向与生物学文献一致。
一个必须先说清的事实边界:这不是把某只活果蝇的脑子泡在培养液里插电极,视频里的「果蝇」是纯数字仿真,它的「语言」由大语言模型代为翻译。这场演示真正第一次做到的事情,是给一颗按真实连接组搭建的仿真大脑,装上了一个语言接口。
底座:一张开源的果蝇大脑接线图
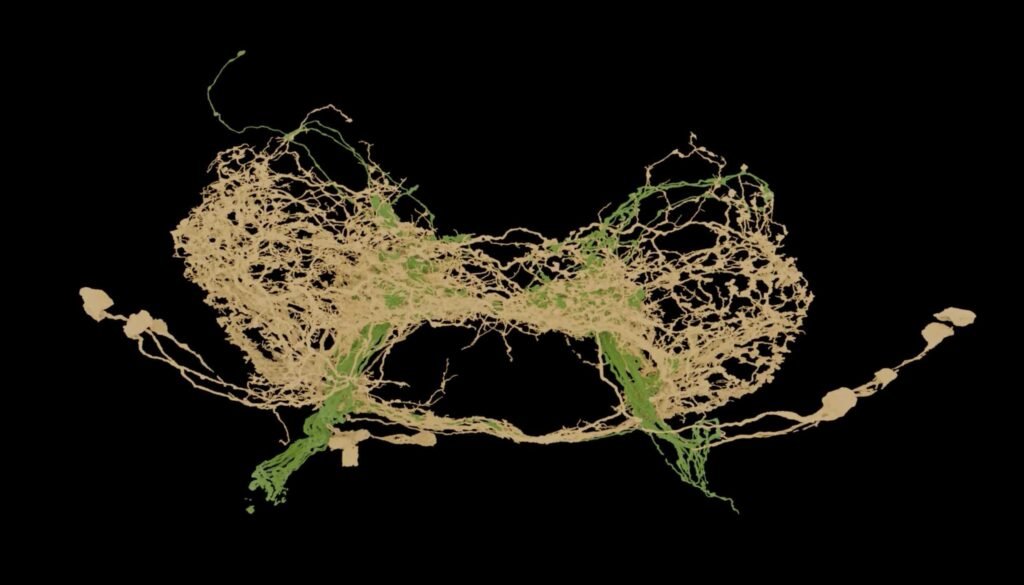
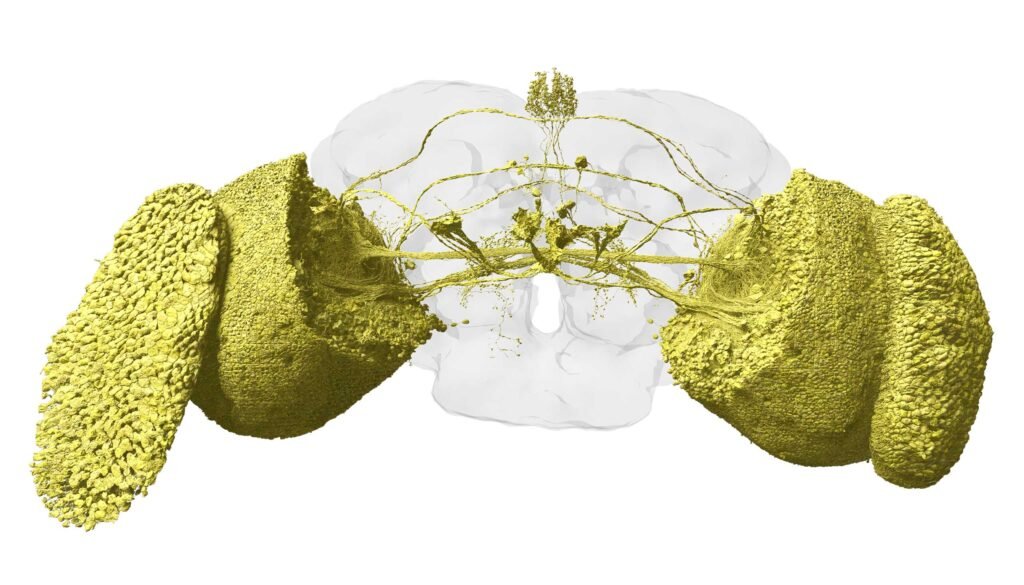
要让仿真「按真实连接组搭建」,前提是果蝇大脑的完整接线图存在且公开。这个前提在 2024 年就已成立:FlyWire 联盟完成了成年果蝇(雌性)全脑连接组,139,255 个神经元、约 5000 万个突触连接,每一个都经过人工校对,数据全部公开。
有了接线图,UC Berkeley 的博士后 Phil Shiu 做了下一步:把整张图变成一个能跑的仿真模型。2024 年 10 月,这项工作以《A Drosophila computational brain model reveals connection between brain and behavior》为题发表在 Nature 上。模型用漏电积分发放(Leaky Integrate-and-Fire,LIF)神经元搭建,每个神经元只保留「积累输入、超过阈值就发放脉冲、随后泄漏回落」的动力学骨架,全脑 13.9 万个单元在一台笔记本电脑上就能跑。
LIF 模型丢弃了离子通道的生化细节,预测力却出乎意料。按 Berkeley 官方报道的描述,研究团队给仿真脑注入糖味刺激,模型预测出的神经元激活序列与真实果蝇脑中记录到的一致;激活触角上的感官神经元,模型预测出果蝇会用腿清洁触角——正是真实果蝇身上观察到的行为。味觉、清洁、运动三类行为的预测,后来都在真实果蝇上得到了验证。
模型同样开源:philshiu/Drosophila_brain_model 仓库里,pip 装好依赖即可在本地跑一颗果蝇大脑。Chetaslua 的演示正是建立在这类开源实现之上——这是「Chetaslua 们」能在一周内做出语言接口的前提。
语言接口怎么接
从接口工程的角度看,过去两周围绕这张图谱出现过三种「外设」,复杂度依次递进:
| 接口形态 | 时间 | 做的事情 |
|---|---|---|
| Minecraft 运动接口 | 9 月 5 日 | 神经活动驱动虚拟身体在游戏里飞行 |
| 浏览器仿真 | 持续更新 | 全脑仿真直接在网页里运行 |
| 语言接口 | 9 月 9-11 日 | 神经活动经 LLM 翻译成第一人称文本 |
语言接口的做法可以从推文内容反推。MN9 神经元的发放率是被实时读出的生理信号,糖让它加速、苦味让它几乎停摆,这与 Shiu 模型味觉通路的预测方向一致。这些状态经程序转换成感官描述(闻到醋和酵母、尝到糖、温暖明亮),交给大语言模型,LLM 以第一人称应答——于是有了开头那句提问。原帖还自述了测试方式:用一个 16 个词的感官状态集做输入,LLM 应答对「留出词」(held-out,即校准时没见过的词)的覆盖是 100%。
这些数字的来历要交代清楚:78 Hz 与 3 Hz 是演示视频里的读数,方向与论文一致这个判断来自作者本人;「16 个词、100% 留出覆盖」同样是作者自述的测试方式,代码尚未发布,第三方复现还无从谈起。这类演示的可靠性与作者的诚实度直接挂钩——把它当工程演示看有据可依,当成已同行评审的科学结论则为时尚早。
三周前 Evan Smith 把这张图谱搬进 Minecraft 时(本站曾介绍),全脑仿真的门槛已经降到个人项目级别;这次语言接口更进一步,「观察一颗仿真脑」变成了「和一颗仿真脑对话」。两者共用同一份数据底座,变化发生在接口层:运动接口把神经输出翻译成物理动作,语言接口把神经状态翻译成可读文本。
工具还是修辞
必须把话说得保守:这不是「果蝇学会了说话」。果蝇脑在这套系统里承担的角色是传感器和状态机——它的 13.9 万个 LIF 神经元产生真实的动力学,读出的发放率忠于连接组;但语法、语义和那句提问的措辞,全部来自大语言模型的先验。更像一个准确的类比:果蝇脑是仪表盘,LLM 是替它说话的翻译。一个只会读仪表盘的翻译当然可能过度阐释,这也是所有「神经活动转文本」工作共有的解释边界。
不过对严肃用途而言,这个演示恰好处于「有趣」和「可用」的交界。神经科学实验里,要判断一个脑环路处于什么状态,研究者盯的是钙成像影像和发放率曲线,读懂数据需要专业训练。把发放率实时翻译成自然语言描述,等于给仿真实验加了一层「仪表盘语音播报」:实验室外的人也能第一时间判断糖味通路是否按预期响应。快速排查「这次刺激到底有没有生效」,这个需求是真实存在的。
更实际的科研用途可以再往前推一步。Shiu 在 Berkeley 的报道里说过,这类模型的价值在于把湿实验的验证周期前置:先在仿真里「切断」一条连接,看行为预测怎么变,筛出值得做真实实验的猜想。如果切断的是抑制性通路,果蝇的味觉反应理应失控放大——连接组的癫痫样失抑制正是 Shiu 团队建模过的现象(他们靠更仔细的校对才消除了模型里的自发癫痫)。语言接口让这种快速试错多了一层旁观的眼睛,尽管这层眼睛的可靠性还需要系统评估。
大脑高清化之后
果蝇不是这条路的终点。Shiu 本人对下一步的表述写在 Berkeley 报道的引语里:下一个目标是小鼠连接组,最终是人类大脑的接线矩阵。他的判断是,这类「真实神经网络」模型提供了一条不同于大语言模型主流路线的 AI 路径。
当下的进度条:果蝇全脑连接组已完成(2024,FlyWire;2026 年雄性版本 MaleCNS 也已发表于 Cell),小鼠连接组是各家实验室正在攻坚的方向,人类还远。但语言接口演示的意义在于展示了连接组数据池的另一种消费方式——不再是只有论文、数据库和游戏模组能消费它,任何能读 API 的程序都可以。生态侧已经有人在做整理:cobanov/awesome-fly 仓库持续收录果蝇连接组的衍生项目,从 Doom 移植、桌面宠物到全脑模型和机器人身体。
给一颗真实布线的大脑装上语言接口,这个方向的第一步已经迈出。下一步是谁、给哪颗大脑装、翻译得多准,都还是开放问题。连接组还在继续高清化,接口只会越来越多。